MacでローカルLLMは動く?必要なメモリとおすすめのMac・RTXとの費用比較【2026年】
自分のMacでAIを動かす「ローカルLLM」を試したいと思っても、M5 MaxやM5 Ultra搭載のMac Studioは高額です。
一方、Windows側の有力候補であるRTX 5090は品薄が続き、購入画面の前で手が止まります。
50万円前後の予算では、Macのまま試すか、RTX機を足すか、思い切ってMac Studioを買うかが悩みどころです。
今のMacで試せる範囲から、予算50万円前後でのMacとRTX機の比較、大きなモデル向けのMac Studio M5 Ultraまで順番に解説します。
この記事は、Apple・MLX・Ollama・LM Studio・Strata公式GitHubと各メーカー公式サイトの情報をベースに、当サイトの実測を加えてまとめています。
公式情報の確認時点は2026年10月17日です。
- いまのMac(M1以降)でも、メモリの量次第で小型〜中型モデルは試せます
- 予算50万円前後なら、VRAM16GBのRTX機(RTX 5070 Ti・RTX 5080)を足すか、Mac Studio M5 Max 64GBを選ぶかが現実的な比較になります
- Mac Studio M5 Ultra(256GB構成)の出荷は15〜17週間(2026年10月17日時点)。先に決済し、後から届く売り方です
- 開発元の計測と当サイトの実測は条件が違うため、数値は分けて読みます
結論:予算で選ぶ — Macのままでいい人・RTX機を足す人・Mac Studioを狙う人【2026年】
- 選ぶ道は、Macのまま試す・RTX機を足す・Mac Studioを狙うの3つ
- どの道でも、動かせるモデルの大きさを決めるのはメモリの量
- 予算と、答えを待てる時間の長さで選ぶ道が変わる
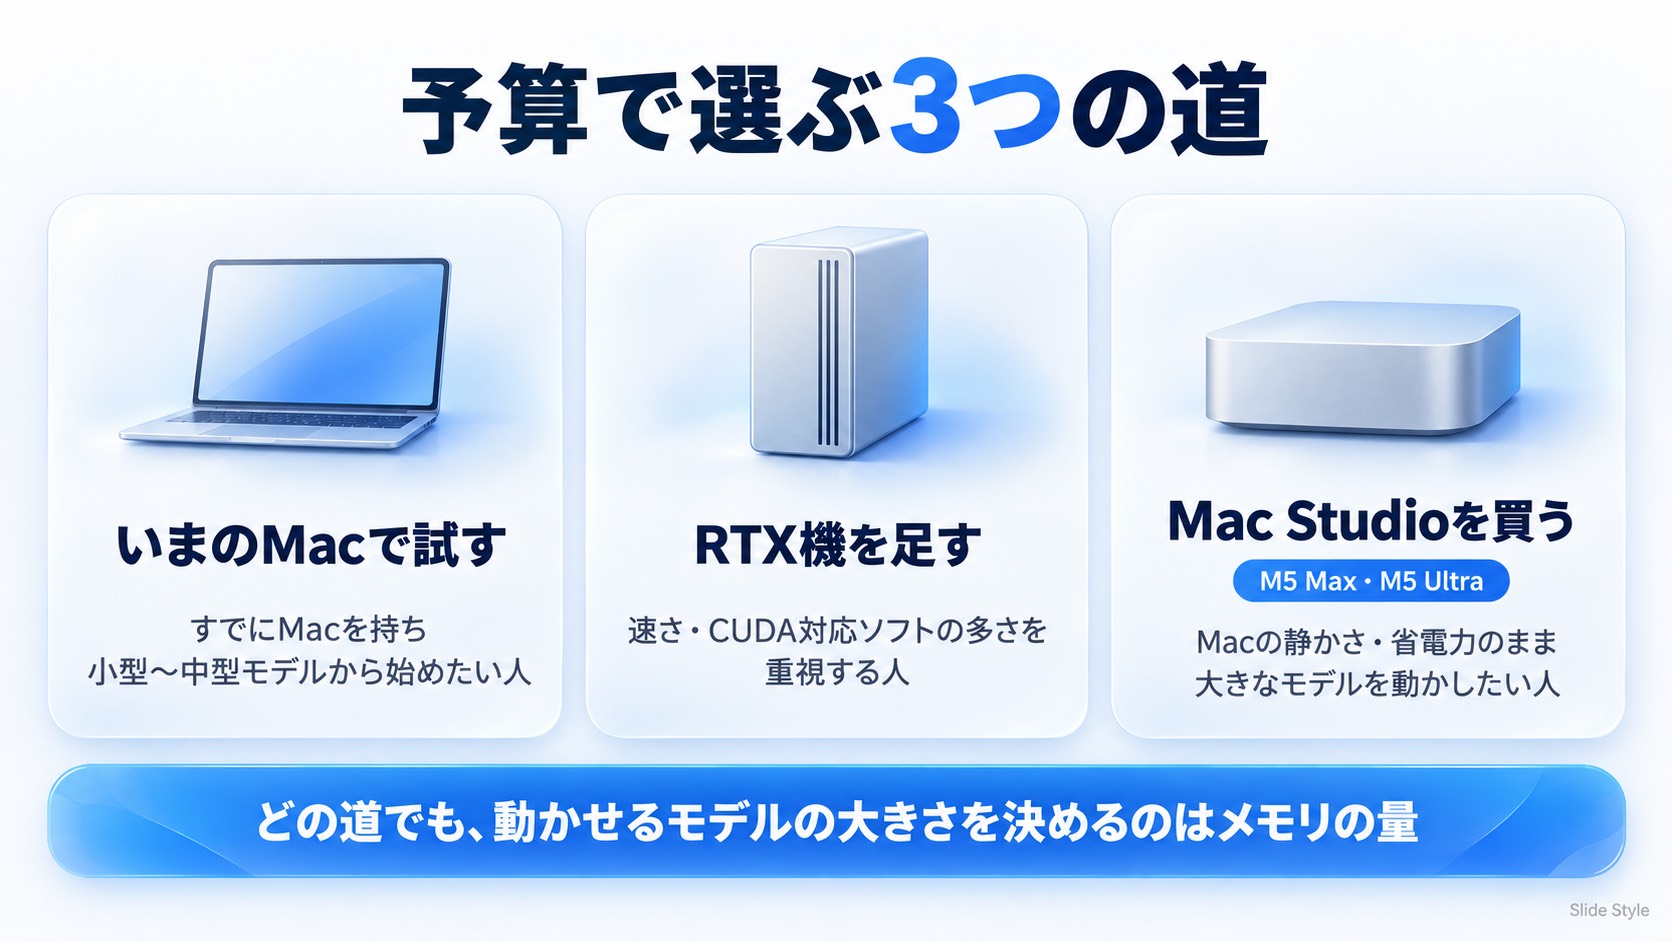
選び方の軸は3つです。
いまのMacをそのまま使うか、予算50万円前後でRTX機を足すか、大きなモデルのためにMac Studioを新しく買うかです。
どの道を選ぶかで、おすすめの人と目安の価格が変わります。
| 選択肢 | おすすめの人 | 目安の価格 (2026年10月17日時点) | 詳細を記載した見出し |
| いまのMacで試す | すでにMacを持ち、小型〜中型モデルから始めたい人 | 追加費用なし | いまのMacのメモリを確かめる |
| 50万円前後で RTX機を足す | 速さ・CUDA対応ソフトの多さを重視する人 | 384,800円〜489,800円程度(VRAM16GBのRTX 5070 Ti・RTX 5080機) | 予算50万円前後でできること |
| Mac Studioを買う (M5 Max・M5 Ultra) | Macの静かさ・省電力のまま大きなモデルを動かしたい人。 より大きなモデルならM5 Ultra | M5 Max 128GB・1TBは941,800円から M5 Ultraは949,800円から(256GB構成は1,903,800円) | Macのまま狙うなら 大きなモデルならMac Studio M5 Ultra |
RTX機を足す場合、HP HyperX OMEN 35Lが429,800円からです(2026年10月17日時点の税込価格)。
詳しくは以下の項目で解説しています。
どの道を選んでも、動かせるモデルの大きさを決めるのはメモリの量です。
次の節で、MacでローカルLLMが動く仕組みを順番に見ていきます。
MacでローカルLLMが動く仕組み
- Macは、CPUとGPUが1つの大きな机を一緒に使う「統合メモリ」という作り
- 机(メモリ)の広さと、机の上の本を読み取る速さ(帯域)の両方が答えの速さを決める
- LM Studioの中身は、MLXとllama.cppという2つの仕組み
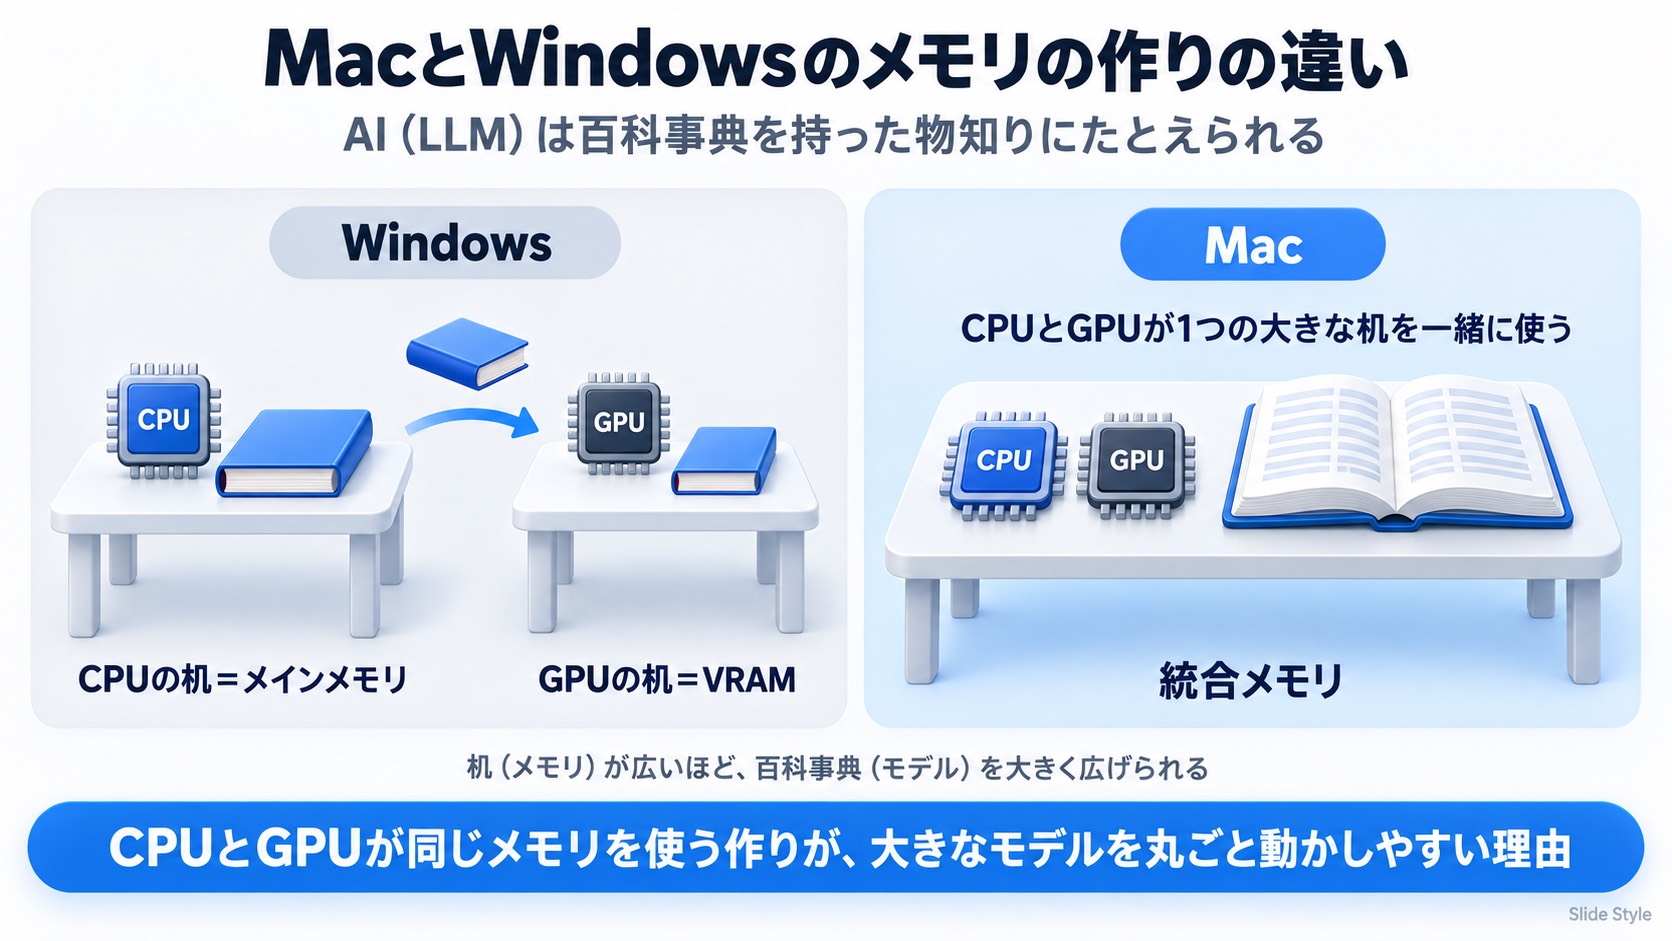
AI(LLM)は、分厚い百科事典を持った物知りの人にたとえられます。
AIが答えを書くには、百科事典を広げる机(メモリ)と、机に広げた本を読み取る速さ(メモリ帯域)が要ります。
百科事典にあたるのが、AIが学習した情報をまとめた「モデル」で、ふだんは本棚(SSD)にしまってあります。
WindowsのPCでは、GPUが使う机(GPU専用メモリ=VRAM)と、CPUが使う机(メインメモリ)が別々にあります。
Macは、CPUとGPUが1つの大きな机を一緒に使う「統合メモリ」という作りです。
統合メモリ
統合メモリでは、CPUとGPUが同じメモリ領域を読み書きします。
WindowsのPCのように、GPU用の机へ本を写し直す手間がなく、大きなモデルも1つの机にそのまま広げられます。
CPUとGPUが同じメモリを使う作りが、大きなモデルを丸ごと動かしやすい理由です。
帯域
机の広さと同じくらい大事なのが、机の上の本を読み取る速さにあたるメモリ帯域です。
帯域が広いほど、AIは1秒に多くの文字を書けます。
Appleのチップごとの帯域は、公式仕様では次の通りです。
- M5:153GB/s
- M5 Pro:307GB/s
- M5 Max:460GB/s(32コアGPU構成)・614GB/s(40コアGPU構成)
- M5 Ultra:1.2TB/s
- M6:153GB/s(16GB構成)・170GB/s(24GB・32GB構成)
同じ64GBのメモリでも、Mac mini M5 Pro(307GB/s)とMac Studio M5 Max 40コアGPU構成(614GB/s)では帯域が2倍違い、答えを書く速さが変わります。
メモリの量だけでなく、帯域も合わせて見るのがポイントです。
MLX
Mac向けのローカルLLMアプリ、LM Studioは、計算を担う仕組みとしてMLXとllama.cppを使っています。
MLXはMacで推論や学習の計算を行う仕組みで、複数のMacで計算を分け合う機能も持っています(後半の「512GBを待てないなら:Mac Studioを2台つなぐ」で説明します)。
Ollamaは、macOS Sonoma(14)以降のMacで動きます。
Apple Mシリーズは、CPUとGPUの両方を計算に使えます。
Intel(x86)のMacは、CPUだけの対応です。
モデルによって数十〜数百GBの空き容量が要ります。
LM Studioは、macOS 14.0以上のApple シリコン搭載Mac(公式ページの対応チップの表記はM1・M2・M3・M4)で動き、メモリは16GB以上を推奨しています。
8GBのMacでは、小さいモデルと短い文脈に限られると公式に案内されています。
M1以降のMacなら、OllamaとLM Studioのどちらも動きます。
快適に使えるかどうかを分けるのは、チップの世代よりもメモリの量です。
いまのMacで試すならメモリを確かめる
- 動くかどうかは、まずメモリの量で決まる
- 16GBは小型モデルが中心、64GB以上で大きなモデルも視野に入る
- インストール手順の細部より、まず空き容量と動作条件を確かめる
メモリ別にできること
Macのメモリ(統合メモリ)は、あとから増やせません。
買う前、または今持っているMacで試す前に、メモリの量でできることの目安を確かめます。
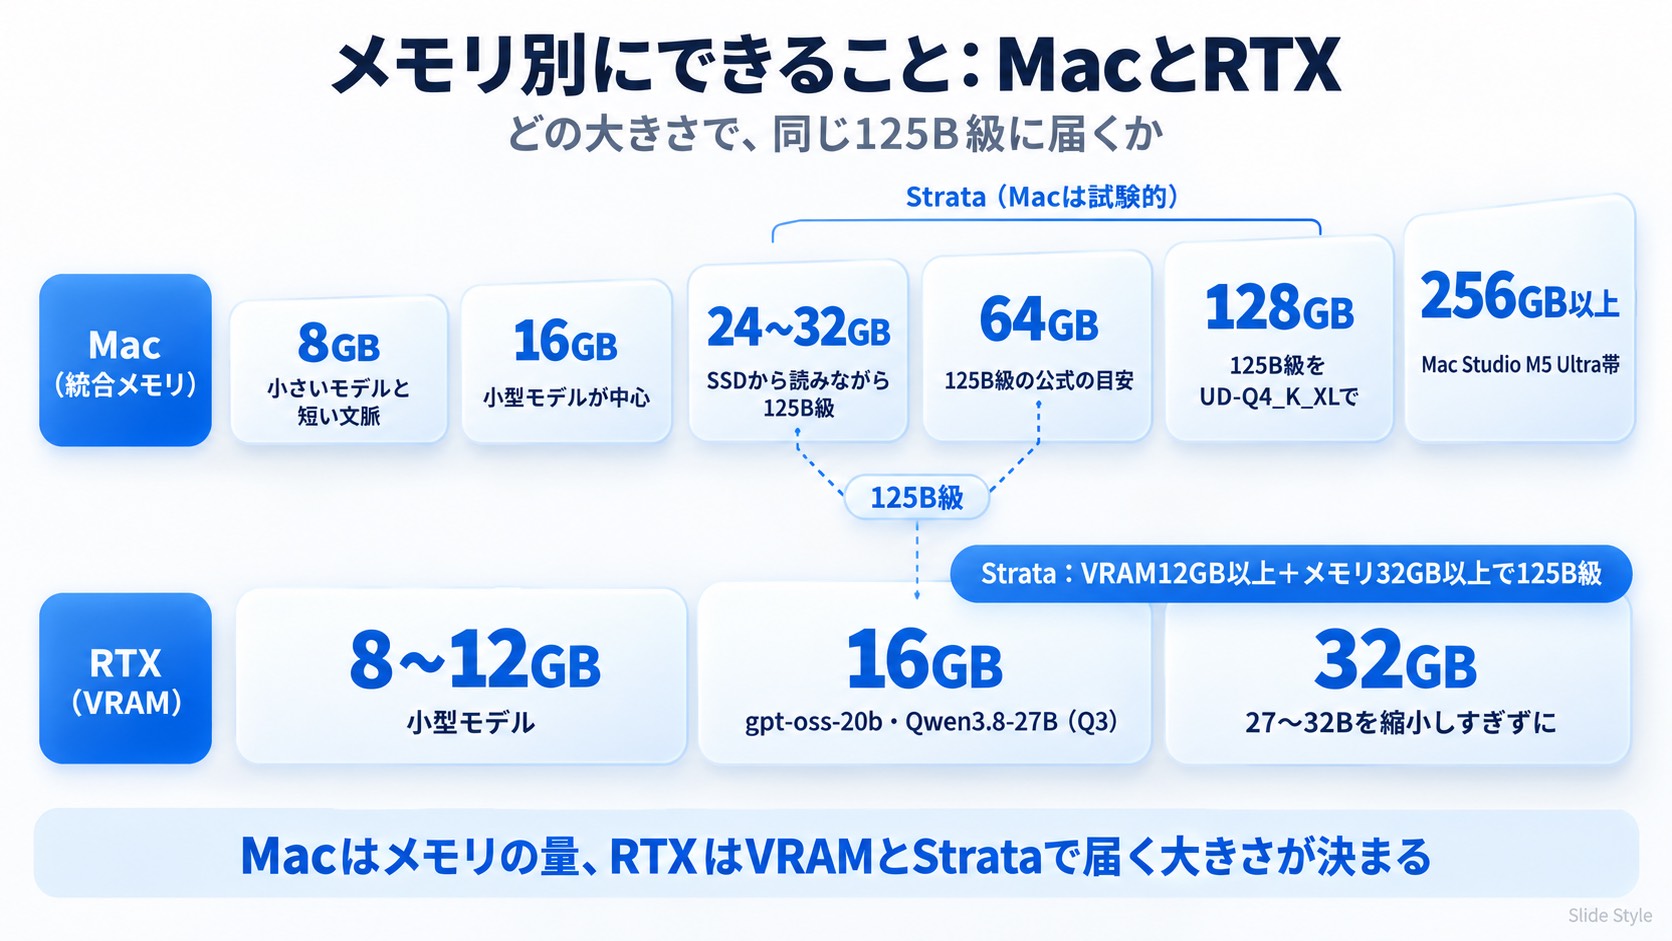
| メモリ | できることの目安 | 出典 |
| 8GB | LM Studio公式は「小さいモデルと短い文脈に限る」と案内 | LM Studio公式 |
| 16GB | LM Studio公式の推奨ライン。小型モデルの推論が中心 | LM Studio公式 |
| 24〜32GB | Strata公式は32〜48GBならSSDから読みながら動くと案内(24GBは未テスト)。開発元はM4 Mac mini 32GBでQ2_0量子化を毎秒約8〜14トークンと計測 | Strata公式 |
| 64GB | Strata公式がQ2_0量子化の目安として示す容量(64GBから) | Strata公式 |
| 128GB | Strata公式の目安でUD-Q4_K_XL量子化が収まる容量。開発元がM5 Max 128GBで測った速度はQ2_0で毎秒107〜114トークン | Strata公式 |
| 256GB以上 | Mac Studio M5 Ultra帯のメモリ量。この容量でのStrataの計測結果は公式に公開されていない | Apple公式・Strata公式 |
16GBや24GBのMacについて、Strataの公式ドキュメントには動作結果の記載がありません。
「小さめのMacは未テスト」と公式に書かれているため、小容量メモリのMacでStrataが動くかどうかは確認できていません。
一方、OllamaとLM Studioは、より小さなモデルであれば16GB前後でも回答を生成する「推論」を試せます。
始め方:OllamaとLM Studio
使い始める前に、MacのOS・メモリ・空き容量がアプリの動作条件を満たすかを確かめます。
Ollamaは、macOS Sonoma(14)以降のMacで動きます。
モデルによって数十〜数百GBの空き容量が要るため、ダウンロード前にストレージの空きを確かめておくと安心です。
LM Studioは、macOS 14.0以上のApple シリコン搭載Macで動き、メモリは16GB以上を推奨しています。
8GBのMacでは、小さいモデルと短い文脈に限られます。
予算50万円前後で何ができるか — MacとRTX機を比べる
- 同じ50万円前後でも、Macを選ぶかRTX機を足すかで使い方が変わる
- 大きなモデル(125B級)の動き方は、開発元の計測と当サイトの実測で条件が違う
- Macは静かで電力が小さく、RTX機は速さとソフトの多さが強み
予算50万円前後で検討する候補を、価格とメモリの量で比べました。
RTX機は、VRAM16GBで50万円前後までのRTX 5070 Ti搭載4機種とRTX 5080搭載1機種。
RTX 5080はVRAMがRTX 5070 Tiと同じ16GBで、載せられるモデルの大きさは同じです。
当サイトの実測機はRTX 5070 Tiで、RTX 5080の速さは計測していません。
Macは、Mac Studio M5 Max(64GB構成)とMac mini M5 Pro(64GB構成)です。
| 機種 | GPU・メモリ | 主な構成 | 価格(確認日) | 購入 |
FRONTIER FRGKB550/C | RTX 5070 Ti(16GB) | Ryzen 7 5700X/メモリ32GB/1TB | 384,800円 (2026年10月19日時点・受注生産) | 公式ページを見る |
HP HyperX OMEN 35L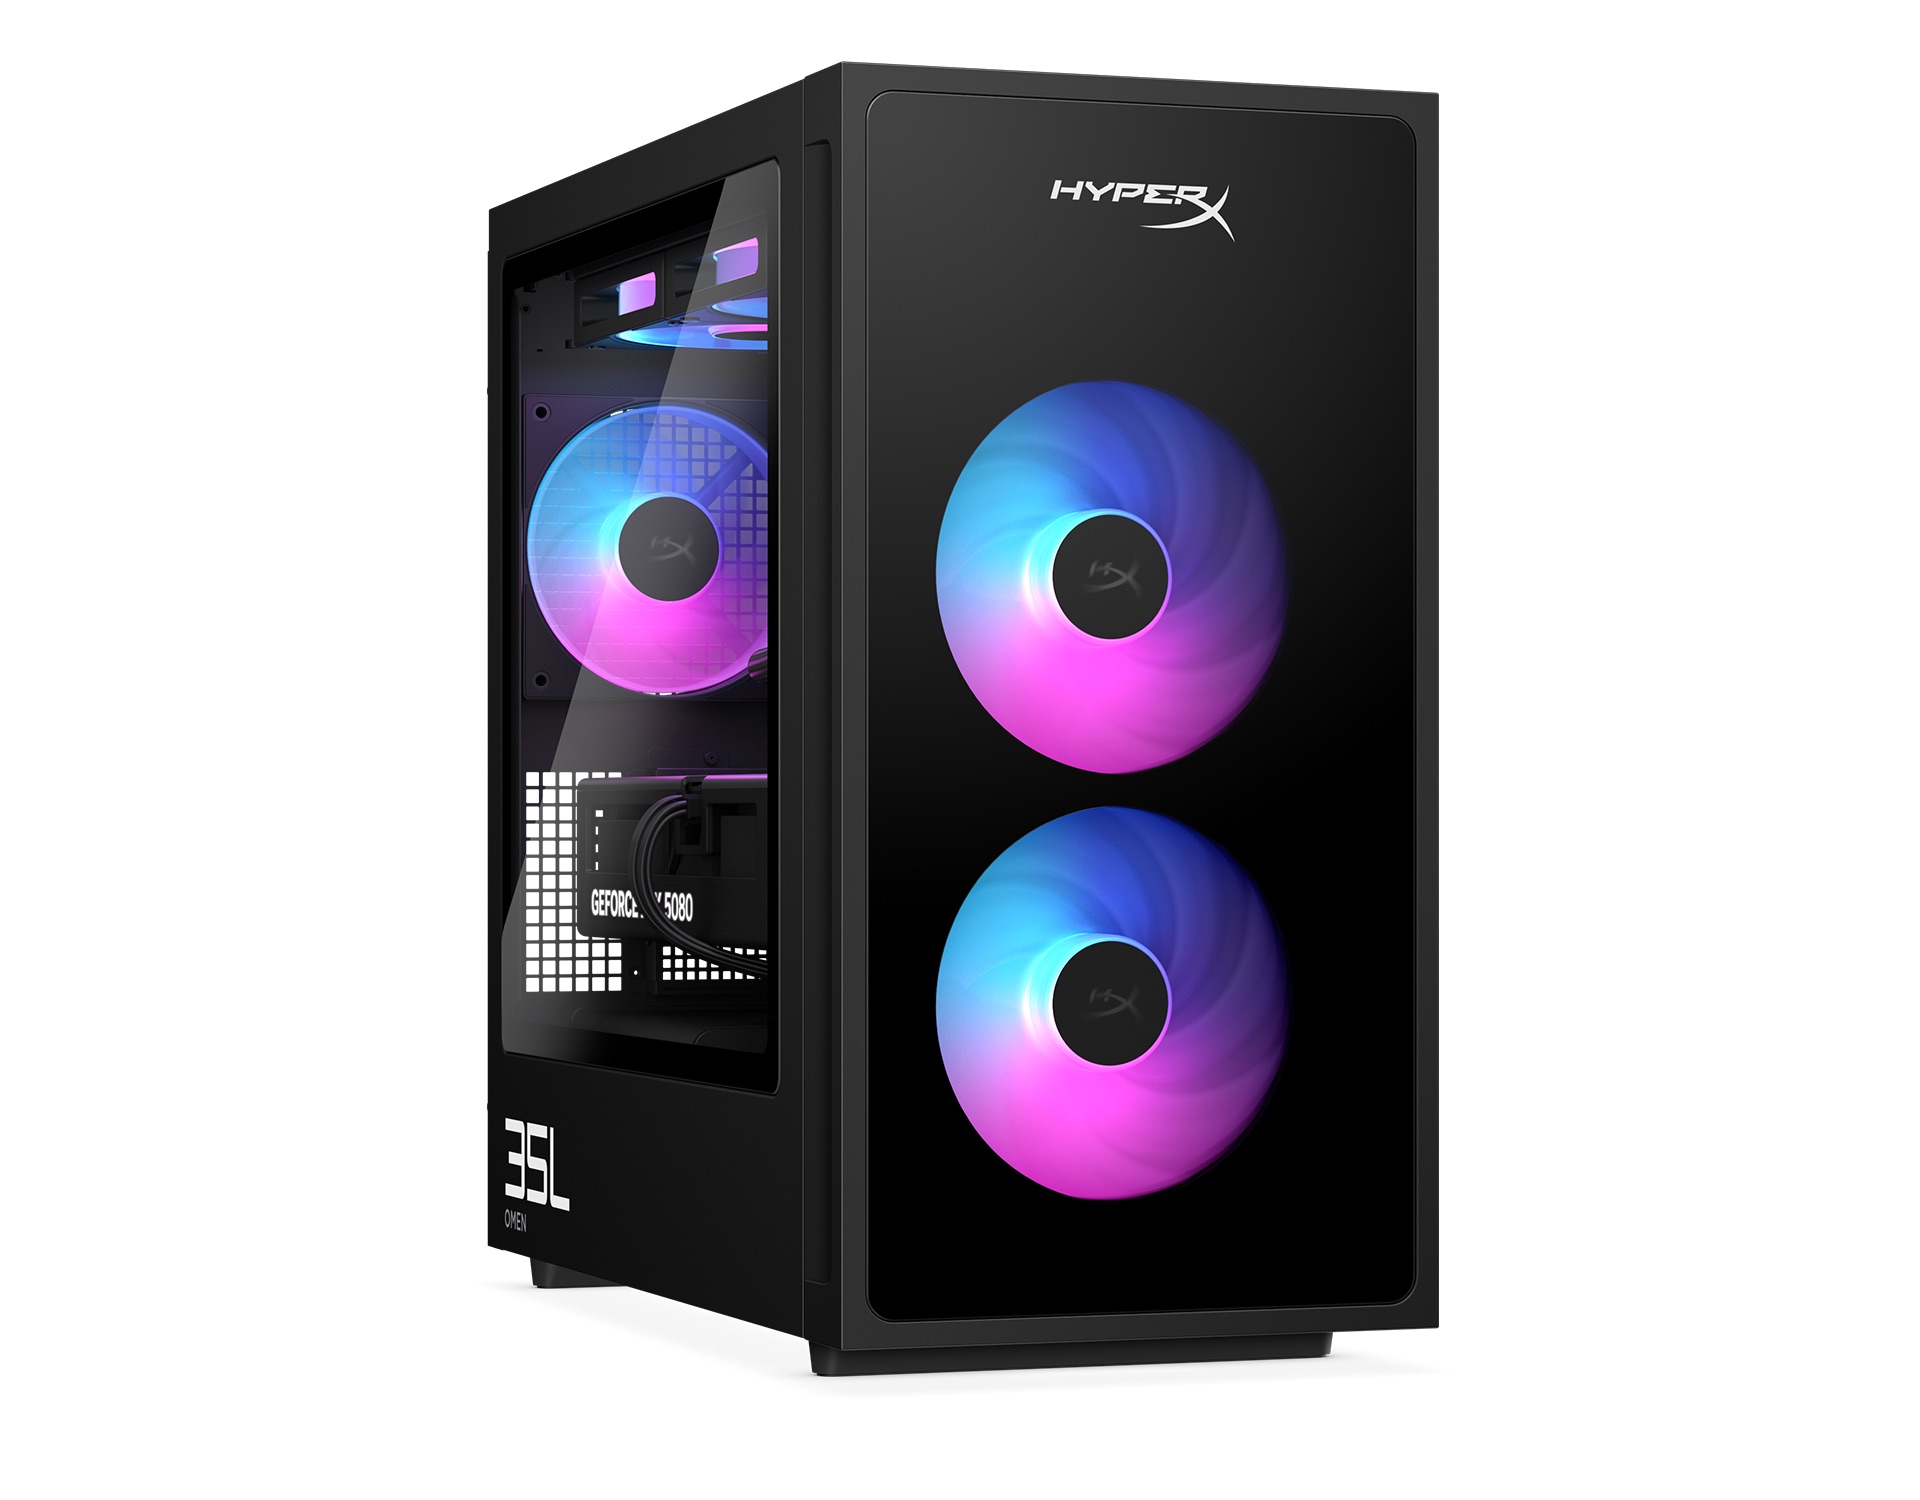 アドバンス シグニチャー | RTX 5070 Ti(16GB) | Ryzen 7 9700X/メモリ32GB/1TB | 429,800円から (2026年10月17日時点・大決算祭り第2弾・入荷予定あり) | HP公式を見る |
FRONTIER FRGKB860M/CG3 (当サイトの計測機) | RTX 5070 Ti(16GB) | Core Ultra 7 265F/メモリ32GB/1TB | 469,800円 (2026年10月17日時点・受注生産) | 公式ページを見る |
Lenovo Legion Tower 5 30AGB10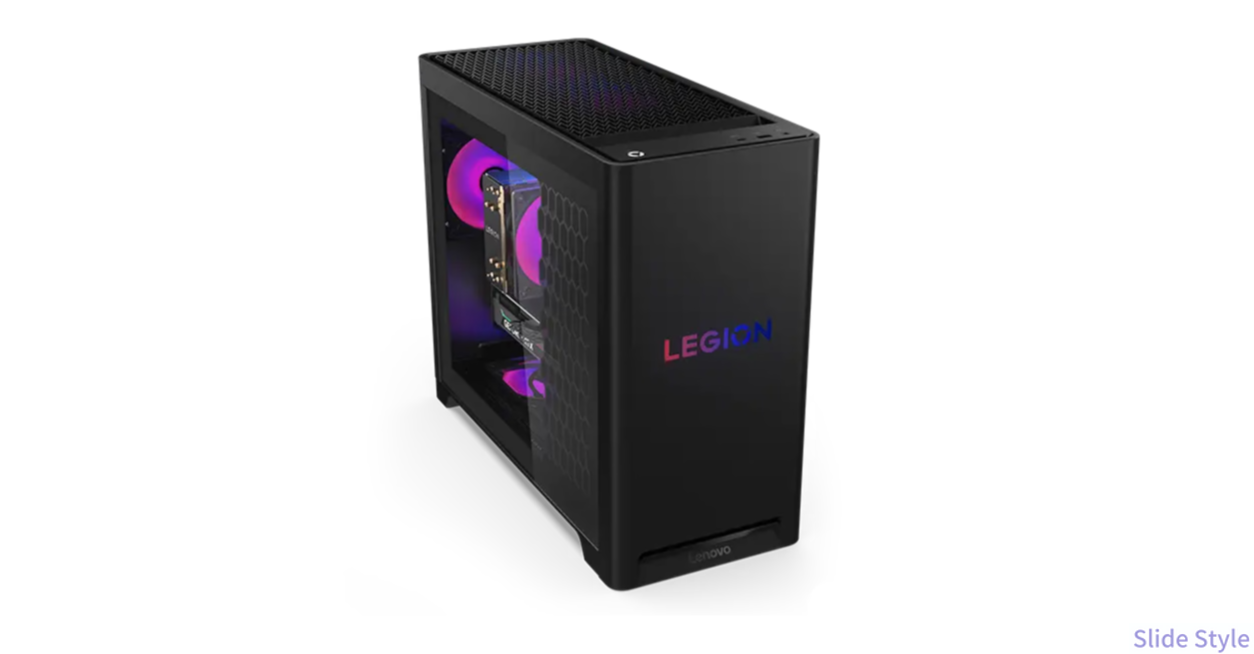 | RTX 5070 Ti(16GB) | Ryzen 7 7700X/メモリ32GB/1TB | 469,480円 (2026年10月17日時点) | 公式ページを見る |
FRONTIER FRGHLMB650/WS1006 | RTX 5080(16GB) | Ryzen 7 9800X3D/メモリ32GB/1TB | 489,800円 (2026年10月18日時点) | 公式ページを見る |
| Mac Studio M5 Max(18コアCPU・40コアGPU)  (イメージ) | 統合メモリ64GB | 初期構成 | 527,800円から (2026年10月17日時点・Apple Store) | Amazonで見る |
| Mac mini M5 Pro(15コアCPU・16コアGPU)  (イメージ) | 統合メモリ64GB | SSD 1TB/2.5ギガビットEthernet | 533,800円 (2026年10月17日時点・Apple Store) | Amazonで見る |
HPのHyperX OMEN 35Lは、11構成のうち「入荷予定あり」の表示が付くのはRTX 5070 Tiの2構成だけです。
RTX 5070 Tiは品薄になっていると考えられます。
HPの表示を根拠にした当サイトの見立てです。
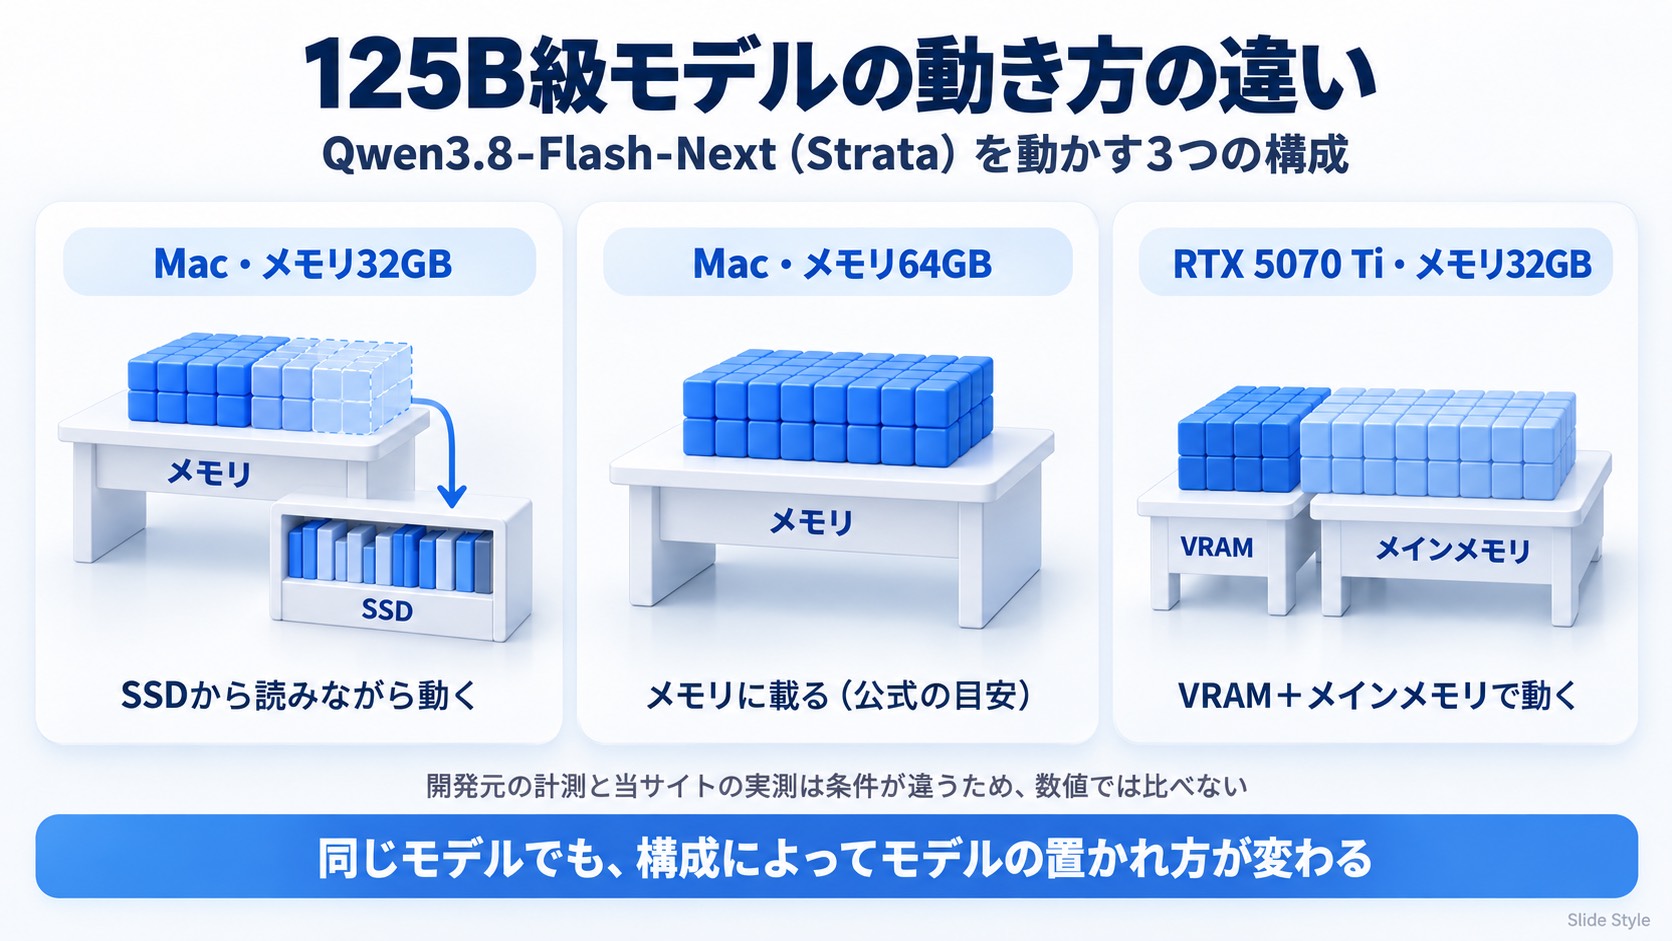
大きなモデルの動き方も見ておきます。
総125Bという規模の大型モデル、Qwen3.8-Flash-Nextを、無料ソフトのStrataで動かした場合の目安。
表に出てくる「量子化」は、百科事典を省スペース版にするように、モデルのデータを小さくする方法です。
「トークン」はAIが扱う文字や単語の区切りで、毎秒の数値は回答を生成する速さ。
開発元の計測と当サイトの実測は機種や構成が違うため、表では計測の種類を分けています。
| 条件 | 計測の種類 | 数値 |
| Mac・メモリ32GB(SSDから読みながら) | 開発元の計測(M4 Mac mini) | Q2_0量子化で毎秒約8〜14トークン |
| Mac・メモリ64GB | 開発元の目安 | Q2_0量子化の目安が64GBから(この容量での速度は公開されていない) |
| RTX 5070 Ti・メモリ32GB(Windows) | 当サイトの実測 | Q2_0量子化で毎秒69.6トークン(3回の中央値・初回は30.0) |
Mac側の数値は、Strataの開発元が公式に発表した計測です。
当サイトの69.6トークン(初回は30.0トークン)は、RTX 5070 Ti・メモリ32GBのWindows機で、Qwen3.8-Flash-NextのQ2_0を動かした実測です。
話題を初めて聞く形(cold)で前置きのない質問(深さ0)を3回送ったときの中央値です。
同じ形の質問を続けて送った3回(warm)では、中央値で毎秒91.0トークンまで上がりました。
GPUの規模もメモリの量も違うため、表の3つの条件を単純に並べて速さを決めることはできません。
Macがおすすめの人は、静かな環境で長時間動かしたい人。
Mac miniの最大消費電力は155W、Mac Studioは480Wで、どちらも公式の値です。
使い慣れたMacのアプリや環境を続けられる点も、Macを選ぶ理由になります。
RTX機がおすすめの人は、同じ予算で速さを求める人や、NVIDIAのGPUで計算する仕組み「CUDA」に対応したソフトを多く使う人。
ゲームや画像生成など、AI以外の用途にも使える点もRTX機の特徴です。
Macのまま狙うなら
- Mac mini・Mac Studioは、注文してから届くまで時間差がある
- 2026年8月25日に発表・予約開始、9月22日にお届け開始
- 512GBメモリのMac Studioは2026年10月17日時点でまだ選べない
Macを買う場合の候補と、出荷までの目安をまとめました。
Appleの直販は、構成によって注文から出荷まで数週間かかります。
公式の構成画面に表示される出荷日を確認日付きで載せています。
| 機種 | チップ | メモリ | 価格(税込) | 出荷日(2026年10月17日時点) | 買える場所 |
| Mac mini | M5 Pro | 64GB・1TB | 533,800円 | 1〜2週間 | Amazonで見る |
| Mac Studio | M5 Max | 128GB・1TB | 941,800円 | 3〜4週間 | Amazonで見る |
| Mac Studio | M5 Ultra(36コアCPU・80コアGPU) | 256GB・1TB | 1,903,800円 | 15〜17週間 | Amazonで見る |
| MacBook Air | M5 | 16〜32GB | 224,800円から | 今回は未確認 | Amazonで見る |
| MacBook Pro | M5・M5 Pro・M5 Max | 〜128GB | 339,800円から | 今回は未確認 | Amazonで見る |
2026年10月17日にApple Storeの構成画面で確認した値です。
出荷日は、在庫や注文状況によって変わります。
発表は2026年8月25日でした。
同日から予約注文を受け付け、お届けと店頭販売の開始は2026年9月22日です。
先に予約と決済を受け、後から順に届ける売り方になっています。
512GBメモリは、Mac Studio M5 Ultra(36コアCPU・80コアGPU)構成だけに用意されるオプションです。
2026年10月17日時点のApple Storeの構成画面には「10月下旬に発売」という注記があり、まだ選べません。
学生・教職員向けの価格は、Mac mini M6が132,800円から、Mac Studio M5 Maxが385,800円からです。
Macはそのまま、RTX機を家に足すなら
- RTX機をAI専用の部屋に見立て、Macから話しかける使い方ができる
- 別の機器から使うときは、StrataもOllamaもネットワークの設定を変える
- 使う範囲は家のネットワークの中だけにする
MacとRTX機を両方持つ場合、RTX機を家の中のAI専用の部屋に見立て、Macから話しかける使い方ができます。
Mac側の環境は変えず、大きなモデルや速い処理が要るときだけRTX機を使う形です。
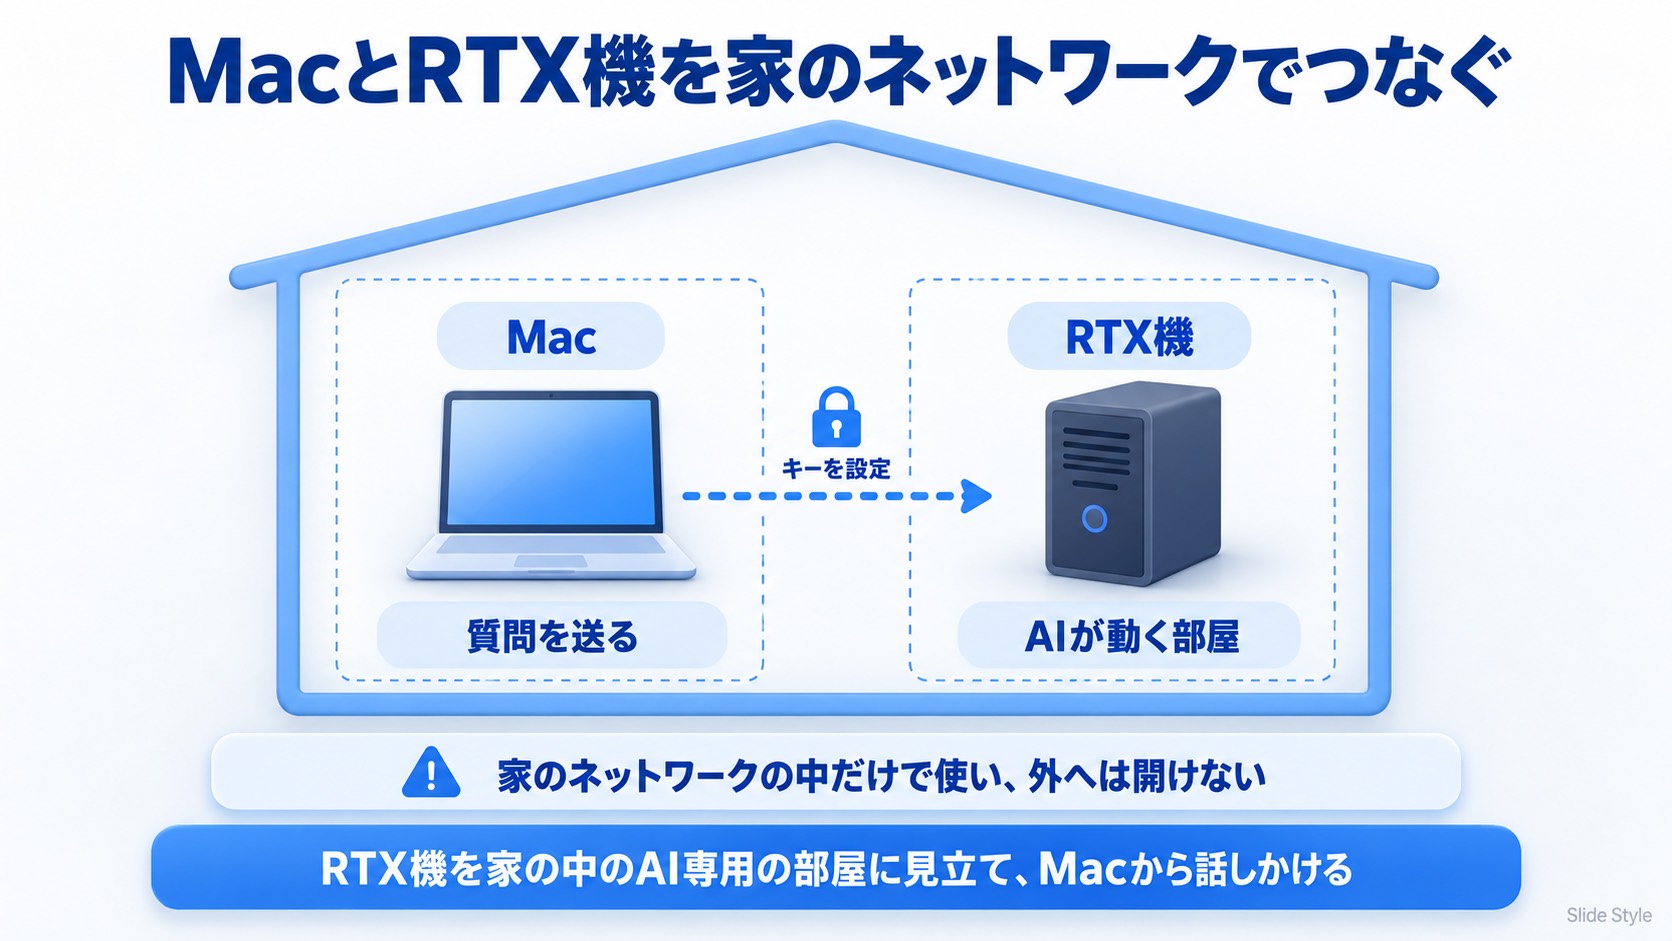
Strataで別の機器から使うときは、Strataを動かすPCで--host 0.0.0.0 --api-key <鍵>のように起動し、必ずキーを設定します。
Strataには、ほかのアプリからAIへ質問を送る窓口(API)と、ブラウザで開けるチャット画面があります。
APIはOpenAI互換です。
Ollamaは、既定で127.0.0.1(Ollamaを動かすPCだけ)で動きます。
別の機器から接続できるようにするには、接続先を指定する設定値(環境変数)OLLAMA_HOSTを変えます。
当サイトでは、Macの画面からネットワーク越しにRTX機へ接続し、RTX機のフォルダを開いてモデルのダウンロードや計測をしたことがあります。
MacからRTX機そのものを遠隔操作する使い方と、RTX機で動くAI(Strata・Ollamaなど)にMacから質問を送る使い方は別です。
この記事では、RTX機のAIにMacから質問を送る方法を中心に、公式の手順に沿って説明します。
別の機器からも使えるようにする場合、家のネットワークの中だけで使い、ルーターのポート開放はしないのが基本です。
Strataの公式も、キーを必ず設定するよう明記しています。
RTX機の候補
Macから質問を送るAI専用機は、Macの代わりではなく、Macに足す2台目です。
Macにすでに予算をかけているなら、RTX機は条件を満たす範囲で小さめに抑える考え方もあります。
RTX機を足す理由は、Macでは動かしにくい大きなモデルを動かすことです。
そのため、Strataで125B級を動かせる条件(VRAM12GB以上・メモリ32GB以上)を満たす機種に絞り、2026年10月18日時点の各社公式サイトの価格でVRAMの小さい順に並べました。
| 機種 | GPU・メモリ | 価格 (2026年10月18日時点・税込) | 載せられるモデルの目安 | 購入 |
| FRONTIER FRGHLMB650/WS0924 | RTX 5070 (12GB) メモリ32GB | 312,800円 | Strata公式の条件(VRAM12GB以上・メモリ32GB以上)を満たし、125B級の対象。 当サイトの実測は16GBの機種だけ | FRONTIER公式を見る |
| マウス G TUNE DG-A7G6T (ホワイト)  (画像はブラック) | RTX 5060 Ti (16GB) メモリ32GB | 329,800円から | Strataで125B級。 gpt-oss-20b、Qwen3.8-27B(UD-Q3_K_XL)も載る | マウス公式を見る |
| FRONTIER FRGKB550/C | RTX 5070 Ti (16GB) メモリ32GB | 384,800円 | Strataで125B級。 gpt-oss-20b、Qwen3.8-27B(UD-Q3_K_XL)も載る | FRONTIER公式を見る |
| FRONTIER FRGKB860M/CG3 (当サイトの計測機) | RTX 5070 Ti (16GB) メモリ32GB | 469,800円 | 上と同じ範囲。 Strataの125B級で毎秒69.6トークン(当サイトの実測・3回の中央値・初回は30.0) | FRONTIER公式を見る |
| FRONTIER FRGHLMB650/WS1006 | RTX 5080 (16GB) メモリ32GB | 489,800円 | VRAMはRTX 5070 Tiと同じ16GBで、載せられるモデルも同じ範囲 | FRONTIER公式を見る |
RTX 5090(32GB)は、2026年10月18日時点でHP・Lenovo・FRONTIER・マウスの4社とも注文できない状態でした。
大きなモデルならMac Studio M5 Ultra
- M5 Ultraは96GBか256GBのメモリで、512GBは10月下旬予定の表示のまま
- AppleのテストでAI演算性能はM3 Ultraの最大4.3倍
- 2台つなぐ仕組みはあるが、速度の数字は公式に無い
Mac Studio M5 Ultraは、メモリ96GBまたは256GBを選べます。
512GBのメモリは、2026年10月17日時点でも「10月下旬に発売」という注記のままで、構成画面では選べません。
帯域は1.2TB/sで、64コアGPUと80コアGPU、どちらの構成でも変わりません。
Appleは、2026年7月のテストで、M5 UltraのAI演算性能がM3 Ultraの最大4.3倍、M1 Ultraの9.8倍になったと発表しています。
512GBを待てないなら:Mac Studioを2台つなぐ
メモリ512GBのMac Studioは、2026年10月17日時点のApple Storeではまだ選べません。
大きなモデルを手元で早く試したい場合は、いま選べる構成のMac Studioを2台つなぎ、1つのモデルを2台に分けて載せる方法があります。
Thunderbolt 5のケーブルでMacどうしを直結して組めるのが、MLXの特徴です。
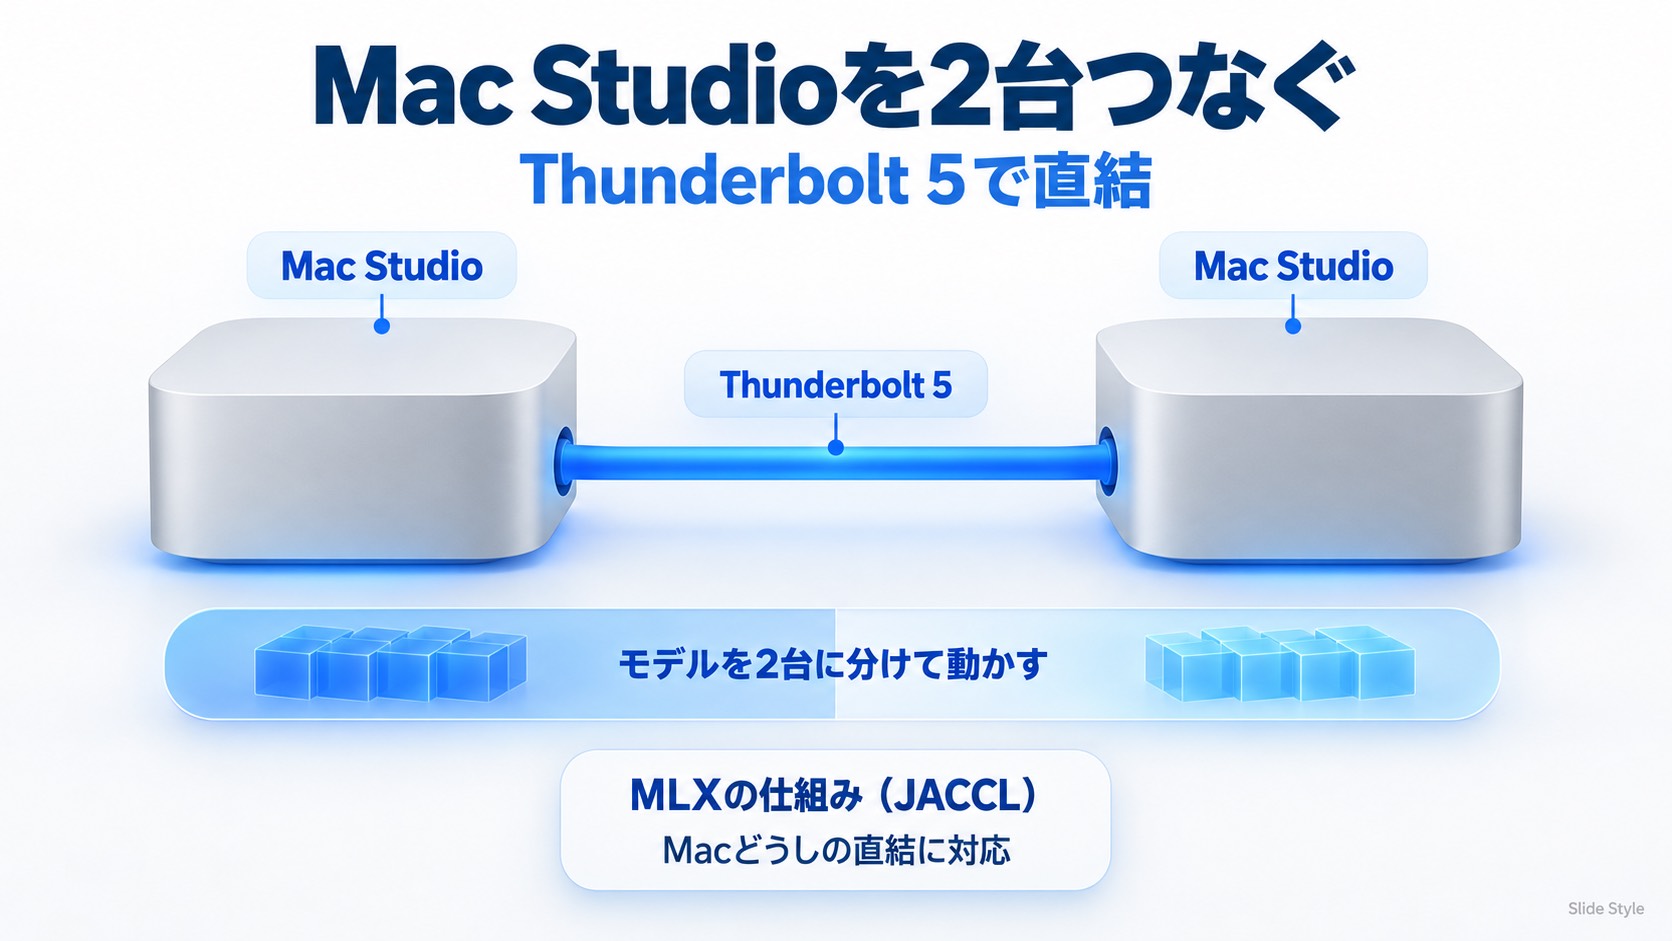
MLXという仕組みには、複数のMacをつないで計算を分け合う機能があります。
MLXの通信方式のうちJACCLは、Thunderbolt 5でつないだMacどうしの通信に対応し、macOS 26.2以降で使えます。
有効にするには、macOSの復旧モードで設定を行い、再起動します。
Macどうしをケーブルで直結する形だけに対応し、接続ごとの設定が要ります。
MLXには、モデルを複数のMacに分けて動かす「テンソル並列」という仕組みもあります。
Llama型のモデルで使う例が公開されています。
公式の例はM3 Ultra 4台で、M5 Ultraの例はありません。
たとえばM5 Ultra(36コアCPU・80コアGPU)の256GB構成を2台そろえると、メモリは合計512GBで、価格は2台で3,807,600円です(1台1,903,800円・2026年10月17日時点の税込価格)。
メモリ96GBの構成なら、2台で1,899,600円からで、合計192GBです。
1台では載らない大きさのモデルを、2台のメモリに分けて載せる考え方です。
ただし、2台に分けて動かしたときの速さ(トークン/秒)はMLXの公式ドキュメントに数値がなく、512GB構成の1台と同じ使い心地になるかは分かりません。
Strataの公式資料にも、2台構成についての記載はありません。
512GB構成が選べるようになるのを待つか、2台で先に始めるかは、試したいモデルの大きさと予算で決めるのがおすすめです。
StrataのMac対応(試験的)
- 2026年10月13日のv0.1.44で、Macへの対応を試験的に追加
- 開発元が測ったMacはM5 Max 128GBとM4 Mac mini 32GBの2台だけ
- Macで使う条件と開発元の計測は、Strataの解説記事で更新している
Strataは、総125BのQwen3.8-Flash-Nextを普通のPCで動かす無料のソフトです。
2026年10月13日のv0.1.44で、Mac(Apple Silicon・Metal)への対応を試験的に追加しました。
対象はM1〜M5のMac、macOS15以上で、Intel Macは対象外です。
Mac用の完成品は配布されていません。./setup.shを実行すると、Mac上で動作に必要なエンジンを組み立て、モデルをダウンロードして、サーバーを起動します。
Python 3.10以上が要りますが、setup.shが自動で用意します。
開発元が速度を測ったMacは、M5 Max 128GBとM4 Mac mini 32GBの2台だけです。
M5 Max 128GBでは、量子化Q2_0で毎秒107〜114トークンでした。
M4 Mac mini 32GBはメモリに載らずSSDから読みながら動かし、Q2_0で毎秒14.1トークン(短い質問)でした。
一度に処理できる依頼(リクエスト)は1つだけです。
質問や資料など、AIがまとめて扱う文脈の長さは32Kまでの計測です。
Macで使う条件と開発元の計測は、Strataの解説記事で更新しています。
当サイトのRTX 5070 Tiでの実測は、Qwen3.8-Flash-Nextの32GB実測の記事にまとめています。
まとめ
MacでのローカルLLMは、メモリの量と帯域で何ができるかが決まります。
予算50万円前後なら、Macを買い替えたり買い増したりして新しいMacの環境で始める方法と、今のMacはそのまま使い、RTX機を足して2台で使う方法があります。
- 新しいMacで始める人:静かに長時間動かしたい、Macだけで完結させたい、省電力を重視する
- 今のMacにRTX機を足す人:同じ予算で速さを求める、CUDA対応ソフトを多く使う、ゲームや画像生成も一緒にやりたい
価格・出荷日・在庫は、確認後に変わる場合があります。
この記事と各解説記事で随時更新していきます。
使った時間に応じて料金を払うクラウドGPUで費用を抑えたい場合は、「ローカルLLMはPCを買うべきか」の記事で、クラウドGPUとの費用を使う時間とモデルの大きさ別に試算しています。
RTX機の候補を広く見るならローカルLLM用のGPU・PCの選び方、RTX Spark搭載機まで含めて比べるならRTX Spark・Mac・RTX 5090の比較記事にまとめています。
よくある質問(FAQ)
M1・M2のMacで動きますか?
OllamaとLM Studioは、M1以降のMacで動きます。
快適に使えるかどうかは、チップの世代よりもメモリの量で決まります。
メモリ8GBのMacで使えますか?
LM Studio公式は、8GBのMacでは小さいモデルと短い文脈に限ると案内しています。
LM Studio公式の推奨は16GB以上です。
MacBook Airで足りますか?
MacBook AirはM5搭載で、メモリは16GBから32GBまで選べます。
16GBは小型モデルが中心です。
32GBなら、Strataの開発元の資料ではSSDから読みながら125B級を動かせる範囲ですが、MacBook Airでの計測はありません。
Intel Macで使えますか?
Ollamaは、Intel(x86)のMacではCPUだけの対応です。
Strataは、Intel Macでは動きません。
LM Studioも、Apple シリコン搭載Macが対象です。
RTX 5080ならRTX 5070 Tiより向いていますか?
RTX 5080とRTX 5070 Tiは、どちらもVRAMが16GBで、載せられるモデルの大きさは同じです。
速さや価格の違いで選びます。
MacからWindowsのPCのAIを使えますか?
Strataはキーを設定すれば別の機器からも使える仕組みを持ち、OllamaもOLLAMA_HOSTでネットワークに出せます。
Macから、家のネットワークの中で、WindowsのPCのAIに接続する形です。
Mac Studioを2台つなぐと速くなりますか?
MLXにはMacどうしをつなぐ仕組み(JACCL)がありますが、速度の数字は公式に出ていません。
M5 Ultra搭載のMac Studioを2台そろえると、最低1,899,600円からです。
参考ソース(公式)
この記事で使った数値・事実の出典です。
価格・出荷日のように確認日が変わるものは、本文の各該当箇所に時点を明記しています。
- Apple 日本 Mac Studio 仕様:https://www.apple.com/jp/mac-studio/specs/
- Apple 日本 Mac mini 仕様:https://www.apple.com/jp/mac-mini/specs/
- Apple 日本 MacBook Air 仕様:https://www.apple.com/jp/macbook-air/specs/
- Apple 日本 MacBook Pro 仕様:https://www.apple.com/jp/macbook-pro/specs/
- Apple Store 日本 Mac Studio 購入ページ:https://www.apple.com/jp/shop/buy-mac/mac-studio(2026年10月17日確認)
- Apple Store 日本 Mac mini 購入ページ:https://www.apple.com/jp/shop/buy-mac/mac-mini(2026年10月17日確認)
- Apple Store 日本 MacBook Air 購入ページ:https://www.apple.com/jp/shop/buy-mac/macbook-air(2026年10月17日確認)
- Apple Store 日本 MacBook Pro 購入ページ:https://www.apple.com/jp/shop/buy-mac/macbook-pro(2026年10月17日確認)
- Apple Newsroom(新しいMac mini・M6/M5 Pro):2026年8月25日
- Apple Newsroom(新しいMac Studio・M5 Max/M5 Ultra):2026年8月25日
- Apple Newsroom(販売開始):2026年9月22日
- MLX 公式ドキュメント「Distributed Communication」:https://ml-explore.github.io/mlx/build/html/usage/distributed.html(2026年10月17日確認)
- MLX 公式ドキュメント「Tensor Parallelism」:https://ml-explore.github.io/mlx/build/html/examples/tensor_parallelism.html(2026年10月17日確認)
- Ollama 公式ドキュメント macOS:https://docs.ollama.com/macos
- Ollama 公式FAQ(OLLAMA_HOST):https://docs.ollama.com/faq
- LM Studio 公式 System Requirements:https://lmstudio.ai/docs/app/system-requirements
- Strata 公式GitHub(v0.1.44 リリースノート):https://github.com/Niko1221/Strata/releases/tag/v0.1.44
- Strata 公式GitHub(docs/MAC.md):https://github.com/Niko1221/Strata/blob/main/docs/MAC.md(2026年10月16日確認)
- HP HyperX OMEN 35L 製品ページ:https://jp.ext.hp.com/gaming/personal/hyperx_omen_35l/(2026年10月17日確認)
- FRONTIER FRGKB860M/CG3 製品ページ:https://www.frontier-direct.jp/direct/g/g121778/(2026年10月17日確認)
- Lenovo Legion Tower 5 30AGB10 製品ページ:https://www.lenovo.com/jp/ja/p/desktops/legion-desktops/legion-t-series/lenovo-legion-tower-5a-gen-10-30l-amd/90yjcto1wwjp6(2026年10月17日確認)
—