ローカルLLMはPCを買うべき?クラウドGPUと費用を比べ、使う時間とモデルの大きさで答える【2026年】
自分のPCでローカルLLM(手元で動かすAI)を使いたい。
GPUを積んだPCは高額で、買うかどうか迷う人も多いと思います。
とくにRTX 5090搭載PCは100万円を超え、本当に必要なのかも迷うところです。
5090は手に入りにくい時期もあります。
RTX 5080に下げるか、RTX 5060 Tiを複数枚にするかで迷う人もいるようです。
クラウドGPU(インターネット経由でGPUを借りる手段)もあります。
ただし止めたあともディスク代が残るなど、料金の仕組みに慣れが要ります。
この記事では、動かしたいモデルの大きさ(VRAM 16GBか32GBか)と使う時間の2軸で試算します。
- 要るPCの大きさは、動かしたいモデルで決まる。当サイトが測った9B〜27Bの4モデルは、量子化して16GBに収まった
- 短時間・たまに使う人は、16GB機でも32GB機でもクラウドGPUを時間で借りるほうが安い
- 24時間つけっぱなしで使う人は、手元のPCが安くなる。32GB機は本体が高い分、追いつくまでの時間が長い
- 文章作成・調べ物が中心なら、月額のAIサービスのほうが手軽で高性能
この記事は、当サイトの計測機で測った実測値と、NVIDIA・各サービスの公式情報(取得日つき)をもとに試算しています。
VRAM16GB搭載のデスクトップで、2026年9月〜10月に推論速度・学習時間・GPU電力を測りました。
32GB(RTX 5090搭載)機の電力はNVIDIA公式の公称値を使い、当サイトでは実測していません。
為替は2026年10月9日公表のTTM(売値と買値の中間の為替相場)で、1ドル158.17円です。
電気代の単価は、全国家庭電気製品公正取引協議会の目安(31円/kWh)を使用。
本文中の各表には、数字の出どころと取得日を添えています。
結論:モデルの大きさと使う時間で、安いほうが入れ替わる
- 要るPCの大きさ(16GBか32GBか)と、使う時間(週末だけ〜24時間)で答えが変わる
- 短時間ほどクラウドが安く、長時間ほど手元のPCが安くなる。16GBでも32GBでも傾向は同じ
- 32GB機は本体代が高い分、手元のPCが有利になるまでの時間が16GB機より長い
電気ケトルを毎日何度も使うなら自分で持つほうが安く、旅行先で1回だけ使うなら貸してもらうほうが安く済みます。
ローカルLLMとクラウドGPUの関係も同じで、月の使用時間が分かれ目になります。
費用を左右するもう1つの軸は、作業台の大きさ(動かしたいモデルのVRAM)です。
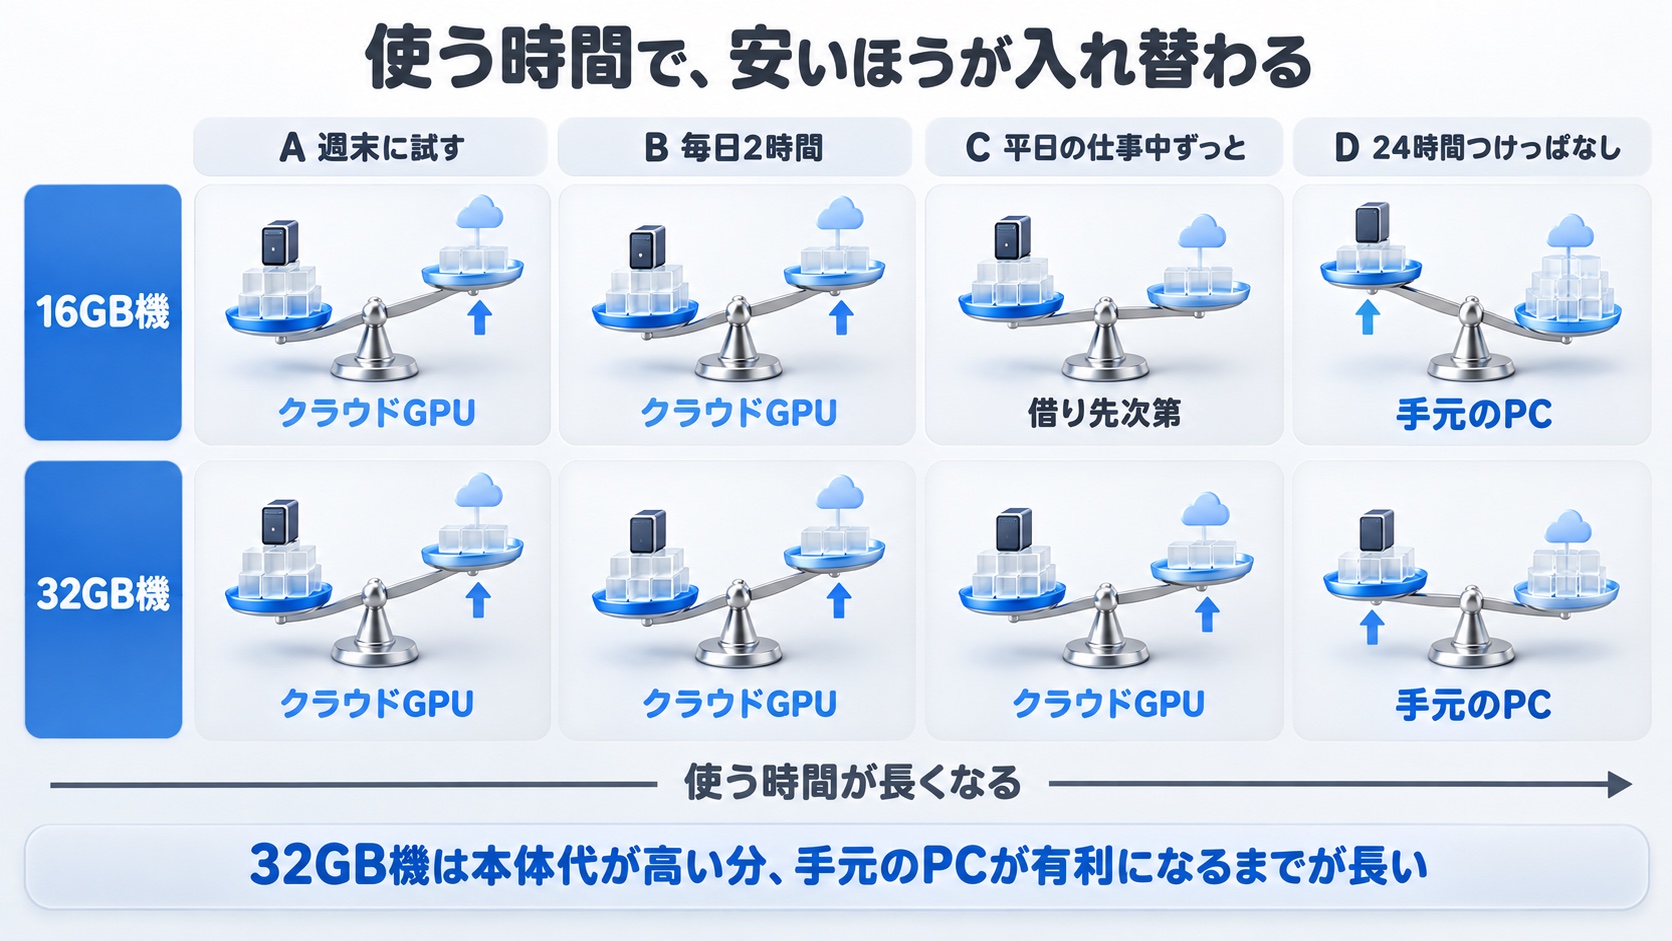
当サイトの試算では、月の使用時間を4パターンに分け、16GB機と32GB機の両方で比べました。
表の見方は、左から使い方、1か月の使用時間、16GB機のおすすめ、32GB機のおすすめの順です。
| 使い方 | 1か月の使用時間 | 16GB機のおすすめ | 32GB機のおすすめ |
| A 週末に試す | 20時間 | クラウドGPU | クラウドGPU |
| B 毎日2時間 | 60時間 | クラウドGPU | クラウドGPU |
| C 平日の仕事中ずっと | 176時間(8時間×22日) | 借り先次第。RunPodの5090なら約16〜23か月で本体代に届く | クラウドが有利な期間が長い(3年以上) |
| D 24時間つけっぱなし | 730時間 | 手元のPC。約4〜6か月で借りる料金が本体代に届く | 手元のPC。約10〜15か月かかるが最終的に安くなる |
詳しい数字は「価格帯ごとに月額を比べる」の節にまとめています。
32GB機は本体代が高いため、手元のPCが有利になるまでの時間が16GB機よりも長くなります。
ローカルLLMに要るPCは、動かしたいモデルで決まる
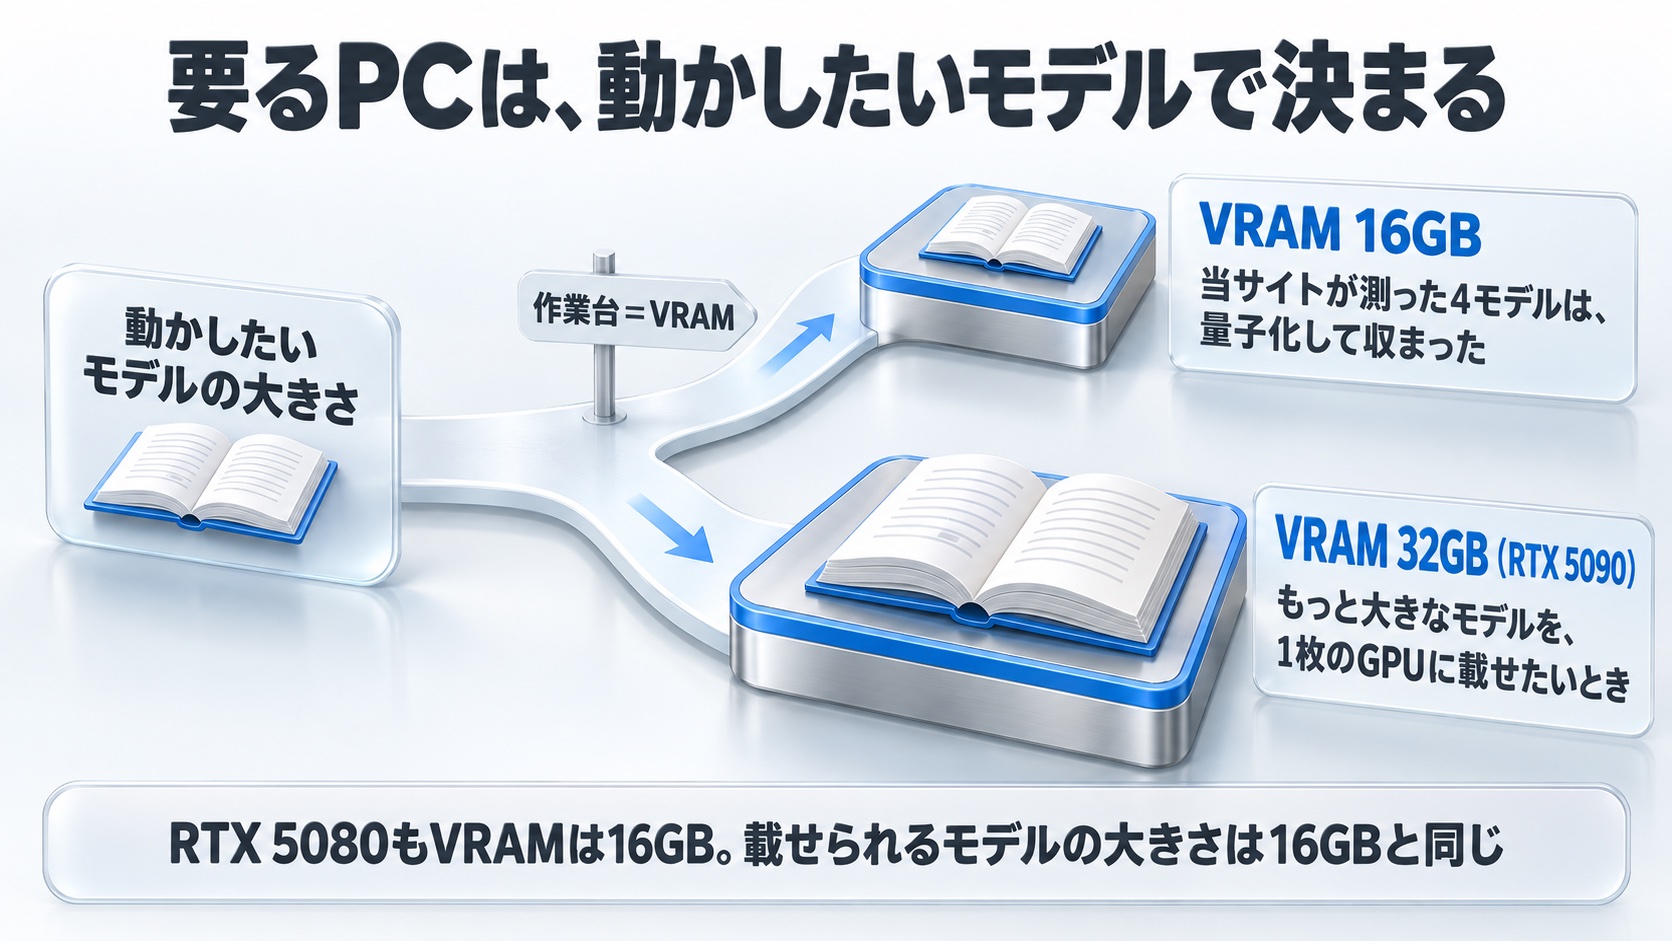
- GPUの専用メモリ(VRAM)は、AIが本を広げて読み書きする作業台にたとえられる
- 当サイトが測った9B〜27Bの4モデルは、作業台16GBに収まった
- RTX 5090(32GB)が候補になるのは、当サイトで実測したモデルより大きなモデルを1枚で載せたいとき
GPUの専用メモリ(VRAM)は、AIが使う作業台にたとえられます。
AIモデルという本を広げて読み書きする台の大きさが、動かせるモデルの大きさを決めます。
作業台が狭いと、本の一部しか広げられず、残りを棚(システムメモリ)へ置きます。
棚と作業台の間で本を動かすため、読み書きが遅くなります。
当サイトでは、作業台16GBのPCでいくつかのモデルを実測しています。
gpt-oss-20b・Gemma 4 26B-A4B・Qwen3.5 9B・Qwen3.8-27Bの4モデルです。
いずれも量子化(モデルを小さくする方法)を使い、16GBの作業台に収まりました。
詳しい速さは、「16GB機で1時間にできる仕事の量」の節で紹介します。
32GBの作業台が候補になるのは、測った4モデルより大きなモデルを、分割せずに1枚のGPUへ載せたい場面です。
RTX 5090のVRAMは32GB(NVIDIA公式)で、この記事で比べる2つの価格帯のうち、広いほうの作業台です。
5090の代わりに考えられる選び方
RTX 5090搭載のデスクトップは、注文できない表示が続く時期があります。
別の選び方を考える人もいます。
当サイトで確認できた範囲で、3つの考え方を整理します。
RTX 5080に下げる
RTX 5080のVRAMは16GB(NVIDIA公式)で、この記事の後半で紹介する当サイトの計測機と同じ大きさです。
作業台の広さが同じなので、載せられるモデルの大きさも変わりません。
RTX 5060 Tiを2〜3枚使う
複数のGPUに分けて1つのモデルを載せる使い方を、llama.cppの公式ドキュメントが説明しています。
モデルが1枚のVRAMに収まらないとき、重みを複数枚に分けて、全部をGPU上に置けるという仕組みです。
ただし、GPU同士の接続の速さがボトルネックになることがあります。
GPU間の接続が遅いと、1枚で動かすより遅くなるとも、同じ公式ドキュメントに書かれています。
当サイトは複数枚の構成を検証していません。
RTX 5060 TiにはVRAM 16GB版と8GB版があります(NVIDIA公式)。
2026年10月13日時点のFRONTIER公式では、注文できるRTX 5060 Ti搭載機は8GB版だけでした。
メーカーが組み立てて売るPCで、GPUを2枚以上積んだ構成は、同じ時点のFRONTIER公式で見当たりませんでした。
自分でパーツを選んで組む選択肢になります。
GPU1枚のPCを買い、あとから自分でGPUをもう1枚足す
メーカーが組み立てたGPU1枚のPCを買い、あとからグラフィックボードをもう1枚、自分で取り付ける考え方です。
FRONTIERの保証規定では、販売後に指定工場以外で行った増設は保証の対象外です(第11条)。
電源やケース、マザーボードの空きなど条件がそろう必要もあり、完全に自己責任の範囲です。
当サイトはGPUの増設を検証していません。
比べる3つの選択肢:PCを買う・GPUを時間で借りる・AIサービスに月額を払う
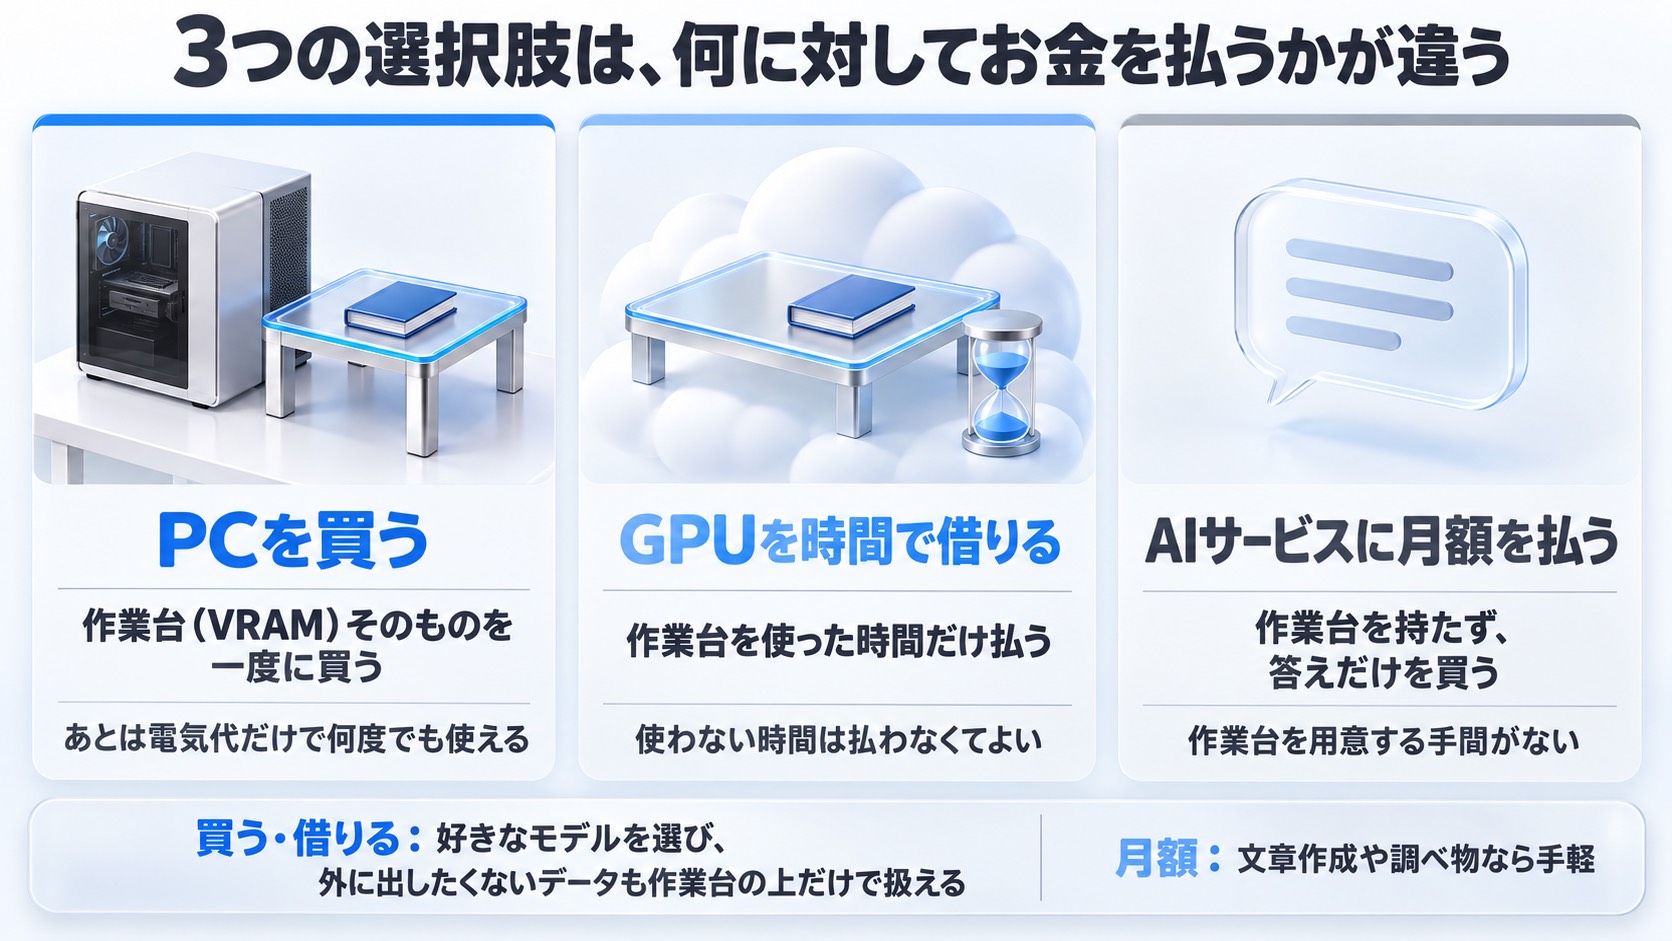
- 3つの選択肢は、何に対してお金を払うかが違う
- PCを買う=作業台そのものを一度に買う
- GPUを時間で借りる=作業台を使った時間だけ払う
- 月額のAIサービス=作業台を持たず、答えだけを買う
3つの選択肢では、作業台を自分で買うか、借りるか、AIサービスに任せるかが違います。
- PCを買う:作業台を一度にまとめて買う。あとは電気代だけで何度でも使える
- GPUを時間で借りる(クラウドGPU):作業台を使った時間だけ料金を払う。使わない時間は払わなくてよい
- AIサービスに月額を払う:作業台そのものは持たず、物知りの人(AI)が出した答えだけを買う
自分で作業台を用意する2つ(買う・借りる)は、好きなモデルを選べます。
手元のPCを買えば、外に出したくないデータも自分の机の上だけで扱えます。
月額のAIサービスは作業台を用意する手間がなく、文章作成や調べ物なら手軽に高い性能を使えます。
どれが向くかは「ChatGPT・Claudeの月額で足りる人」の節で比べます。
16GB機で1時間にできる仕事の量
- 当サイトの計測機はRTX 5070 Ti 16GB搭載のデスクトップ
- gpt-oss-20bは1時間の連続生成で約81万トークン(225.8 tok/s×3,600秒)
- 当サイトの記事1,000段落を使った学習は3分31秒(211.3秒)で1周
借りる時間を見積もるには、まず手元のPCで1時間にどれだけの仕事ができるかを知る必要があります。
当サイトの計測機は、RTX 5070 Ti 16GB搭載のデスクトップです。
推論の速さは2026年9月3日、学習の時間は10月5日に実測しました。
表は左から、モデル、文章を書く速さ(tg、深さ0と32K文脈)、32K文脈時のVRAM、GPUの電力(単体)の順です。
文脈はAIが答えるときに参照する会話や資料。
量子化はモデルを小さくしてメモリの使用量を減らす方法です。
| モデル(量子化) | tg 深さ0 | tg 32K | VRAM 32K | GPU電力(単体) |
| gpt-oss-20b(MXFP4) | 225.8 tok/s | 181.0 tok/s | 12.9GB | 229〜289W |
| Gemma 4 26B-A4B(QAT Q4_0) | 193.8 tok/s | 158.4 tok/s | 15.5GB | 201〜290W |
| Qwen3.5 9B(Q4_K_M) | 128.8 tok/s | 110.4 tok/s | 7.2GB | 265〜294W |
| Qwen3.8-27B(UD-Q3_K_XL) | 53.2 tok/s | 47.1 tok/s | 15.1GB | 295〜301W |
tg(文章を書く速さ)は1秒あたりのトークン数(tok/s)で表します。
トークンはAIが文章を読み書きする文字のかたまりの単位です。
gpt-oss-20bの深さ0(短い会話)は225.8 tok/sです。
1時間休まず書き続けたと仮定すると、約81万トークンに相当します。
実際のチャットでは入力や読む時間が挟まるので、そのまま1時間の成果にはなりません。
モデルごとの測り方と結果は、3本の実測記事にまとめています。
gpt-oss-20bの実測記事・Gemma 4 26B-A4Bの実測記事・Qwen3.8-27Bの実測記事です。
学習(ファインチューニング)の実測は、当サイトの記事の段落1,000件を教材にしたQwen3.5-9Bの練習です。
学習に使ったQLoRAは、メモリの使用量を抑えながらモデルに追加で練習させる方法です。
学習そのものは211.3秒(3分31秒)。
モデルの読み込みは29.6秒、VRAMのピークは約13.9GB。
以上が実測結果です。
試運転での最初の読み込みは、初回のモデルのダウンロードを含めて1,414秒かかっています。
1,414秒は平均ではなく、ダウンロード込みの1回の実例です。
nvidia-smiで計測したGPU単体の電力は、推論でも学習でもおおむね200〜300Wでした。
「料金表に出にくい費用」の電気代は、GPU単体の消費電力を使った目安です。
クラウドGPUの料金の見方
- 料金は「時間単価」と「ディスク代」の2本立て
- RunPodにはCommunityとSecureの2種類の値段が並ぶ
- 保存領域(ディスク)は止めた後も課金が続くことがある
クラウドGPUの料金は、作業台を借りる「時間単価」と、データを置く「ディスク代」の2本立てです。
個人が借りる代表としてRunPod、技術者向けとしてAWSの公式料金を2026年10月10日に取得しました。
RunPodの料金ページ(runpod.io/pricing)には、同じGPUに2種類の値段が並びます。
Community CloudとSecure Cloudの2種類です。
違いの説明は料金ページに無いため、本文では両方の値で試算します。
RTX 5070 Tiは料金ページに載っていないため、24〜48GBのGPUの料金を並べます。
表の見方は、左からGPU、VRAM、Community、Secureの1時間あたりの円換算です。
為替は2026年10月9日公表のTTM(売値と買値の中間の為替相場・1ドル158.17円)で換算しています。
| GPU | VRAM | Community(1時間) | Secure(1時間) |
| RTX 3090 | 24GB | 34.8円 | 79.1円 |
| RTX 4090 | 24GB | 53.8円 | 117.0円 |
| L4 | 24GB | 69.6円 | 77.5円 |
| RTX 5090 | 32GB | 109.1円 | 156.6円 |
| A40 | 48GB | 55.4円 | 77.5円 |
| L40S | 48GB | 125.0円 | 172.4円 |
借りたコンピューター(インスタンス)の保存領域(ディスク)の料金も、稼働中か停止中かで変わります。
Volume Diskは、停止中でも1GB・1か月あたり0.20ドルと、稼働中(0.10ドル)の2倍の料金がかかります。
Network Storageは1TB未満が1GB・1か月あたり0.07ドルで、Volume Diskより安く置けます。
AWSは、東京リージョンのGPU付きインスタンス(G6・G6e)の料金を公式ページから取得しました。
使った分だけ払うオンデマンド料金です。
表の見方は、左からインスタンス、GPU、Linuxの1時間あたりの円換算です。
| インスタンス | GPU | Linux(1時間) |
| g6.xlarge | L4 24GB×1 | 184.6円 |
| g6.2xlarge | L4 24GB×1 | 224.3円 |
| g6e.xlarge | L40S 48GB×1 | 426.9円 |
| g6e.2xlarge | L40S 48GB×1 | 514.3円 |
AWSのディスク(EBS gp3)は東京リージョンで1GB・1か月あたり0.096ドルです。
AWSの1時間あたりの料金は、同じGPUを積んだRunPodの料金より高めです。
データ転送料は取得しておらず、LLMとの文字のやり取りは量が小さいため、本文では金額を書きません。
Google Colabは、時間単価ではなく月額で計算量(コンピューティング ユニット)を買う方式です。
Colab Proは月1,179円。
Colab Pro+は月5,767円。
以上が月額料金です。
1時間あたり何単位減るかを公式ページから読み取れず、時間あたりの費用を算出できません。
Colabは本文の時間単価の比較表には入れていません。
クラウドGPUで使うときの流れと、片づけ方で変わる料金
手元のPCなら、LM Studioのようなアプリにモデルを読み込めば使い始められます。
クラウドGPUでは、借りたコンピューター(インスタンス)に、使うソフトとモデルを用意するところから始まります。
RunPodには、ソフトを入れた状態ですぐ起動できる「ひな形」(テンプレート)があり、RunPodが管理する公式のひな形も用意されています(RunPod公式ドキュメント)。
使い終わったあとの片づけ方で、次に使うときの手間と、使っていない間の料金が変わります。
RunPodでは、GPUの時間代も保存領域の料金も秒単位で計算されます(RunPod公式ドキュメント)。
インスタンスを止める(Stop)と、GPUは手放され、GPUの時間代は止まります。
ただし、保存領域に残したモデルや設定には、置いている間ずっと料金がかかります。
RunPodの保存領域は3種類です。
止めると中身が消えるContainer Disk、止めても残るVolume Disk、インスタンスを削除しても残るNetwork Storage(RunPod公式ドキュメント)。
表の見方は、左から片づけ方、残るもの、使っていない間の料金(100GBを置いた場合)、次に使うときの手間です。
| 片づけ方 | 残るもの | 使っていない間の料金 | 次に使うとき |
| 止める(Stop) | Volume Disk(/workspaceフォルダ)のデータ。Container Diskのデータは消える | 1GB・1か月0.20ドル(100GBで約3,163円) | 続きから使える。GPUの空きが変わっていると、GPUなしで起動することがある |
| 削除する(Terminate) | Network Storageに置いたもの以外は残らない | かからない | ソフトとモデルの用意からやり直し。用意する待ち時間にもGPUの時間代がかかる |
| モデルをNetwork Storageに置き、インスタンスは削除する | Network Storageのデータ | 1GB・1か月0.07ドル(100GBで約1,107円) | 新しく借りたインスタンスにつないで使う |
この記事の月額の試算は、3つ目の置き方(Network Storageに100GB)で、ひと月置き続けた料金を含めています。
止めた状態でVolume Diskに100GBをひと月置くと、ディスク代は約3,163円に上がります。
使い終わるたびに削除する使い方なら、使っていない間のディスク代はかからない代わりに、毎回モデルを用意する時間の分だけGPUの時間代が増えます。
モデルを用意するのにかかった時間の実例は、「料金表に出にくい費用」の節で紹介します。
価格帯ごとに月額を比べる
- 16GB機(469,800円)は、月20〜60時間なら本体代に届くまで3年以上かかる借り方が多い
- 同じRunPodのRTX 5090で比べると、32GB機は本体代に届くまで16GB機の約2.5倍かかる
- 24時間つけっぱなしなら、16GB機は約4〜6か月、32GB機は約10〜15か月で本体代に届く
冒頭の4パターンに、「クラウドGPUの料金の見方」の料金を当てはめます。
比べるのは月額と、借りる料金の合計が本体代に届くまでの月数です。
月額には、モデルを置くディスク100GB分の料金を含めています。
ディスクはRunPodがNetwork Storage、AWSがEBS gp3の料金で計算しています。
月数は手元の電気代を引かない単純な目安で、電気代を引いた月数は「料金表に出にくい費用」の表に載せています。
16GB機(469,800円)
本体代は、計測機と同じ構成FRONTIER FRGKB860M/CG3の価格です。
2026年10月10日時点で469,800円(税込)でした。
表の見方は、左から借り方、A〜Dの各パターンの月額(かっこ内は本体代に届くまでの月数)です。
| 借り方 | A 月20時間 | B 月60時間 | C 月176時間 | D 月730時間 |
| RunPod RTX 4090 Community | 2,183円(215か月) | 4,334円(108か月) | 10,572円(44か月) | 40,365円(11.6か月) |
| RunPod RTX 4090 Secure | 3,448円(136か月) | 8,130円(58か月) | 21,707円(21.6か月) | 86,551円(5.4か月) |
| RunPod RTX 5090 Secure | 4,239円(111か月) | 10,502円(45か月) | 28,667円(16.4か月) | 115,417円(4.1か月) |
| AWS g6.xlarge(L4)Linux | 5,211円(90か月) | 12,595円(37か月) | 34,011円(13.8か月) | 136,288円(3.4か月) |
| AWS g6e.xlarge(L40S)Linux | 10,056円(47か月) | 27,132円(17か月) | 76,653円(6.1か月) | 313,156円(1.5か月) |
週末や毎日2時間(月20〜60時間)なら、24〜32GBのGPUを借りる限り本体代に届くまで3年以上です。
最短のAWS g6.xlargeでも37か月です。
48GBのAWS g6e.xlargeだけは、月60時間で約17か月と早く届きます。
24時間つけっぱなし(D)になると、話が変わります。
RunPod RTX 4090なら、Community Cloudで約11.6か月。
Secure Cloudでは約5.4か月。
以上が本体代に届くまでの目安です。
同じ24時間つけっぱなしでも、借り先とプランで逆転の時期は数倍変わります。
32GB機(1,189,800円)
32GBの作業台にはRTX 5090が候補になります。
当サイトが毎日記録している構成では、FRONTIER FRMFGZ890/270Kがあります。
2026年10月10日時点で1,189,800円(税込・受注生産)で注文できました。
2026年10月13日時点では、記録しているRTX 5090デスクトップ5機種がどれも注文できない表示でした。
同じ日の夜には、FRMFGZ890/270Kの表示価格が1,279,800円(在庫なし)に変わっていました。
注文できない表示は戻ることもあるため、本文の価格は「10月10日に注文できた時点の価格」として扱います。
RTX 5090の電気代は、NVIDIA公式の公称値(グラフィックスカード総電力575W)を上限の目安に計算します。
RTX 5090は当サイトで実測していません。
電気代は公称値を使った計算です。
借りた5090と手元の5090は、同じ仕事を同じ時間でこなすものとして料金だけを比べます。
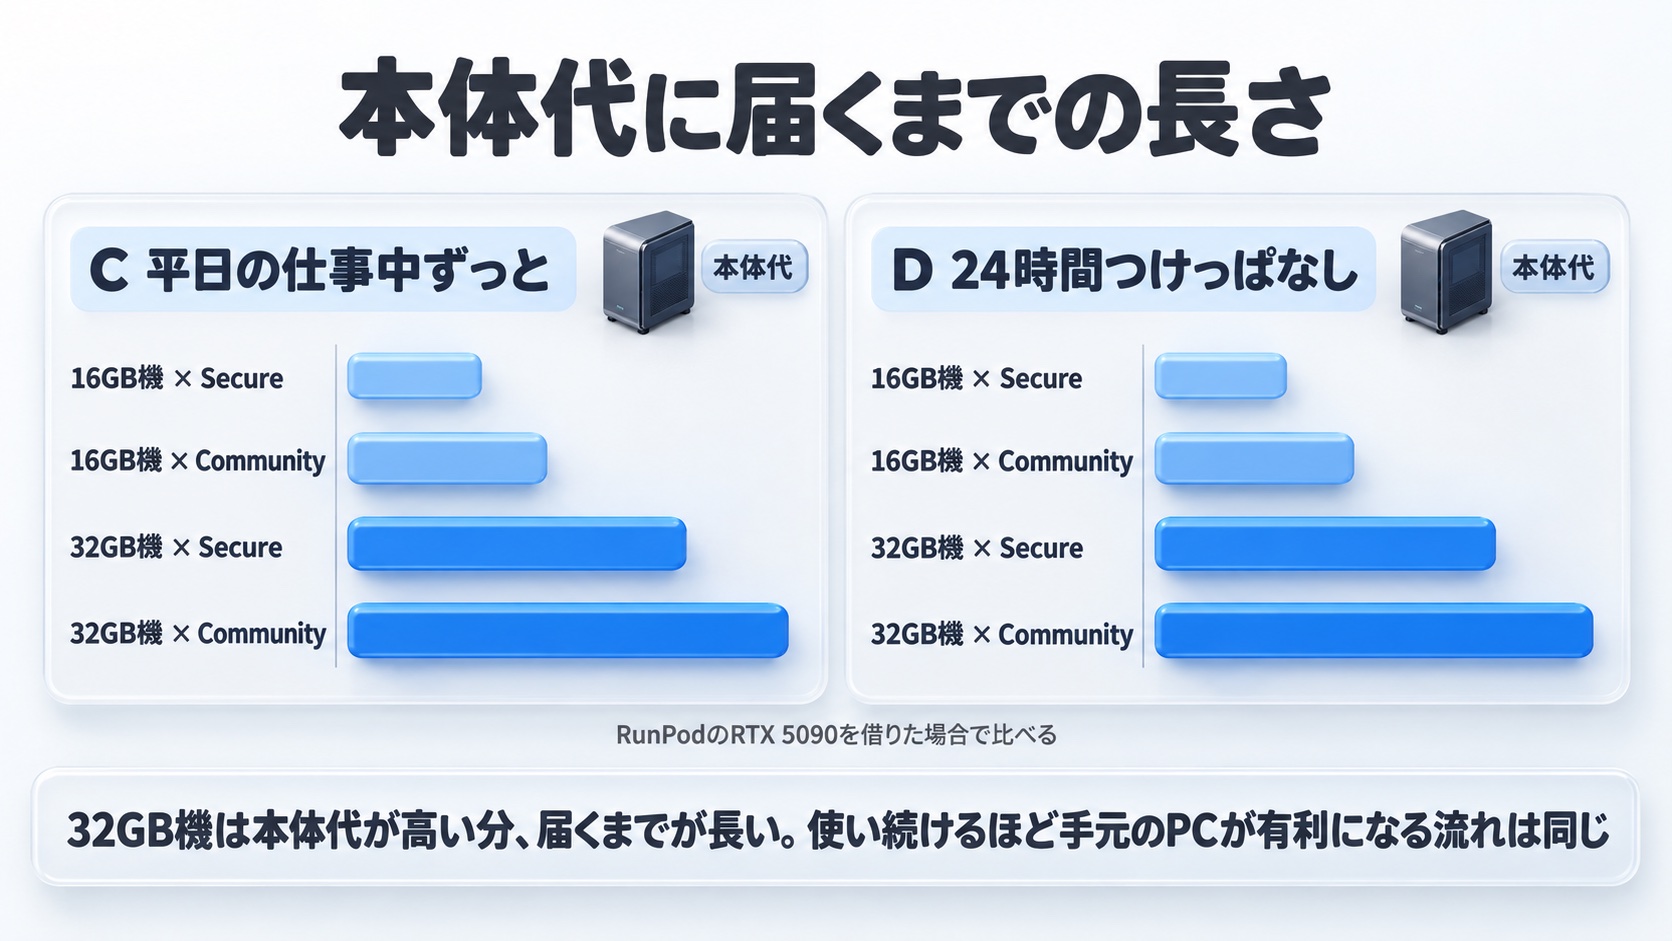
比べる相手を同じRunPodのRTX 5090にすると、32GB機は16GB機の約2.5倍の月数で本体代に届きます。
表の見方は、左からPC、借りる先、A〜Dの各パターンで本体代に届くまでの月数です。
| PC | 借りる先 | A 20時間 | B 60時間 | C 176時間 | D 730時間 |
| 16GB機 469,800円 | RunPod 5090 Community | 142.8か月 | 61.4か月 | 23.1か月 | 5.8か月 |
| 16GB機 469,800円 | RunPod 5090 Secure | 110.8か月 | 44.7か月 | 16.4か月 | 4.1か月 |
| 32GB機 1,189,800円 | RunPod 5090 Community | 361.6か月 | 155.4か月 | 58.6か月 | 14.7か月 |
| 32GB機 1,189,800円 | RunPod 5090 Secure | 280.7か月 | 113.3か月 | 41.5か月 | 10.3か月 |
月20〜60時間の人は、16GB機でも32GB機でも、本体代に届くまで長い期間がかかります。
32GB機はさらに長く、月60時間(B)でもCommunity Cloudで約155.4か月です。
24時間つけっぱなし(D)になると、32GB機でも約10.3〜14.7か月で本体代に届きます。
16GB機の約4.1〜5.8か月より長いのは、本体代が高い分だけです。
使い続けるほど手元のPCが有利になる流れは同じです。
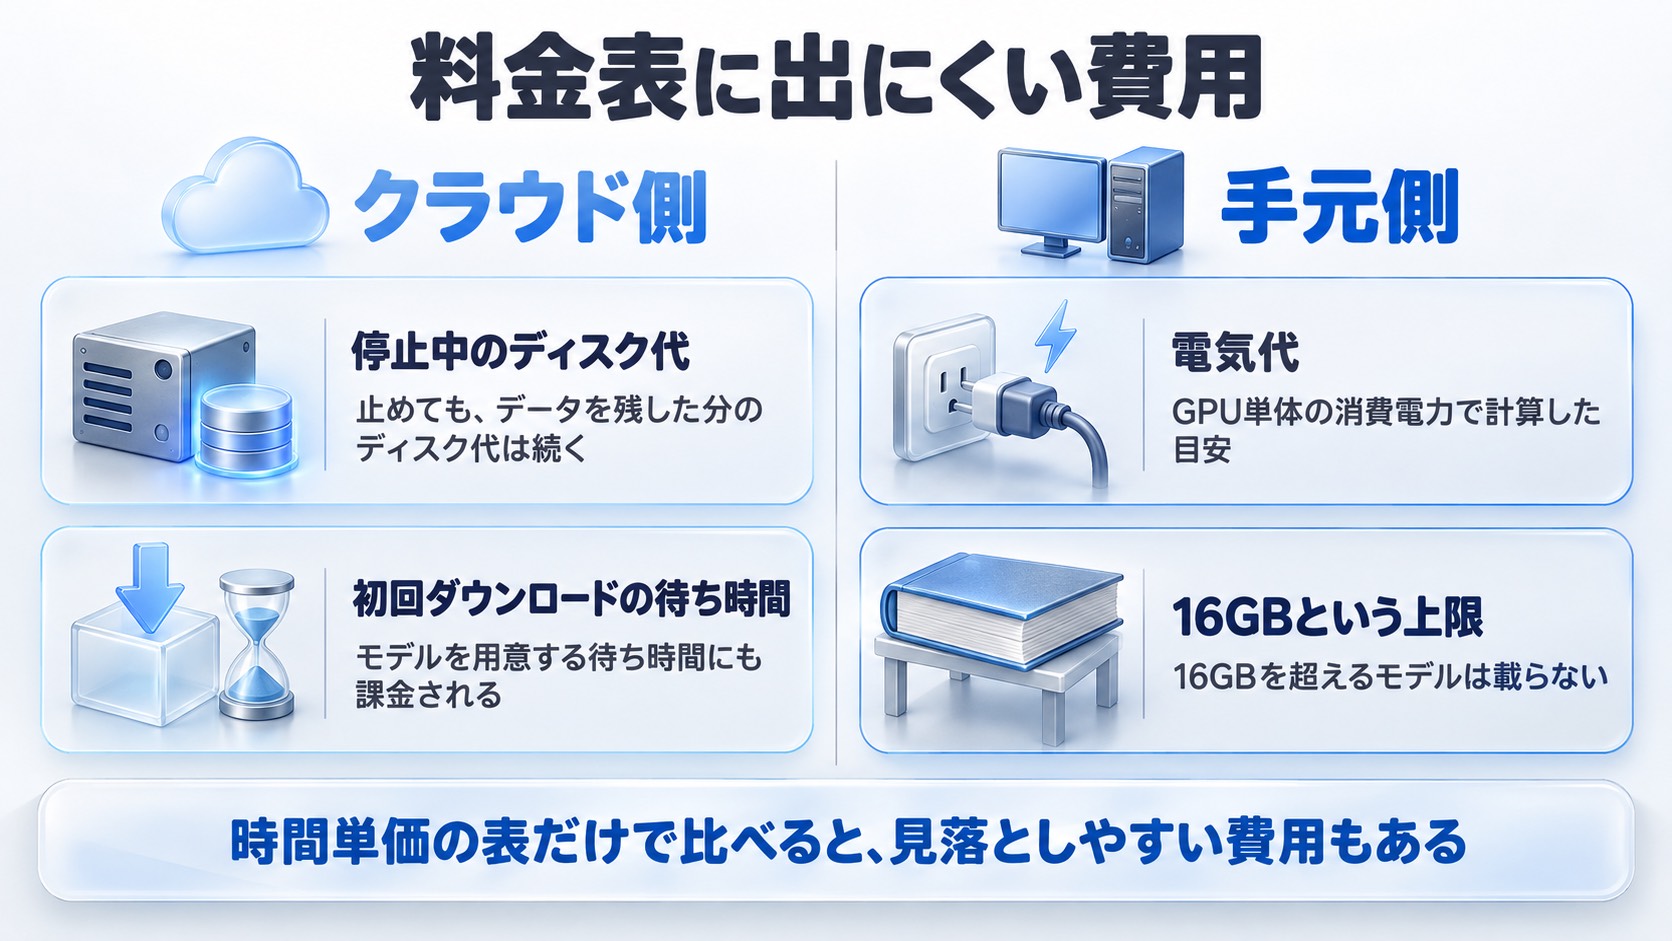
料金表に出にくい費用
- クラウド側:止めてもディスク代が続く・初回のモデルのダウンロードにも時間課金
- 手元側:電気代(16GBは実測300W・32GBは公称575W)・推奨される電源の容量
- 手元の電気代を引くと、本体代に届く月数は少し延びる
時間単価の表だけでは見落としやすい費用を、クラウド側と手元側に分けて見ていきます。
クラウド側でまず見落としやすいのが、保存領域(ディスク)の料金です。
RunPodのVolume Diskは停止中も1GB・1か月あたり0.20ドルかかります。
モデルのファイルを100GB置いたまま止めておくと、1か月あたり約3,163円かかる計算です。
Network Storageなら約1,107円、AWS gp3なら約1,518円です。
もう1つ見落としやすいのが、最初にモデルを用意する時間です。
当サイトの計測機で初めて9Bモデルを読み込んだ試運転では、ダウンロードを含めて1,414秒かかりました。
平均ではなく、ダウンロード込みの1回の実例です。
クラウドGPUは使った時間に対して課金されるため、まっさらな環境を借りるとモデルを用意する待ち時間にも課金されます。
学習211.3秒と読み込み29.6秒の1回は、RunPod RTX 4090 Secureで約8円です。
読み込みが1,414秒かかった1回では、約53円に増えます。
AWS g6.xlargeで同じ計算をすると、約12円から約83円です。
手元側で見落としやすいのは、電気代とシステムに必要な電力です。
16GB機の電気代は、GPU単体の消費電力(上限の約300W・実測)で計算しました。
月20時間で186円、月60時間で558円。
月176時間で1,637円、月730時間で6,789円。
以上が電気代の目安です。
32GB機の電気代は、NVIDIA公式の公称値(グラフィックスカード総電力575W)で計算しました。
月20時間で357円、月60時間で1,070円。
月176時間で3,137円、月730時間で13,012円。
以上が電気代の目安です。
いずれもGPU単体の値です。
PC全体の消費電力はCPU・メモリ・ファンの分だけ多くなりますが、測っていないので推定の値は書きません。
システムに必要な電源の容量も、GPUごとに公式の目安があります。
NVIDIA公式の「必要なシステム電力」は、16GB機(RTX 5070 Ti)が750W。
32GB機(RTX 5090)は1000W。
以上が電源容量の目安です。
手元に組む場合は、公式の目安を満たす電源ユニットが必要です。
手元の電気代を引くと、借りる料金の合計が本体代に届くまでの月数は少し延びます。
電気代はGPU単体の値で、PC全体ではさらに増えます。
実際に本体代へ届くまでの月数は、表より少し長くなります。
表の見方は、左からPC、借りる先、A〜Dの各パターンで本体代に届くまでの月数です。
| PC | 借りる先 | A 20時間 | B 60時間 | C 176時間 | D 730時間 |
| 16GB機 469,800円 | RunPod 5090 Community | 151.4か月 | 66.2か月 | 25.2か月 | 6.3か月 |
| 16GB機 469,800円 | RunPod 5090 Secure | 115.9か月 | 47.2か月 | 17.4か月 | 4.3か月 |
| 32GB機 1,189,800円 | RunPod 5090 Community | 405.6か月 | 180.7か月 | 69.3か月 | 17.6か月 |
| 32GB機 1,189,800円 | RunPod 5090 Secure | 306.5か月 | 126.1か月 | 46.6か月 | 11.6か月 |
電気代を引いても、大きな傾向は変わりません。
24時間つけっぱなしでRunPod 5090を借りる場合、16GB機は約4.3〜6.3か月。
32GB機は約11.6〜17.6か月。
以上が本体代に届くまでの目安です。
月60時間以下なら、どちらのPCでも3年以上かかる借り方が多くなります。
もう1つの上限は、作業台の広さそのものです。
「16GB機で1時間にできる仕事の量」で見たとおり、余白はわずかです。
32K文脈のGemma 4 26B-A4Bは、16GBのうち15.5GBまで使いました。
16GBを超えるモデルを扱いたい場面が増えてきたら、「組み合わせ方」の節が参考になります。
ChatGPT・Claudeの月額で足りる人、ローカルが要る人
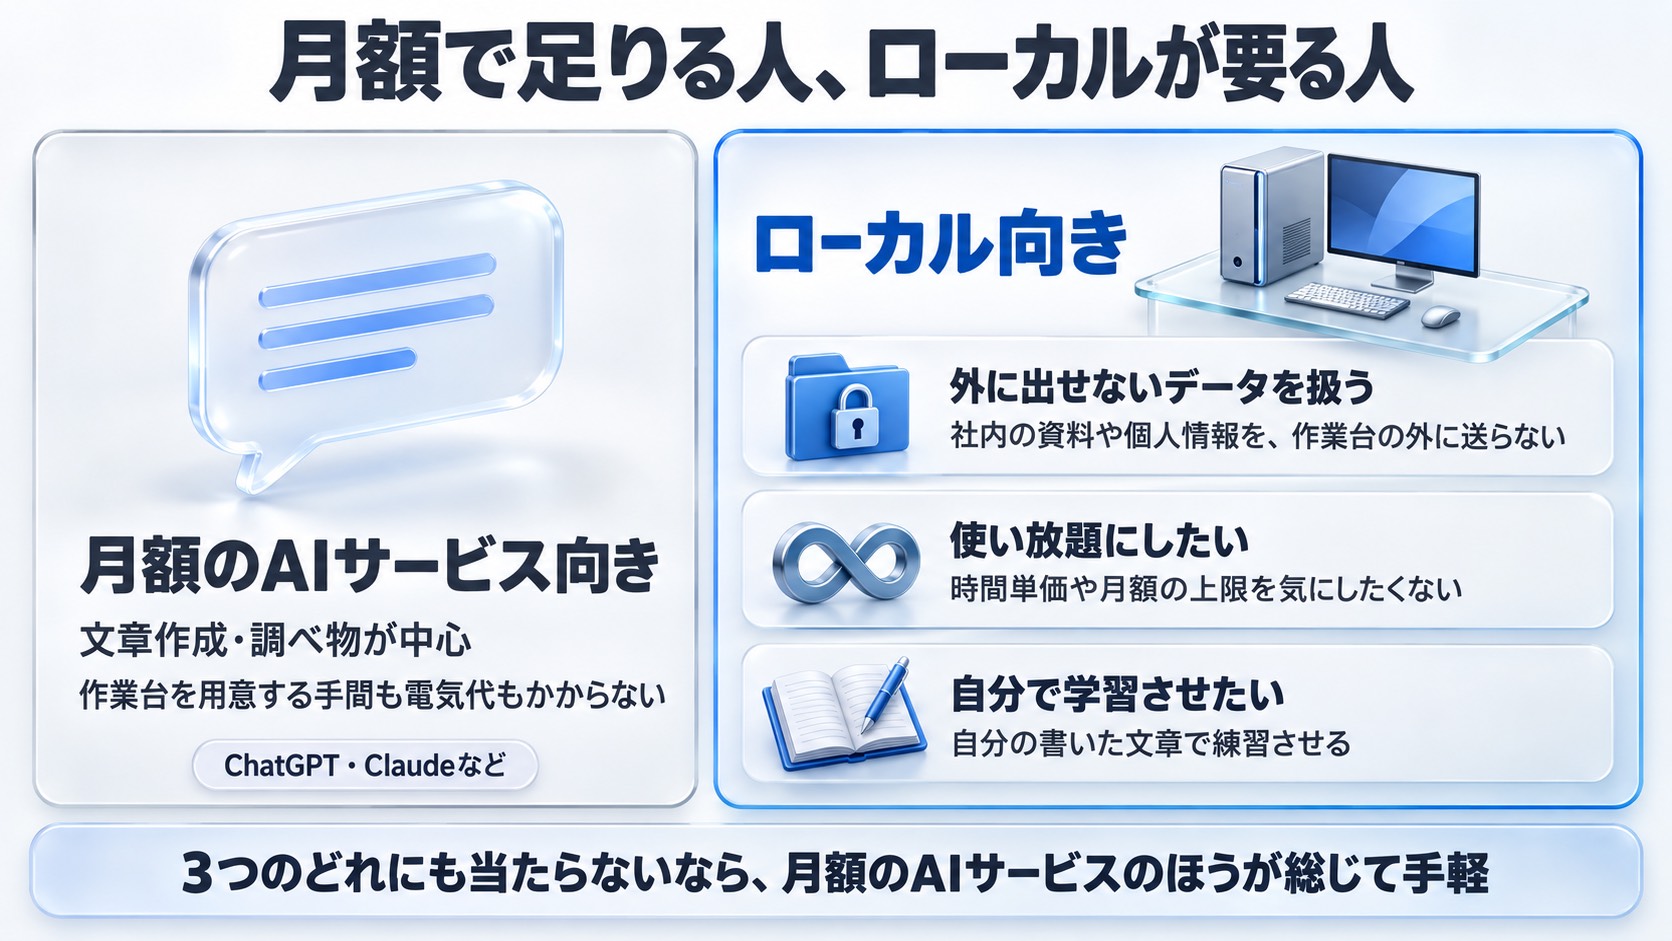
- 文章作成・調べ物が中心なら、月額のAIサービスのほうが手軽で高性能
- Claude Proは月20ドル(約3,163円)、Claude Maxは月100ドル(約15,817円)から
- ローカルが要るのは「外に出せないデータ」「使い放題」「自分で学習させる」の3つ
PCを買うかGPUを借りるかの比較では、作業台を自分で用意する前提でした。
しかし、多くの人にとって最初の選択肢は、作業台を持たずに答えだけを買う月額のAIサービスです。
Claudeの個人向けプランは、公式料金ページで確認しました。
確認日は2026年10月10日です(claude.com/pricing)。
Claude Proは月払いで20ドル(約3,163円)。
年払いなら1か月あたり17ドル(約2,689円)相当です。
Claude Maxは月100ドル(約15,817円)からです。
ChatGPTの個人向けプランは、2026年10月10日に料金画面で確認しました。
Goが月8ドル(約1,265円)。
Plusが月20ドル(約3,163円)。
Proは月100ドル(約15,817円)から。
以上がChatGPTの月額料金です。
月額のAIサービスは作業台を用意する手間も電気代もかからず、文章作成や調べ物なら高い性能をすぐに使えます。
ローカルLLMを選ぶ理由は次の3つに絞られます。
- 外に出せないデータを扱う:社内の資料や個人情報を、手元のPCの外に送らずに済ませたい場合
- 使い放題にしたい:月の使用時間が多く、時間単価や月額の上限を気にしたくない場合
- 自分で学習させたい:話し方や答えの形を、自分の書いた文章で練習させたい場合。当サイトでは16GBでQLoRA学習を実測した記事にまとめています
3つの理由のどれにも当たらないなら、月額のAIサービスのほうが総じて手軽です。
どれかに当たる人だけ、冒頭の早見表と月額の比較表で買うか借りるかを検討する価値があります。
組み合わせ方:毎日の分は手元、大きな仕事だけ借りる
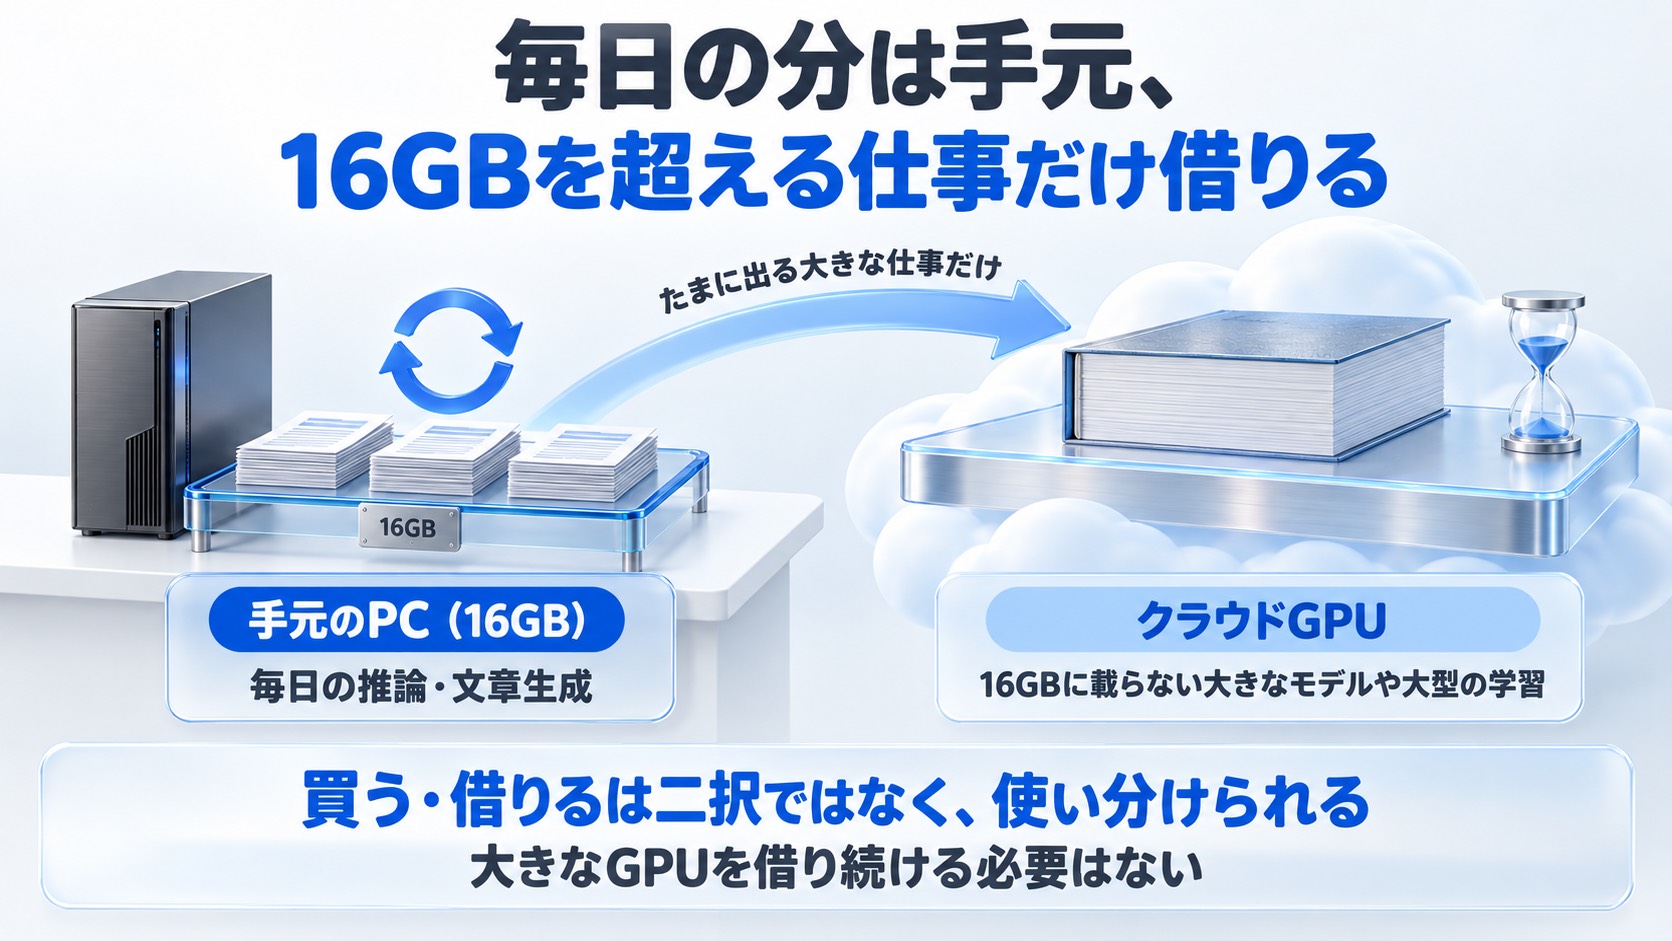
- 買う・借りるは二択ではなく、使い分けられる
- 毎日の推論は16GBの手元PCで、たまに出る大きな仕事だけクラウドに任せる
- 16GBを超える作業台がどうしても必要な人向けの実測記事もある
自家用車とカーシェアを両方使い分ける人がいるように、ローカルLLMとクラウドGPUも両方を組み合わせられます。
毎日の文章生成は手元の16GB。
16GBに載らない大きなモデルや大型の学習は、時間で借りるクラウドGPU。
仕事に応じて使い分けられます。
32GB機を自分で持つ代わりに、16GB機とクラウドGPUの組み合わせで足りる人もいます。
組み合わせて使えば、大きなGPUを借り続けずに済みます。
費用は月々の電気代と、たまに借りるクラウドの時間単価です。
16GBを超える作業台がどうしても必要な場面が多い人には、別の実測記事も参考になります。
1本目はメモリ32GBとStrataで16GBを超えるモデルを動かした記事。
2本目は大きなモデルを手元に置く選択肢を比べた記事です。
クラウドを都度借りるか、手元の作業台を大きくするかは、借りる頻度と「料金表に出にくい費用」を見比べて決めます。
RTX 5070 Ti搭載PCは、ローカルLLMだけでなくゲームにも使えます。
ゲームでの性能を確かめたい人は、RTX 5070 Tiのゲームfps実測記事でも確認できます。
ローカルLLM用PCの買い方
- 16GB機の例は当サイトの計測機と同じ構成。2026年10月10日時点で469,800円
- 32GB機は親記事の7選とRTX Spark記事で選び方を比較できる
- 初期費用が壁になる場合は、分割払いという選択肢もある
16GB機を買う場合
試算に使った当サイトの計測機は、FRONTIER FRGKB860M/CG3です。
構成はCore Ultra 7 265F・RTX 5070 Ti 16GB・メモリ32GB・SSD 1TBです。
2026年10月10日時点で、FRONTIER公式サイトの価格は469,800円(税込・受注生産)でした。
価格は変わることがあるため、購入前に公式サイトで最新の表示を確かめておくのがおすすめです。
32GB機を買う場合
RTX 5090搭載PCは、本体価格が高く、在庫の動きも大きいため、選ぶ前に候補を広く比べておくのがおすすめです。
使う目的に応じたVRAMの選び方は、ローカルLLMを動かすPCのスペックガイドにまとめています。
「何をしたいかで選ぶ3つのPC構成」と7選で、16GBと32GBの構成を比較できます。
RTX 5090の候補をさらに比べたい人は、RTX 5090と関連PCの候補を比べた記事も参考になります。
ローカルLLMをまだ始めていない人は、ローカルLLMとは・始め方のガイドから読むと流れがつかみやすくなります。
本体の初期費用が壁になるなら、分割払いも選択肢です。
回数ごとの支払い総額はメーカーで変わるため、分割で買う前に比べておくと安心です。
16GBクラスのGPUは、値上がりの気配があると当サイトでは見ています。
購入の時期を考えるときも、まず公式サイトで最新の価格を確かめておきたいところです。
まとめ
ローカルLLMとクラウドGPUの費用は、モデルの大きさ(16GBか32GBか)と使う時間で、安いほうが入れ替わります。
週末だけ、毎日2時間だけの人は、16GBでも32GBでもクラウドGPUを時間で借りるほうが長く安く済みます。
24時間つけっぱなしで動かす人は、借りる料金の合計が本体代を超える時期が来ます。
32GB機は本体代が高い分、本体代に届く時期が16GB機より後になります。
文章作成や調べ物が中心なら、月額のAIサービスのほうが手軽で高性能です。
ローカルを選ぶ理由は、外に出せないデータ・使い放題・自分で学習させる、の3つに絞られます。
停止中のディスク代や初回のダウンロード時間も、料金表に出にくい費用です。
ディスク代やダウンロード時間の費用も含めると、自分の使い方に合う選択肢が見えてきます。
よくある質問
ローカルLLMにはどれくらいのVRAMが要る?
動かしたいモデルの大きさで変わります。
当サイトの実測では、9B〜27Bの4モデルが16GBの作業台に収まりました。
当サイトで実測したモデルより大きなモデルを1枚のGPUに載せたいときは、32GB(RTX 5090)が候補になります。
RTX 5080なら大きなモデルも動く?
RTX 5080のVRAMは16GBで、RTX 5070 Tiと同じです(NVIDIA公式)。
作業台の広さが変わらないため、載せられるモデルの大きさもRTX 5070 Tiと同じ範囲になります。
速さの差は当サイトで測っていません。
クラウドGPUは月いくら?
借りるGPUと使う時間で大きく変わります。
当サイトの試算はディスク100GB込みです。
月60時間なら、RunPod RTX 4090のCommunity Cloudで4,334円。
Secure Cloudなら8,130円。
32GB機と同じRTX 5090を借りる場合、月60時間でCommunity 7,655円。
Secureなら10,502円。
以上が月額の試算です。
ローカルLLMの電気代は?
16GB機はGPU単体の消費電力(実測の上限約300W)で計算しました。
月20時間で186円、月730時間で6,789円です。
32GB機はNVIDIA公式の公称値(575W)で計算し、月20時間で357円、月730時間で13,012円です。
CPU・メモリ・ファンを含めたPC全体の消費電力は測っていません。
RunPodを止めてもお金がかかるのはなぜ?
Volume Diskに残したデータは、インスタンスを止めた後も課金が続く仕組みだからです。
RunPodの公式料金ページでは、Volume Diskの停止中の料金は1GB・1か月あたり0.20ドルです。
稼働中(0.10ドル)の2倍にあたります。
データを残したまま止めると、ディスク代だけは動き続けます。
ChatGPTの課金とどちらが安い?
ChatGPT Plusは月20ドル(約3,163円)。
Claude Proも月20ドル(約3,163円)。
以上が月額料金です。
ChatGPTには月8ドル(約1,265円)のGoもあります。
文章作成や調べ物が中心なら、月額サービスのほうが手軽です。
ローカルを選ぶ理由は、外に出せないデータ・使い放題・自分で学習させる、の3つです。
RTX 5060 Tiを複数枚にする方法は当サイトでおすすめしている?
おすすめとして紹介しているわけではありません。
llama.cppの公式ドキュメントが説明する使い方として紹介しています。
GPU間の接続速度次第で1枚より遅くなることもあると、公式に書かれています。
当サイトは複数枚の構成を検証していません。
16GBに載らないモデルはどうする?
選択肢は、32GB以上のGPUを買うか、クラウドで時間借りするか、手元の作業台を大きくするかです。
手元を大きくする場合は、2本の記事が参考になります。
メモリ32GBとStrataで16GBを超えるモデルを動かした記事と、大きなモデルを手元に置く選択肢を比べた記事です。
試算条件の一覧
- 公式料金の取得日:2026年10月10日(本文中の各表に個別の出典を記載)
- 為替:1ドル158.17円(三菱UFJリサーチ&コンサルティング「外国為替相場」2026年10月9日公表のTTM)
- 電気代の単価:31円/kWh(全国家庭電気製品公正取引協議会の目安・税込)
- 16GB機の本体代の基準:FRONTIER FRGKB860M/CG3・469,800円(税込・2026年10月10日時点・FRONTIER公式サイト)
- 32GB機の本体代の基準:FRONTIER FRMFGZ890/270K・1,189,800円(税込・2026年10月10日時点に注文できた価格・FRONTIER公式サイト)。2026年10月13日時点では、当サイトが記録するRTX 5090デスクトップ5機種はいずれも注文できない表示。同日夜のFRMFGZ890/270Kの表示価格は1,279,800円(在庫なし)
- GPUのVRAMと消費電力:NVIDIA公式(RTX 5090=32GB・575W/RTX 5080=16GB・360W/RTX 5070 Ti=16GB・300W/RTX 5060 Ti=16GB・8GB・180W)
- 16GB機のGPU電力:単体の値(nvidia-smi計測)。32GB機のGPU電力:NVIDIA公式の公称値。いずれもPC全体の消費電力は未計測
- 推論速度の実測:2026年9月3日・llama-bench・3回の中央値(RTX 5070 Ti 16GB)
- 学習時間の実測:2026年10月5日・Qwen3.5-9B・QLoRA・1,000件・1周(RTX 5070 Ti 16GB)
- 複数GPUの説明の出典:llama.cpp公式ドキュメント(multi-gpu.md)。速さは当サイト未検証
- 増設の保証に関する出典:FRONTIER公式の保証規定・第11条
- クラウドGPUの片づけ方とデータの残り方・秒単位の課金の出典:RunPod公式ドキュメント(Storage types・Pricing・Manage Pods・Templates、2026年10月13日取得)
- 速度の比較範囲:当サイトはRTX 5070 Tiのみ実測。クラウド側GPU・RTX 5090・RTX 5080・RTX 5060 Tiとの速度比較はしていない