Strata(ストラータ)とは?対応GPU・Mac・必要なメモリと使い方【2026年】
「125B、1250億パラメータのAIが家のゲーミングPCで動く」という話を見かけて、Strata(ストラータ)に興味を持った人は多いはずです。
自分のGPUで動くのか、Macでも使えるのか、メモリは何GB要るのかが気になるところです。
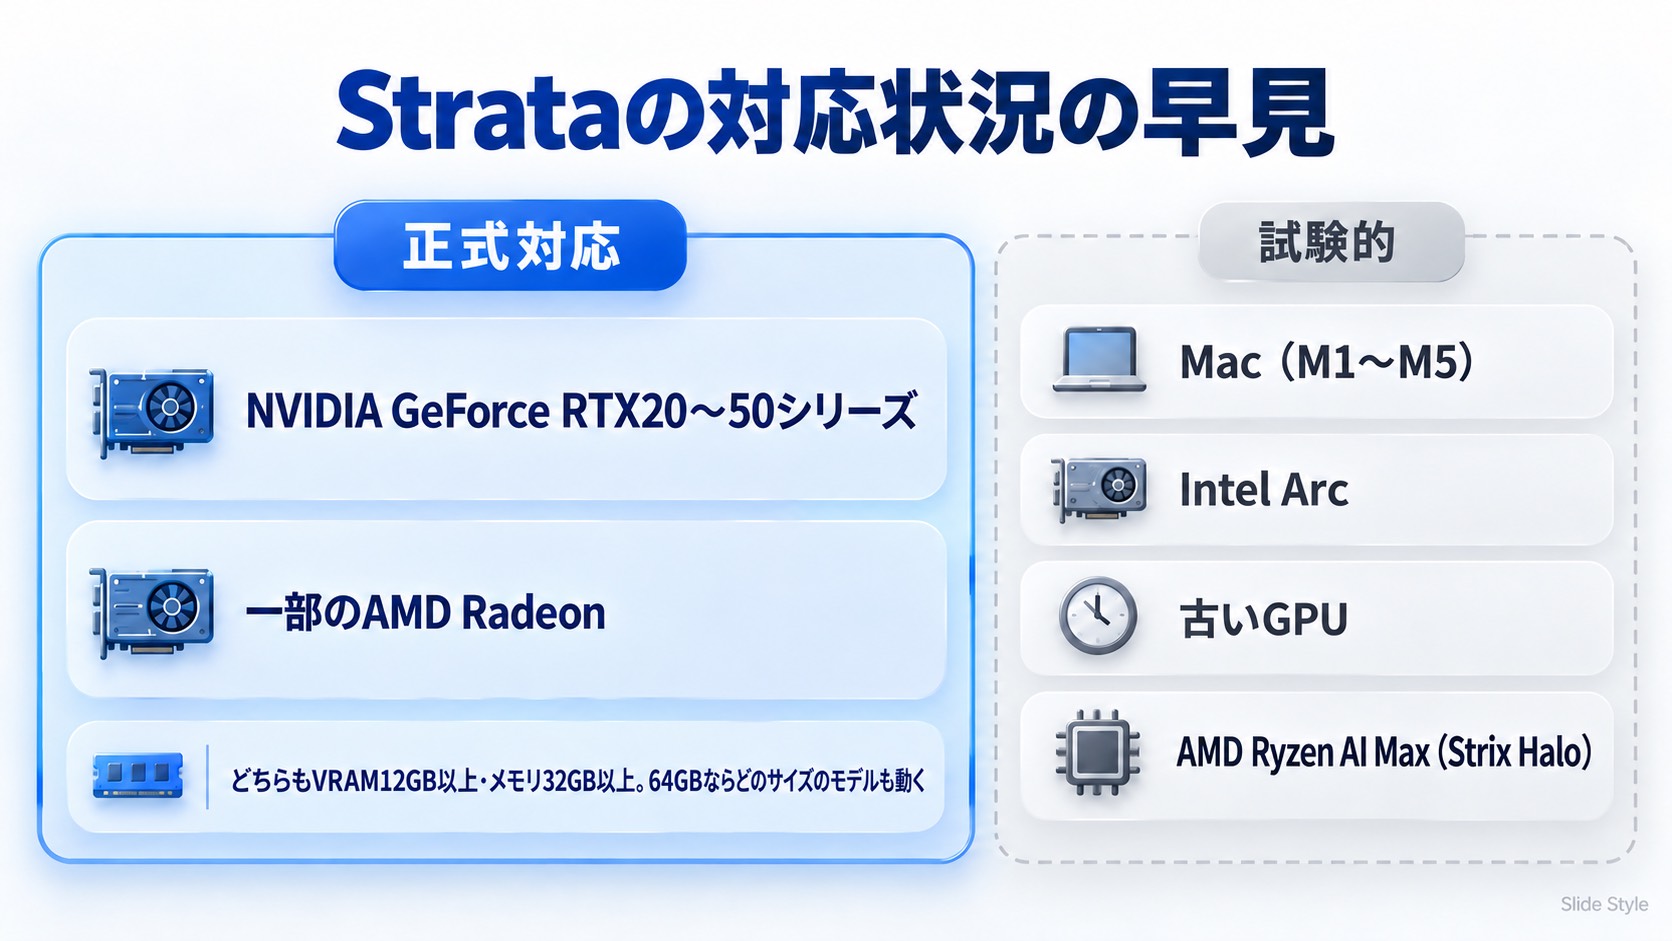
結論から言うと、GeForce RTX20〜50シリーズならVRAM12GB以上、メモリ32GB以上のパソコンで動き、MacとIntel Arcは試験的な対応です。
- 正式に対応するのはNVIDIA GeForce RTX20〜50シリーズと一部のAMD Radeon(VRAM12GB以上)
- メモリは32GB以上が必要。64GBならどのサイズのモデルも動く
- MacはM1〜M5(macOS15以上)に2026年10月13日の更新から試験的に対応
- Intel Arcは試験的(Linuxでソースから組み立てる形)。コミュニティの報告では出力約21〜78 tok/s(tok/sは1秒あたりに出す言葉のかたまりの数)
この記事は、Strata公式GitHub(README・docs内の各資料・リリースノート)を2026年10月16日に確認した内容をもとにまとめています。
Strataは公開から約3週間で51回更新されていて、対応範囲が速いペースで広がっています。
版ごとに変わる数値や対応状況は、次の表にまとめています。
Strataの最新の対応状況【2026年】
| 項目 | 内容 |
| 最新版と日付 | v0.1.44.1(2026年10月14日) |
| 正式に対応するGPU | NVIDIA GeForce RTX20〜50シリーズ、 AMD Radeon RX7900 XT/XTX・ RX7800 XT/7700 XT・ RX9060 XT・RX9070/9070 XT・ Radeon AI PRO R9700・ RX6800/6900シリーズ(VRAM12GB以上) |
| 必要なメモリとディスク | メモリ32GB以上 (64GBならどのサイズも動く)、ディスクは約80GBの空き |
| OS | Windows10/11またはLinux(最新のGPUドライバーが必要) |
| 試験的な対応 | 旧世代GPU、Intel Arc(Linuxでソースから組み立て)、 Mac(M1〜M5・2026年10月13日の更新から)、 AMD Ryzen AI Max(Strix Halo・Linuxでソースから組み立て)、 NVIDIA DGX Spark(Linux・対応一覧には無く、リリースノートで動作と高速化を案内) |
| 動くモデル | Qwen3.8-Flash-Next(125B)、 Qwen3.6-35B-A3B( NVIDIAとAMDのみ・2026年10月13日の更新から) |
| 確認日 | 2026年10月16日 |
Strataは更新が速いため、「最新の対応状況」の表を確認日ごとに更新します。
- 正式に対応するGPUとVRAMの条件は、表の「正式に対応するGPU」の行で確認できる
- Mac・Intel Arcなどの対応の段階は、表の「試験的な対応」の行にまとめる
- 版ごとに変わる数値や対応状況は「最新の対応状況」の表にまとめる
Strataで動かせるモデル
Strataで動かせるモデルは、1つの大きなモデルとその派生版、そして2026年10月13日に加わった別のモデルの4種類です。
どのGPU・Macで動くかはモデルごとに違うため、下の表にまとめています。
| モデル | どんなモデルか | NVIDIA・AMD(正式) | Intel Arc(試験的) | Mac(試験的) |
| Qwen3.8-Flash-Next(125B) | 標準のモデル。チャット・コード・画像の読み取りに使う | 〇 | 〇(IQ2_XSで動作報告) | 〇(Unslothの圧縮版を含む) |
| Coder | 専門家(エキスパート)を半分にしたコード向けの版 | 〇 | 〇(IQ1_Mで動作報告) | ×(未対応) |
| Swift 1.5 | 考える時間を短くして、答えが早く出るように調整した版 | 〇 | 資料に報告なし | ×(未対応) |
| Qwen3.6-35B-A3B | 2026年10月13日の更新で加わった別のモデル。メモリ32・44・52GBを目安に版が自動で選ばれる | 〇 | × | × |
Strataとは?
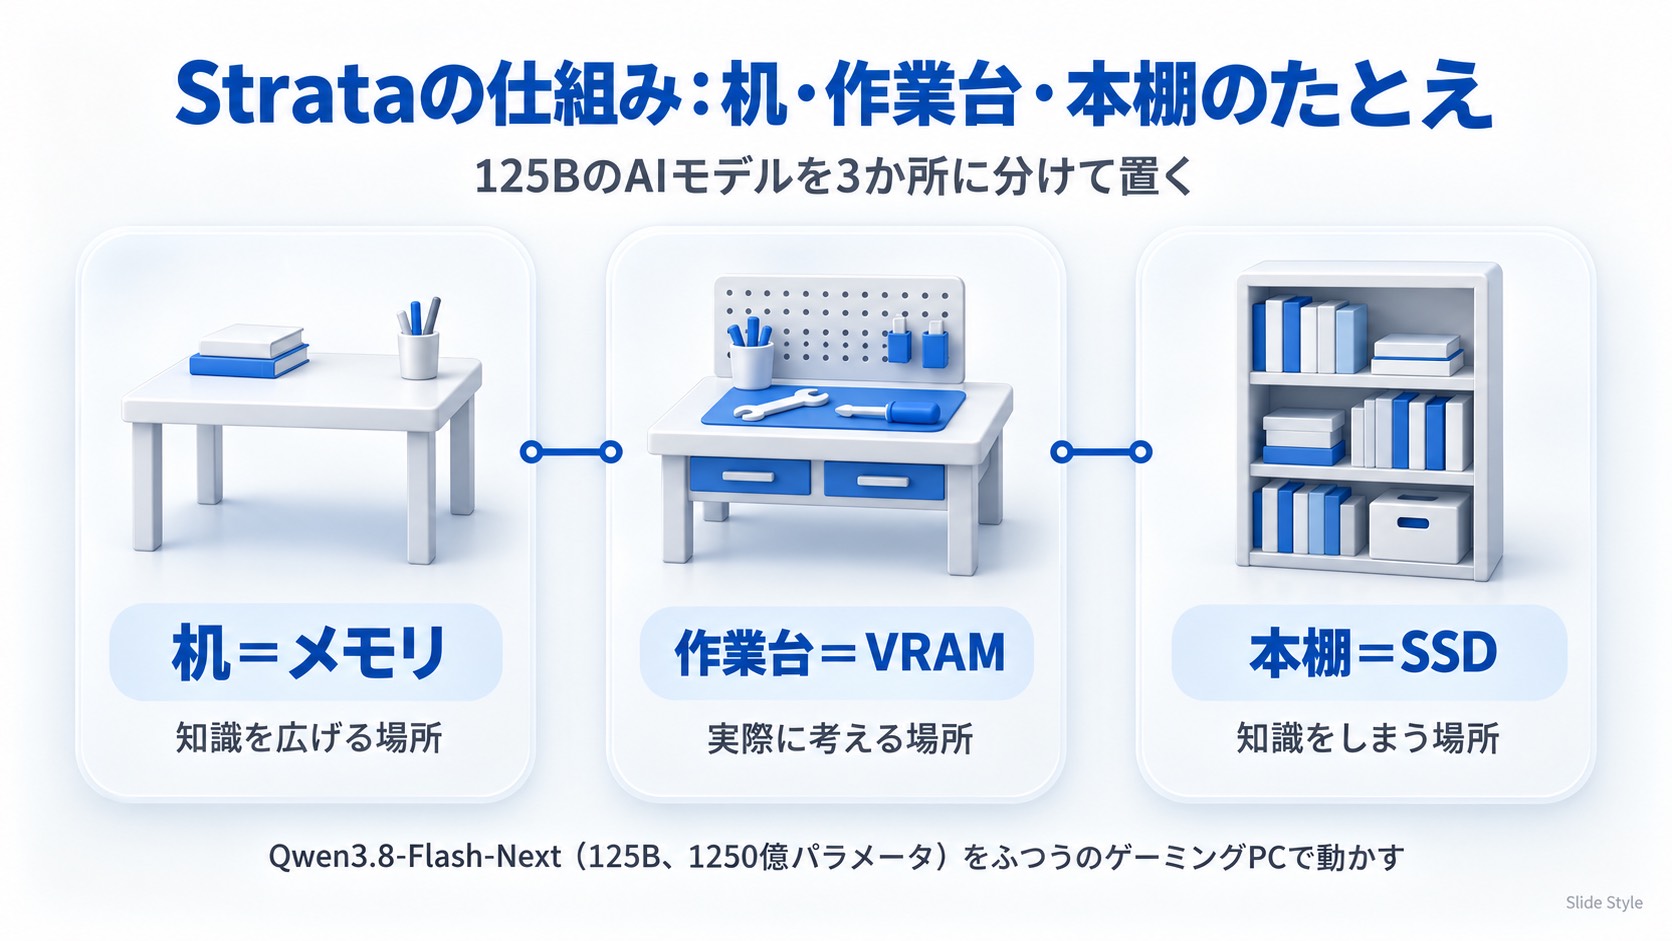
AIを「分厚い百科事典を持つ物知り」にたとえると、知識を広げる机がパソコンのメモリ、作業台がVRAM、知識をしまう本棚がSSDにあたります。
Strataは、Qwen3.8-Flash-Next(125B、1250億パラメータ)という大きなAIモデルを、ふつうのゲーミングPCで動かすプログラムです。
チャット・コードの作成・画像の読み取り・コーディング用のAIツールとの連携に使え、開発元は「データはパソコンの外に出ない」と説明しています。
アプリではなくプログラム
Strataは、スマホのアプリのようにアイコンから開くのではなく、起動用のファイルを動かして使うプログラムです。
Windowsならバッチファイル(START-HERE.bat)、LinuxやMacならシェルスクリプト(setup.sh)を動かして起動し、起動後はブラウザでチャット画面を開いて使います。
起動に使った窓を閉じると、Strataも止まります。
この段落に出てくる言葉を、かんたんにまとめます。
- バッチファイル(START-HERE.bat):Windowsで、決まった手順をまとめて自動で進めるファイル。ダブルクリックすると、Strataの準備と起動が順番に進みます
- シェルスクリプト(setup.sh):LinuxやMacで同じ役目をするファイル。ターミナル(文字で命令を打つ画面)から
./setup.shと打って動かします - 起動に使った窓:バッチファイルやシェルスクリプトを動かしたときに開く、黒い背景に文字が流れる画面。Strataが動いている間は開いたままにしておきます
- ブラウザ:ChromeやEdge、SafariなどのWebサイトを見るソフト。Strataの操作画面はブラウザの中に開きます
- チャット画面:ブラウザで
http://127.0.0.1:8080を開くと出てくる、AIに質問を打ち込む画面。この住所は自分のパソコンの中だけを指すため、やり取りはパソコンの中で完結します
無料・オープンソース・データはPCの外に出ない
Strata本体は無料・オープンソース(MITライセンス)で公開されています。
AIモデル自体や一部の部品には、別のライセンスが付きます。
主に動かすAIモデルは、Qwenチームが作ったQwen3.8-Flash-Next(125B)です。
2026年10月13日の更新からは、NVIDIA・AMDのGPUでQwen3.6-35B-A3Bも動かせます(モデルごとの対応は「最新の対応状況」の表の下にまとめています)。
圧縮にはISTA-DASLab・UkisAI・Unslothの技術が使われています。
開発元はREADMEで「Nothing leaves your PC(パソコンの外には何も出ない)」と説明しています。
- Strataは125BのAIモデルをゲーミングPCで動かす無料・オープンソースのプログラム
- アプリではなく、バッチファイルやシェルスクリプトで起動してブラウザで使う
- データはパソコンの外に出ないと開発元が説明
対応するGPU・PC
正式に対応するGPU
| メーカー | 対応シリーズ |
| NVIDIA | GeForce RTX20・30・40・50シリーズ |
| AMD | Radeon RX7900 XT/XTX、RX7800 XT/7700 XT、RX9060 XT、RX9070/9070 XT、Radeon AI PRO R9700、RX6800/6900シリーズ |
表のGPUには、VRAM(画面を描くための専用メモリ)の容量の条件が付きます。
条件の数値は表の注記と「最新の対応状況」の表のとおりで、パソコン側のメモリの条件も同じ表にまとめています。
VRAM8GBのGPU(RTX4060など)は?
Strataの正式な対応の条件はVRAM12GB以上です。
RTX4060などVRAM8GBのGPUは、VRAM容量の条件には当てはまりません。
開発元の資料には、VRAM8GBのGPUを対象にした動作や速度の記載はありません。
Intel Arc(試験的)
Intel Arcは、2026年10月4日の更新(v0.1.39)で試験的なエンジン(SYCL・Intel oneAPI)が追加されました。
完成品の配布は無く、Linux環境でソース(プログラムの設計図)から組み立てて使います。
開発元のリリースノートでは「official Intel Arc support」という表現も使われていますが、READMEとIntel Arc向けの資料では「experimental(試験的)」とされていて、対応の位置づけは、資料ごとに表現が異なります。
動作報告はコミュニティからのもので、Arc Pro B70 32GB(コード向けの版・出力70〜78 tok/s)、Arc Pro B50 16GB(出力約23 tok/s)、Arc B580 12GB(WSL2上・出力約21 tok/s、デバイスが切れる不具合も発生)などが挙がっています。
2026年10月7日の更新では、開発元自身がArc Pro B70とA750で動作を確認したと案内しています。
Windows環境での組み立て手順や、CPUに内蔵されたIntel Arcでの動作確認は、開発元の資料にありません。
古いGPU・Strix Halo(試験的)
Tesla P40・V100、GeForce GTX10シリーズ、Radeon VII・MI50、RX6700 XT・RX5500 XTなどの旧世代GPUも、コミュニティの実装により試験的に対応しています。
AMDのRyzen AI Max(Strix Halo)も、Linux環境でソースから組み立てる形での試験的な対応です。
NVIDIAのDGX Spark(GB10)はREADMEの対応一覧には載っていませんが、2026年10月7日のリリースノートで、DGX SparkのLinux環境では長い質問の読み込みが最大10倍速くなったと案内されています。
DGX SparkのCPUはArm、GPUの計算はNVIDIAのCUDAで動きます。CUDAの役割はCUDAとは何かの解説にまとめています。
AVX2に対応していない古いCPUでも動きますが、開発元は速度が遅くなると説明しています。
- 正式に対応するのは表のGeForce・Radeonで、VRAMの容量に条件がある
- VRAM8GBのGPUは正式対応の条件に当てはまらない
- Intel Arc・旧世代GPU・Strix Halo・DGX Sparkは試験的。速度はコミュニティの報告
Macで使う(M1〜M5)
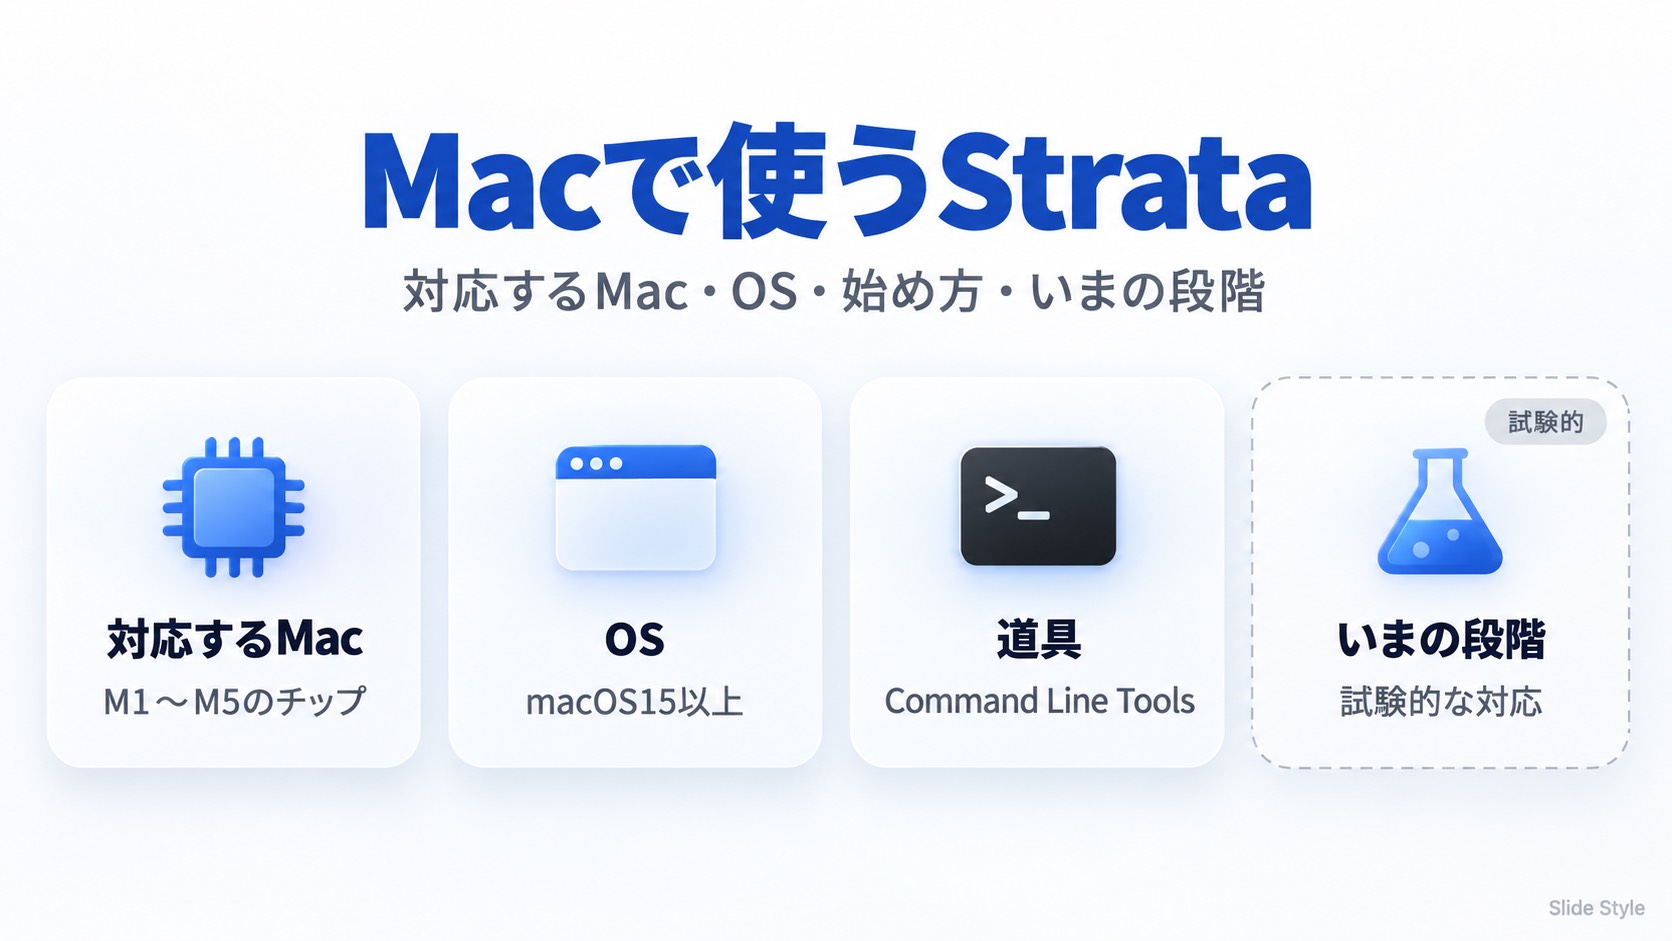
大きなAIを手元のパソコンで動かすStrataは、2026年10月13日の更新(v0.1.44)でMacにも対応しました。
Macへの対応前は、NVIDIA・AMD・IntelのGPUを積んだWindowsやLinuxのパソコン向けでしたが、Appleシリコン(Mシリーズのチップ)を積んだMacでも動くようになっています。
開発元は「新しく、試験的」な対応と位置づけていて、今後の更新で変わる部分もあります。
Macで使う条件
- チップ:M1〜M5(Appleシリコン)。Intelチップを積んだMacは対象外
- OS:macOS15以上
- 道具:Command Line Tools(Xcode本体は不要)
- ディスクの空き:モデルのダウンロードに66〜84GB+約7GB。SSDから読みながら動かすMacはさらに34〜40GB
- モデルの置き場所:Mac内蔵のSSD(外付けSSDは開発元が未テスト)
開発元が実際に測ったMacは、M5 Max(メモリ128GB)とM4 Mac mini(メモリ32GB)の2台です。
ほかのチップやメモリ量は、開発元ではまだ試されていないため、手持ちのMacで使うときは最新版を入れておくと安心です。
M2などで答えがおかしくなる不具合は、2026年10月14日の更新(v0.1.44.1)で修正されました。
Macのメモリ別の目安
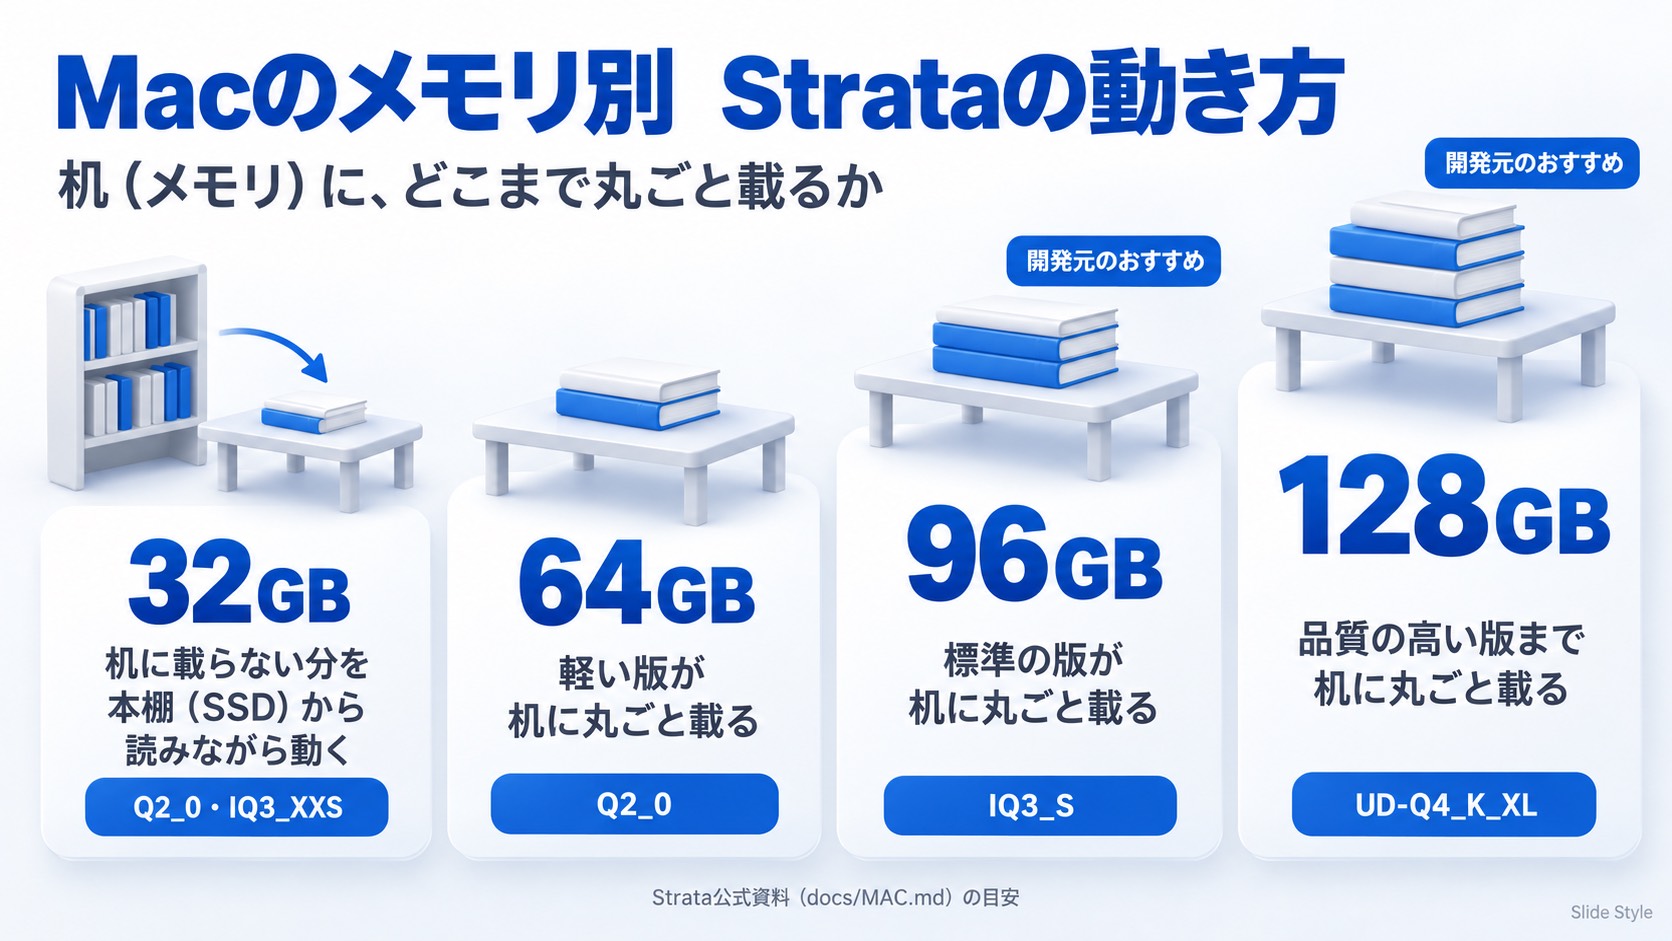
| Macのメモリ | 動き方 | 目安の版 |
| 32GB | 机(メモリ)に載らない分を本棚(SSD)から読みながら動く(M4 Mac miniで計測) | Q2_0・IQ3_XXS |
| 64GB | 軽い版が机に丸ごと載る | Q2_0 |
| 96GB | 標準の版が机に丸ごと載る | IQ3_S(開発元のおすすめ) |
| 128GB | 品質の高い版まで机に丸ごと載る(M5 Maxで計測) | UD-Q4_K_XL(開発元のおすすめ) |
版(Q2_0・IQ3_Sなど)は、百科事典を縮小コピーで薄くした度合いのちがいです。
薄い版ほど少ないメモリで動き、厚い版ほど答えの質が元のモデルに近づきます。
32GBのMacでも動かせるのはStrataの特徴で、開発元の数値では1秒に8〜14トークンほど出ます(空いているメモリの量で変わる値)。
16GBや24GBのMacについては、開発元の資料に計測の記載がありません。
Strata以外のアプリ(OllamaやLM Studio)も含めたMacのメモリ別の目安と、RTX機との費用の比べ方は、MacでローカルLLMを動かす記事で解説しています。
速さ(開発元の数値)
| Mac | 版 | 答えを書き出す速さ |
| M5 Max・128GB | Q2_0 | 107〜114トークン/秒 |
| M5 Max・128GB | IQ3_S | 95〜103トークン/秒 |
| M5 Max・128GB | UD-Q4_K_XL | 74〜94トークン/秒 |
| M4 Mac mini・32GB | Q2_0 | 13.5〜14.1トークン/秒 |
| M4 Mac mini・32GB | IQ3_XXS | 9.2〜10.0トークン/秒 |
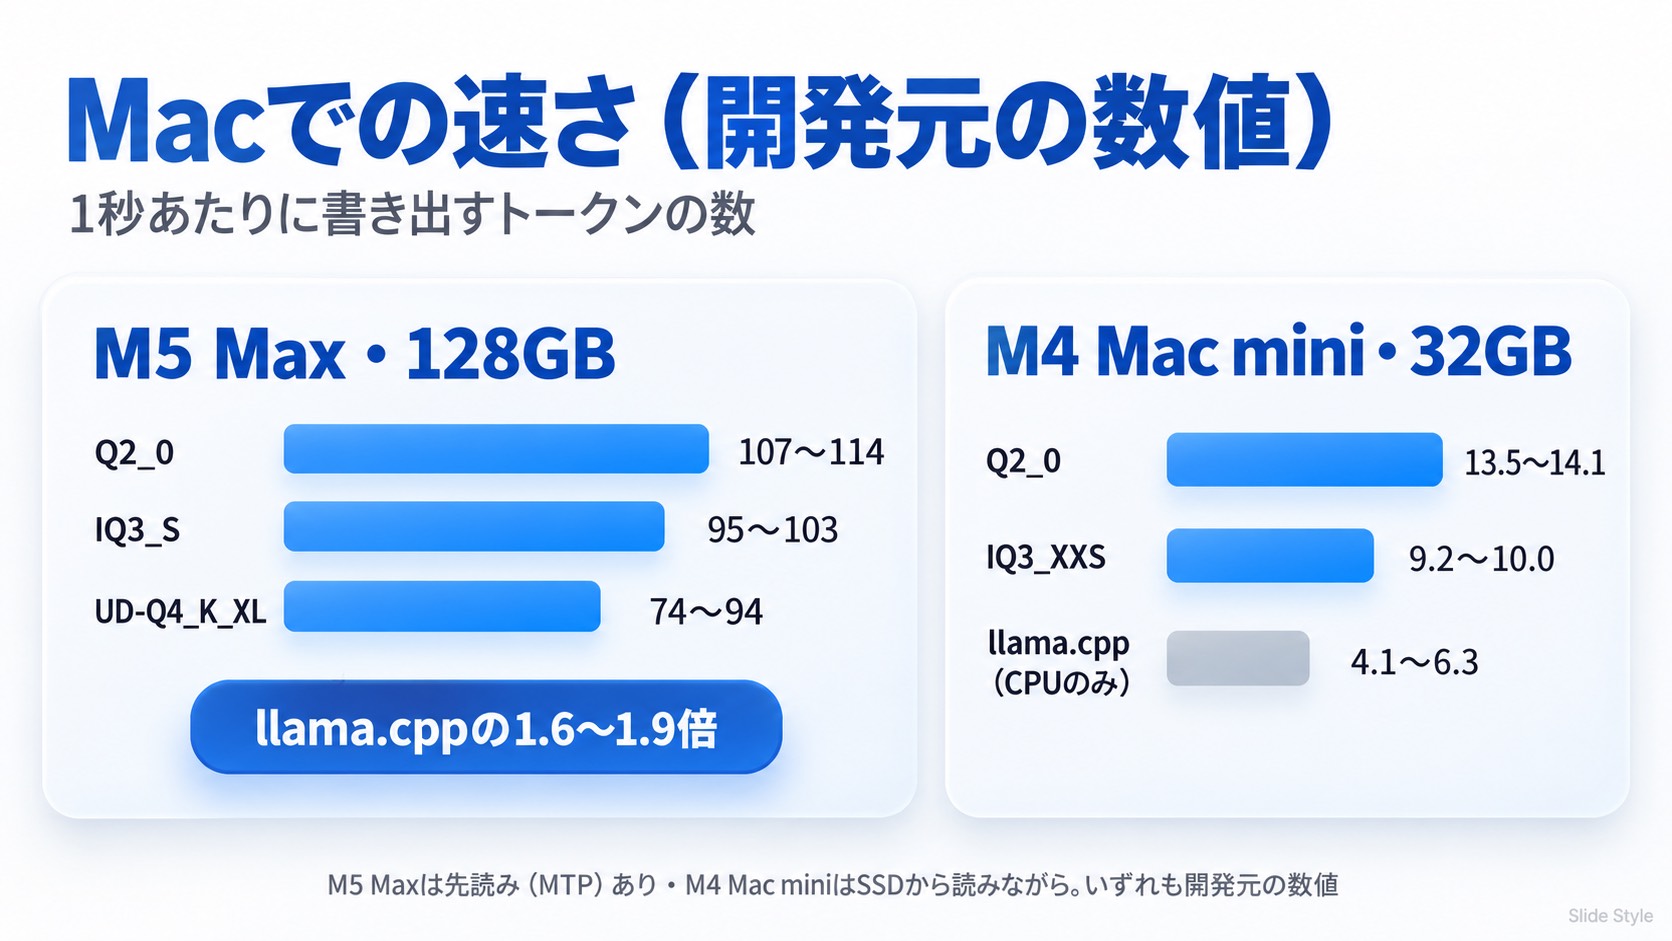
M5 Maxの数値は、モデルを机(メモリ)に丸ごと広げたうえで「次の言葉を先読みする仕組み(MTP)」を使った値。
同じMacのllama.cpp(GPU使用)より1.6〜1.9倍速いと開発元は説明しています。
M4 Mac miniの数値は本棚(SSD)から読みながらの値で、llama.cpp(CPUだけ)の4.1〜6.3トークン/秒より速くなっています。
始め方
- Command Line Toolsを入れる(ターミナルで
xcode-select --install) - Strataを公式のGitHubから取得する
- Strataのフォルダで
./setup.shを動かす。Macの確認・エンジンの組み立て(1〜15分ほど)・モデルのダウンロード・起動までを自動で進める - ブラウザで
http://127.0.0.1:8080/を開くとチャット画面が使える
Mac付属のPython(起動に使うプログラミング言語)が古い場合、setup.shが専用のPython3.12を自動で用意します(管理者のパスワードやHomebrewは不要)。
2回目からは同じフォルダで./setup.shを動かせばすぐ起動します。
Macで知っておきたいこと
- 一度に答えられる質問は1つまで(並列なし)
- 一度に扱う会話や資料の長さ(文脈)は32Kトークンまで計測済み。開発元のおすすめはメモリ96GB未満で32K、96GB以上で64K
- 動くモデルはQwen3.8-Flash-Next(Unslothの圧縮版を含む)。2026年10月13日に追加されたQwen3.6-35B-A3Bと、Coder・Swiftの派生版はMacでは選べない
- Macの答えは、PC(NVIDIA・AMD)の答えとほぼ同じ(違いはわずかな選択の差だけ)
- 対応の段階は「最新の対応状況」の表を参照。メモリ32GBのMacから動く
- 96〜128GBあれば標準〜高品質の版を机に丸ごと広げられる
- 開発元が測ったのはM5 MaxとM4 Mac miniの2台だけ
メモリ別のモデルの選び方(Windows・Linux)
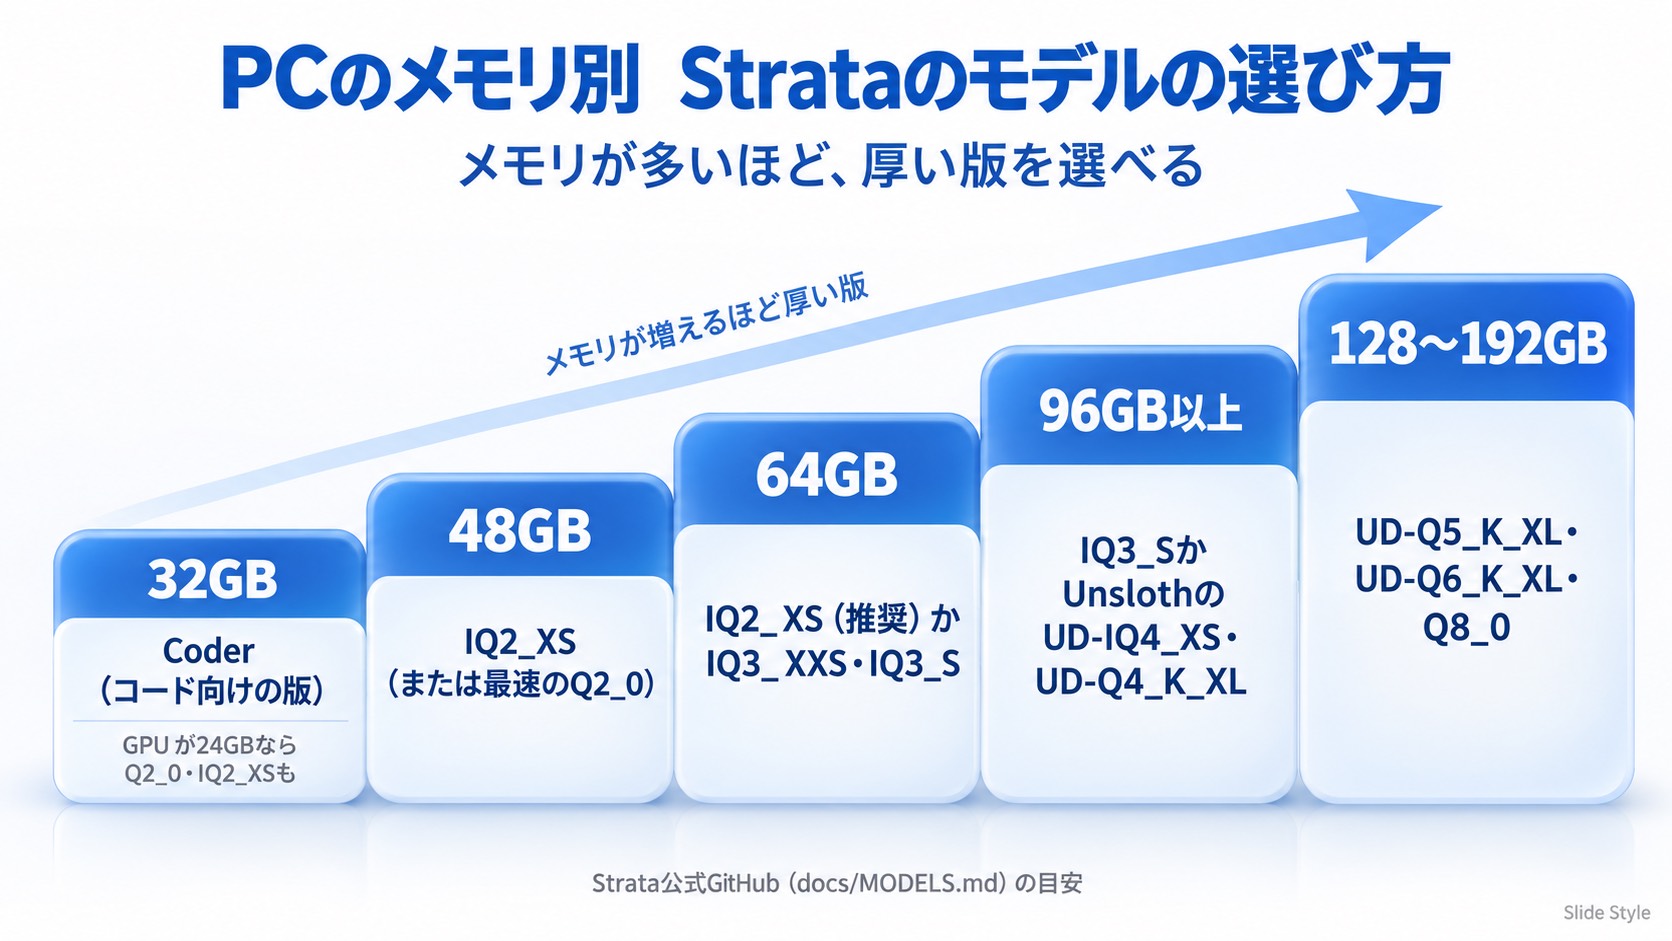
Windows・Linuxでも、メモリ量に合わせて版(Q2_0・IQ3_S・UD-Q4_K_XLなど)を選びます。
版の薄さと答えの質の関係は、Macの説明と同じです。
| メモリ | 開発元のおすすめ |
| 32GB | Coder(コード向けの版)。GPUが24GBならQ2_0・IQ2_XSも選べる |
| 48GB | IQ2_XS(または最速のQ2_0) |
| 64GB | IQ2_XS(推奨)かIQ3_XXS・IQ3_S |
| 96GB以上 | IQ3_SかUnslothのUD-IQ4_XS・UD-Q4_K_XL |
| 128〜192GB | UD-Q5_K_XL・UD-Q6_K_XL・Q8_0 |
Coderは、役割ごとに分かれた専門家(エキスパート)の数を半分にした、コード作成向けの版です。
開発元によると、コードの課題を解くテスト(SWE-bench Verified)の成績は元のモデルの91%で、コード以外の文章やCJK(中国語・日本語・韓国語)の文章は苦手です。
Swift1.5は、考える時間を短くして答えを早く出す調整版です。
2026年10月13日の更新(v0.1.44)では、新しいモデルQwen3.6-35B-A3Bにも対応しました。
対応はNVIDIAとAMDのGPUだけで、メモリ32・44・52GBを目安に自動で版が選ばれます。
IntelとMacのエンジンでは、このモデルは動きません。
- メモリが多いほど、より厚い(質の高い)版を選べる
- 32GBならCoder、64GBならIQ2_XS・IQ3系が目安
- 新しいモデルQwen3.6-35B-A3Bが動くGPUは「最新の対応状況」の表にまとめる
速さはどれくらい?
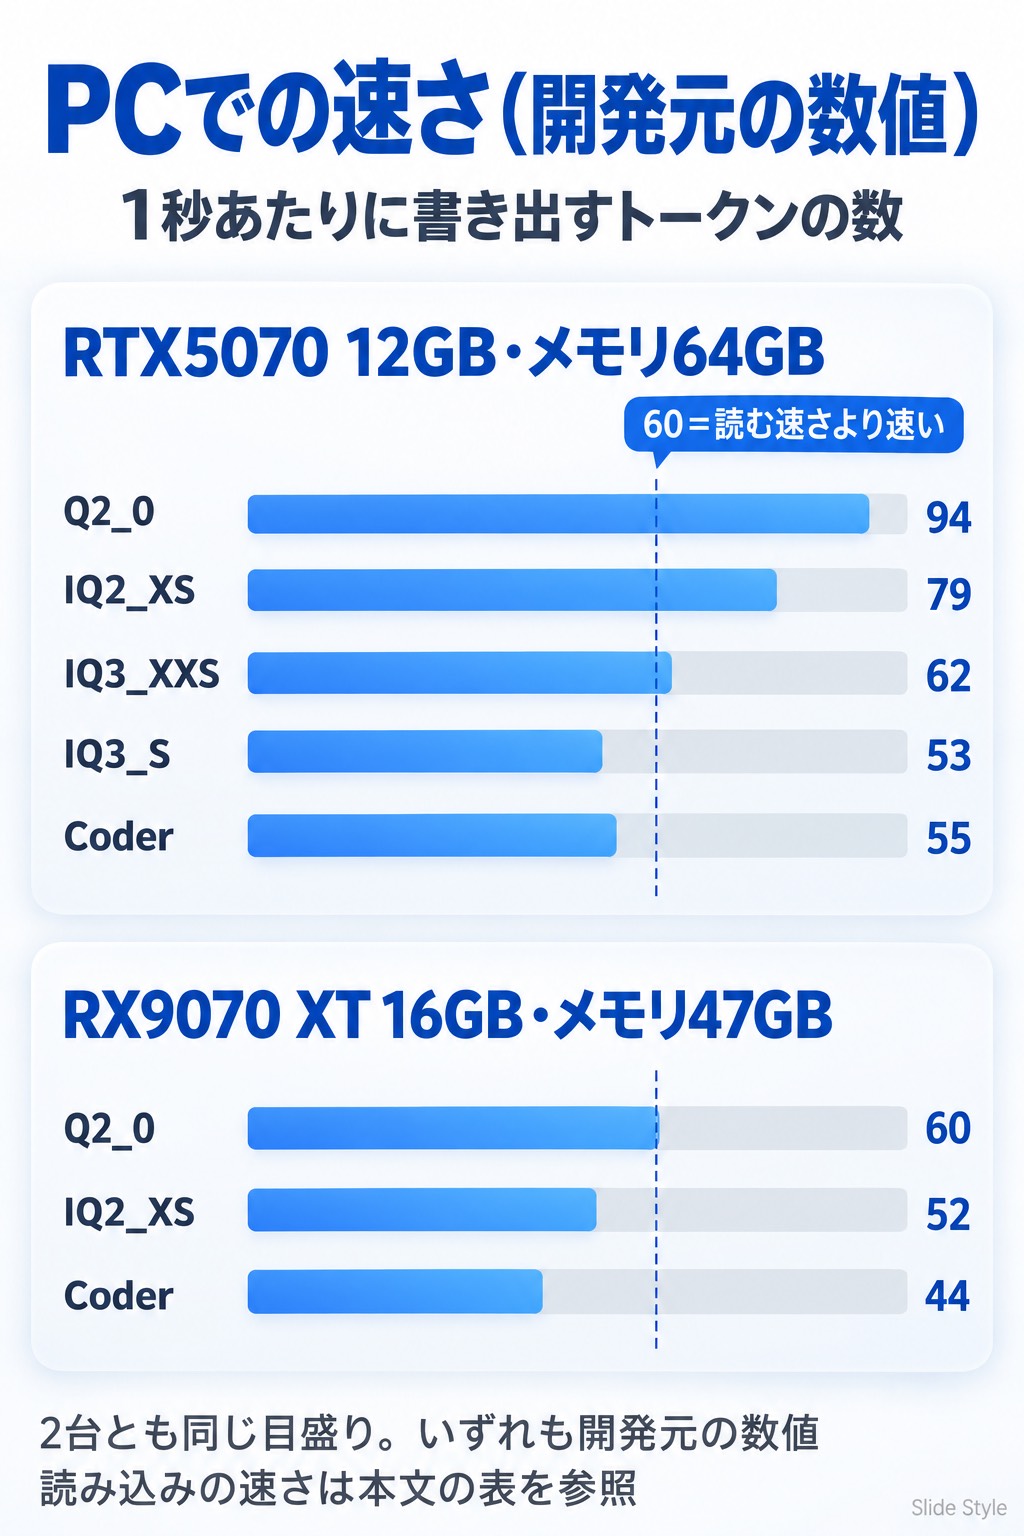
速さは、AIが答えを書き出すときの「1秒あたりの言葉のかたまり(トークン)の数」で表します。
数字が大きいほど、答えが早く画面に出てきます。
開発元の説明では「1秒に60トークンは、人が読む速さより速い」とされ、1トークンはおよそ4分の3語にあたります。
| 構成 | 版 | 答えを書き出す速さ | 読み込みの速さ |
| RTX5070 12GB・Ryzen5 7600・メモリ64GB | Q2_0 | 94トークン/秒 | 2,650トークン/秒 |
| 同上 | IQ2_XS | 79トークン/秒 | 2,090トークン/秒 |
| 同上 | IQ3_XXS | 62トークン/秒 | 1,750トークン/秒 |
| 同上 | IQ3_S | 53トークン/秒 | 1,620トークン/秒 |
| 同上 | Coder | 55トークン/秒 | 2,180トークン/秒 |
| RX9070 XT 16GB・Ryzen9 3900X・47GB | Q2_0 | 60トークン/秒 | 1,160トークン/秒 |
| 同上 | IQ2_XS | 52トークン/秒 | 1,110トークン/秒 |
| 同上 | Coder | 44トークン/秒 | 1,420トークン/秒 |
Macの数値は「Macで使う」の章にまとめています。
条件(GPU・メモリ量・版)がちがうため、PCの表とMacの表は分けています。
当サイトでは、RTX5070 Ti 16GB+メモリ32GBのパソコンでQ2_0を動かし、1秒に69.6トークンで答えが返ってきました(3回の中央値)。
ただし最初の1回だけは、SSDからの読み込みが挟まるため30.0トークン/秒でした。
測った機材や条件が開発元の表とは異なるため、同じ表には並べず、詳しい実測の条件はQwen3.8-Flash-NextをStrataで動かした実測の記事にまとめています。
- 開発元の数値はPCとMacで表を分けて確認する
- RTX5070 12GB・メモリ64GBでQ2_0は94トークン/秒
- 当サイトの実測(RTX5070 Ti・32GB)は69.6トークン/秒、初回だけ30.0
Strataを動かすなら、どんなPC・Mac?
Windows・Linuxのパソコンなら、メモリ64GBあればどのサイズの版も動きます。
1枚のGPUでVRAMが足りない場合は、2〜3枚のGPUに分けて動かすこともできます。
開発元は、VRAMが大きいGPUほど速く、RTX3090(24GB)なら1秒に約100〜140トークンで答えが書き出されると見込んでいます。
Macの場合は、CPUとGPUで共有する統合メモリが96〜128GBあれば、標準の版から品質の高い版まで机(メモリ)に丸ごと広げて動かせます。
パソコンの選び方はローカルLLM向けパソコンの選び方の記事に、Mac・RTX5090・RTX Sparkの比較はRTX SparkとMac・RTX5090を比べた記事にまとめています。
当サイトが実際に動かせたRTX5070Ti を搭載したPCモデル↓は以下です。
- 開発元はVRAMが大きいGPUほど速く動くと見込んでいる
- Macは96〜128GBの統合メモリで標準〜高品質の版まで動く
- 機種選びの詳細はローカルLLM向けパソコンの選び方の記事と、RTX SparkとMac・RTX5090を比べた記事へ
Strataの始め方
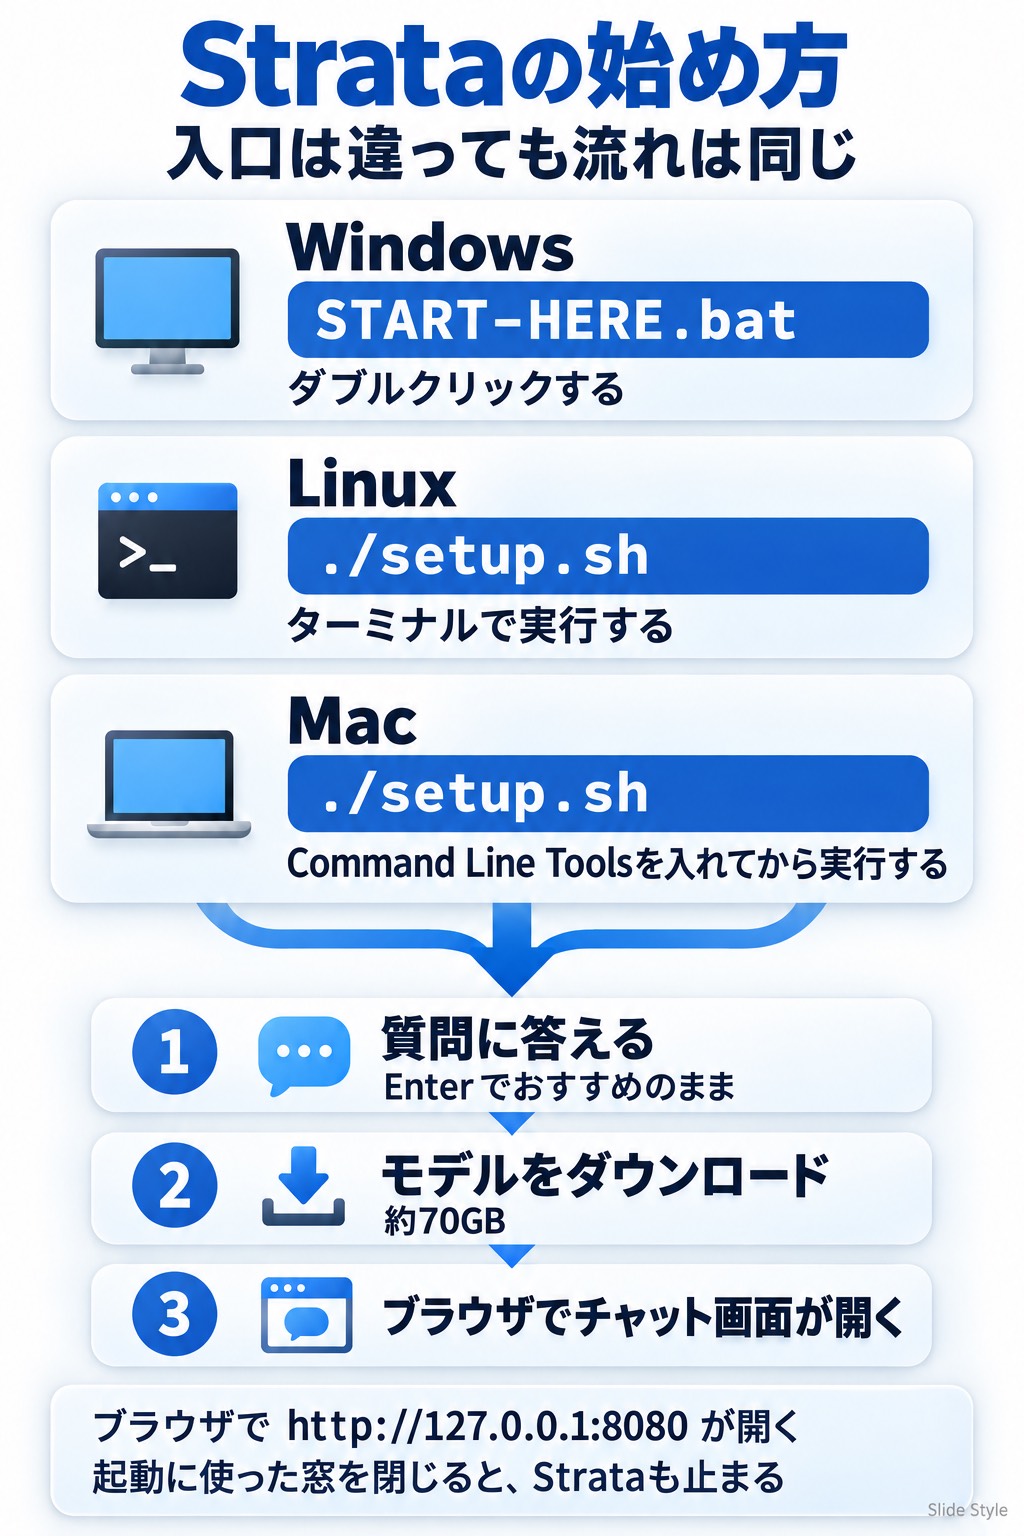
| OS | 起動の入口 |
| Windows | START-HERE.batをダブルクリック |
| Linux | ./setup.shを実行 |
| Mac | Command Line Toolsを入れてから./setup.shを実行 |
導入時に表示される質問(モデルとサイズ・文脈の長さ・画像を読むか)は、Enterキーでおすすめのまま進められます。
ダウンロードは約70GBあり、途中で止まっても続きから再開します。
起動が終わると、ブラウザでhttp://127.0.0.1:8080が自動で開きます。
起動中の1〜3分は、パソコンが重くなったり反応しなくなったりします(初回が最長)。
モデルの35〜55GB分をメモリに読み込むためで、開発元は起動中の重さを「正常」と説明しています。
2回目からの起動は同じコマンドで即座に始まり、更新はUPDATE.bat(Linux・Macは./update.sh)、速さの計測はBENCH.bat(約5〜10分)で行えます。
Claude Code・Cursor・Codex・GitHub CopilotなどのAIコーディングツールに指定の1文を貼ると、GPU・メモリ・ディスクの空きを確かめたうえで導入まで進める方法も用意されています。
- Windows・Linux・Macとも1つのコマンドで起動する
- 起動中の1〜3分は重くなるが、開発元は「正常」と説明
- AIコーディングツールに1文を貼ると導入まで自動で進む方法もある
アプリやClaude Codeから使う
ブラウザの画面にはChat(会話)・Monitor(状態の確認)・About(情報)があります。
ほかのアプリと連携するときは、アプリ同士をつなぐ窓口(API)として、OpenAI互換のAPI(http://127.0.0.1:8080/v1)やAnthropic形式のAPI(/v1/messages)が使えます。
Claude Codeからは、環境変数ANTHROPIC_BASE_URL=http://127.0.0.1:8080を指定して使う方法が案内されています。
考える深さはoff・low・medium・highから選べ、画像を読ませる機能はセットアップ時に有効にします。
標準では一度に1つの質問にしか答えません。
設定で2つ同時に答えられるようにもできますが、VRAM12GBのGPUでは、1つずつの返答が遅くなります。
最初に送るメッセージは、どれだけ長くても一度に全部読み込みます。
開発元の目安では、30,000トークンの読み込みに約1分かかります。
- OpenAI互換・Anthropic形式のAPIでほかのアプリと連携できる
- Claude CodeはANTHROPIC_BASE_URLの指定で接続できる
- 標準は1リクエストずつ。最初のメッセージは30,000トークンで約1分
使う前に知っておきたいこと
- モデルのダウンロードは約70GB、インストール先のディスクは約80GBの空きが必要
- 起動中の1〜3分はパソコンが重くなる(開発元は「正常」と説明)
- 試験的な対応(Mac・Intel Arc・旧世代GPU・Strix Halo)は開発元が測った機種が少ない
- 更新が速いプログラムのため、使うときは最新版にしておくと安心
- ダウンロードとディスクの空きは大きめに見ておく(容量は本文の一覧のとおり)
- 試験的な対応は開発元が測った機種が少ない
- 更新が速いので最新版を使う
更新履歴
- v0.1.44.1(2026年10月14日):M4/M5以外のMacで起きていた不具合を修正
- v0.1.44(2026年10月13日):Macへの試験的対応、新モデルQwen3.6-35B-A3Bへの対応を追加
- v0.1.40.2(2026年10月7日):リリースノートで「official Intel Arc support」と案内(Arc Pro B70・A750で動作を確認)。DGX Spark(Linux)で長い質問の読み込みが最大10倍速くなった
- v0.1.39(2026年10月4日):旧世代GPUなどへの試験的な対応を追加。Codex用のResponses APIに対応
- v0.1.0(2026年9月24日):Windows向けの完成品として公開。RTX30・40・50シリーズに対応
まとめ
Strataは、125BのAIをVRAM12GB以上・メモリ32GB以上のゲーミングPCで動かす無料のプログラムです。
Mac(M1〜M5)・Intel Arc・旧世代GPUは試験的な対応で、Macはメモリ96〜128GBで標準〜高品質の版が動きます。
更新が速いので、冒頭の表で確かめると安心です。
パソコンの構成ごとの速さや導入の流れを知りたい場合は、Qwen3.8-Flash-NextをStrataで動かした実測の記事や、別モデルをVRAM16GBで動かした記事、ローカルAIの始め方ガイドも参考になります。
Strataが動くゲーミングPCはこちら↓で紹介しています。
参考ソース(公式)
- Strata公式GitHub README:https://github.com/Niko1221/Strata/blob/main/README.md(2026年10月16日確認)
- docs/MAC.md(Macへの対応):https://github.com/Niko1221/Strata/blob/main/docs/MAC.md(2026年10月16日確認)
- docs/INTEL_ARC.md(Intel Arcへの対応):https://github.com/Niko1221/Strata/blob/main/docs/INTEL_ARC.md(2026年10月16日確認)
- リリース一覧:https://github.com/Niko1221/Strata/releases(2026年10月16日確認)
よくある質問
Strataとは何ですか?
Strataは、Qwen3.8-Flash-Next(125B)という大きなAIモデルを、ふつうのゲーミングPCやMacで動かす無料のプログラムです。
チャット・コード作成・画像の読み取りなどに使え、開発元はデータがパソコンの外に出ないと説明しています。
無料ですか?
無料で使えます。
オープンソース(MITライセンス)として公開されていますが、動かすAIモデルや一部の部品には別のライセンスが付きます。
対応するGPUは?
正式に対応するのは、NVIDIA GeForce RTX20〜50シリーズと一部のAMD Radeon(RX7900 XT/XTXなど)です。
いずれもVRAM12GB以上が条件です。
RTX4060(VRAM8GB)で動きますか?
Strataの正式な対応の条件はVRAM12GB以上です。
RTX4060はVRAM8GBのため、この条件には当てはまりません。
Macで使えますか?
使えます。
2026年10月13日の更新(v0.1.44)から、M1〜M5のチップを積んだMac(macOS15以上)に試験的に対応しました。
Intelチップを積んだMacは対象外です。
必要なメモリは何GBですか?
Windows・Linuxの開発元の目安はメモリ32GB以上で、64GBならどのサイズの版も動きます。
Macの目安は軽い版で64GBから、標準の版で96GBからです。
Intel Arcで動きますか?
Linux環境でソースから組み立てる形で、試験的に対応しています。
2026年10月7日の更新では、開発元自身がArc Pro B70とA750での動作を確認したと案内しています。
Windowsでの組み立て手順は、開発元の資料に記載がありません。
LM Studioのようなアプリですか?
アプリではありません。
Windowsならバッチファイル、LinuxやMacならシェルスクリプトで起動し、ブラウザの画面で使うプログラムです。