Qwen3.8-Flash-Next(125B)はVRAM 16GB+メモリ32GBで動く?Strataで速度・長文・品質を実測(RTX 5070 Ti)
「125B(1,250億パラメーター)の大きなAIが、16GBのグラフィックボードで動いた」という話を見かけると、手元のゲーミングPCでも試せるのか気になってきます。
ところが、Qwen3.8-Flash-Nextを動かす道具Strataの公式資料を開くと、メモリ32GBのPCに勧められているのはコード向けに絞った版(Coder)だけでした。
RTX 5070 Ti(16GB)とメモリ32GBの組み合わせは、公式の目安を下回ります。
2026年10月4日の計測では、Q2_0版は起動し、日本語で答えを返しました。
答えを書き出す速さ(tok/s=1秒に書ける文字のかたまりの数)は、最初の1回こそ30.0でしたが、2回目からは70前後、続けて同じ形の質問をした3回(warm)では91.0 tok/sまで上がりました。
短い質問なら、返事は1.5秒ほど(3回の中央値で、初回は7.7秒)で始まります。
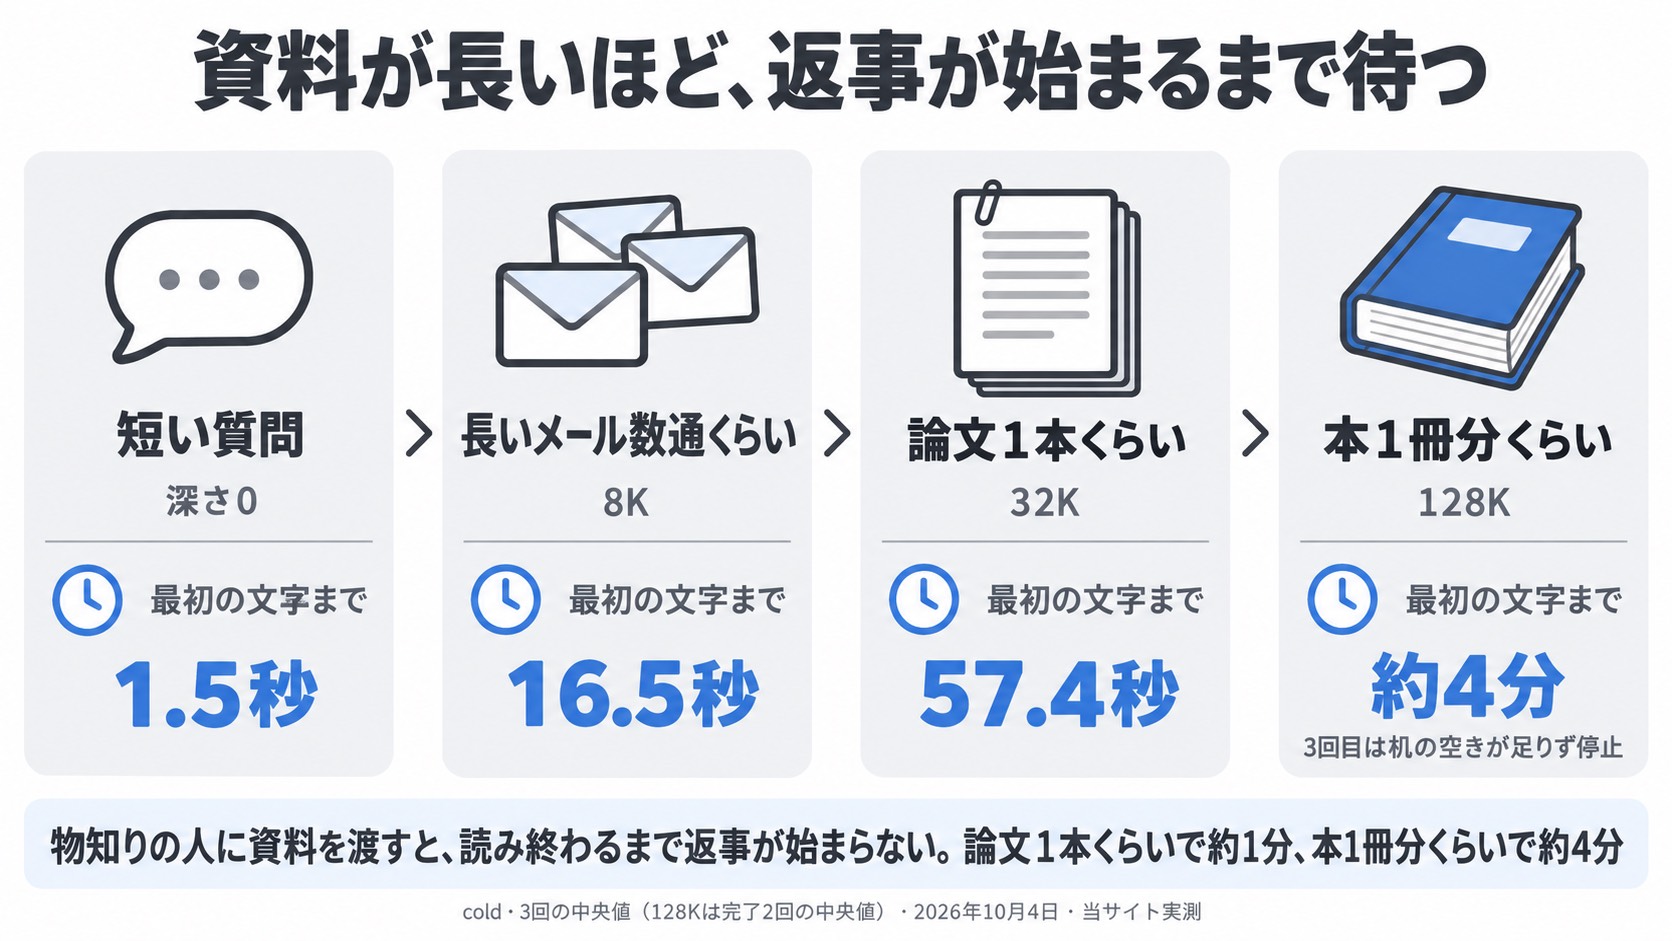
長い資料を渡すと、読み終わるまで返事が始まりません。
資料を読む速さは毎秒340〜580トークンほどでした。
本1冊分くらいの資料(12.8万トークン=128K)では最初の文字まで約4分かかり、3回目に空きメモリが足りなくなって止まりました。
100万トークン(1M)は試す前に打ち切っています。
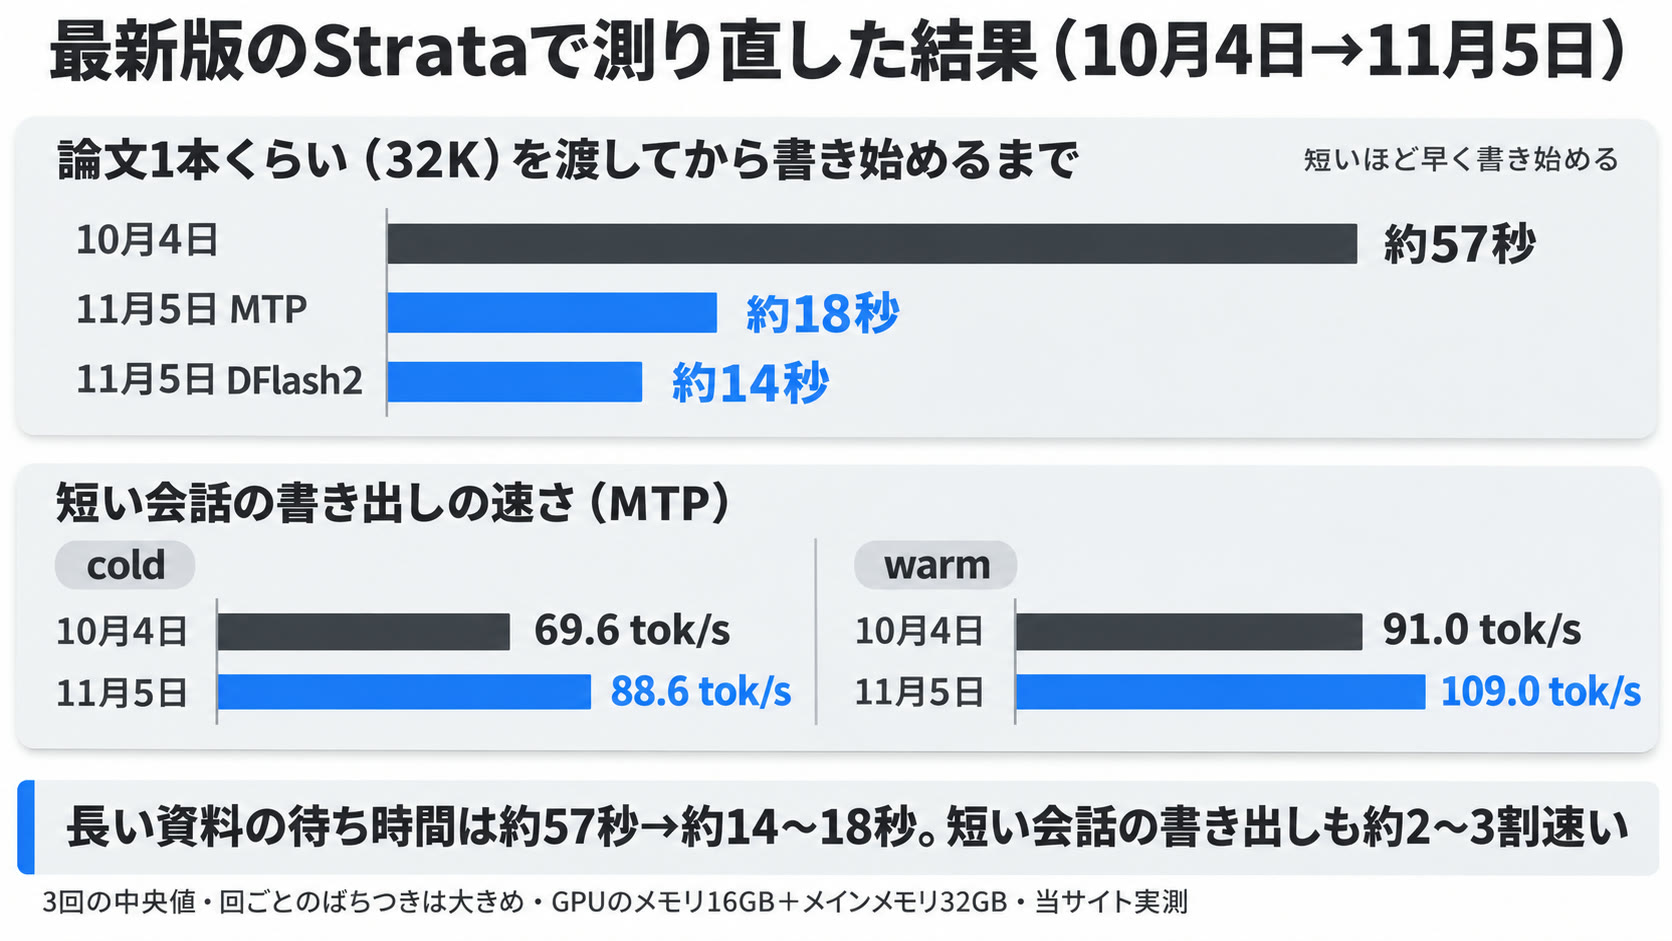
11月5日に最新版のStrata 0.2.10で測り直すと、論文1本くらい(32K)の資料を渡してから書き始めるまでの待ち時間が、約57秒から約14〜18秒に縮みました。
- AI(Qwen3.8-Flash-Next)=ものすごく分厚い百科事典を持った物知りの人。125Bは百科事典の分厚さの目安
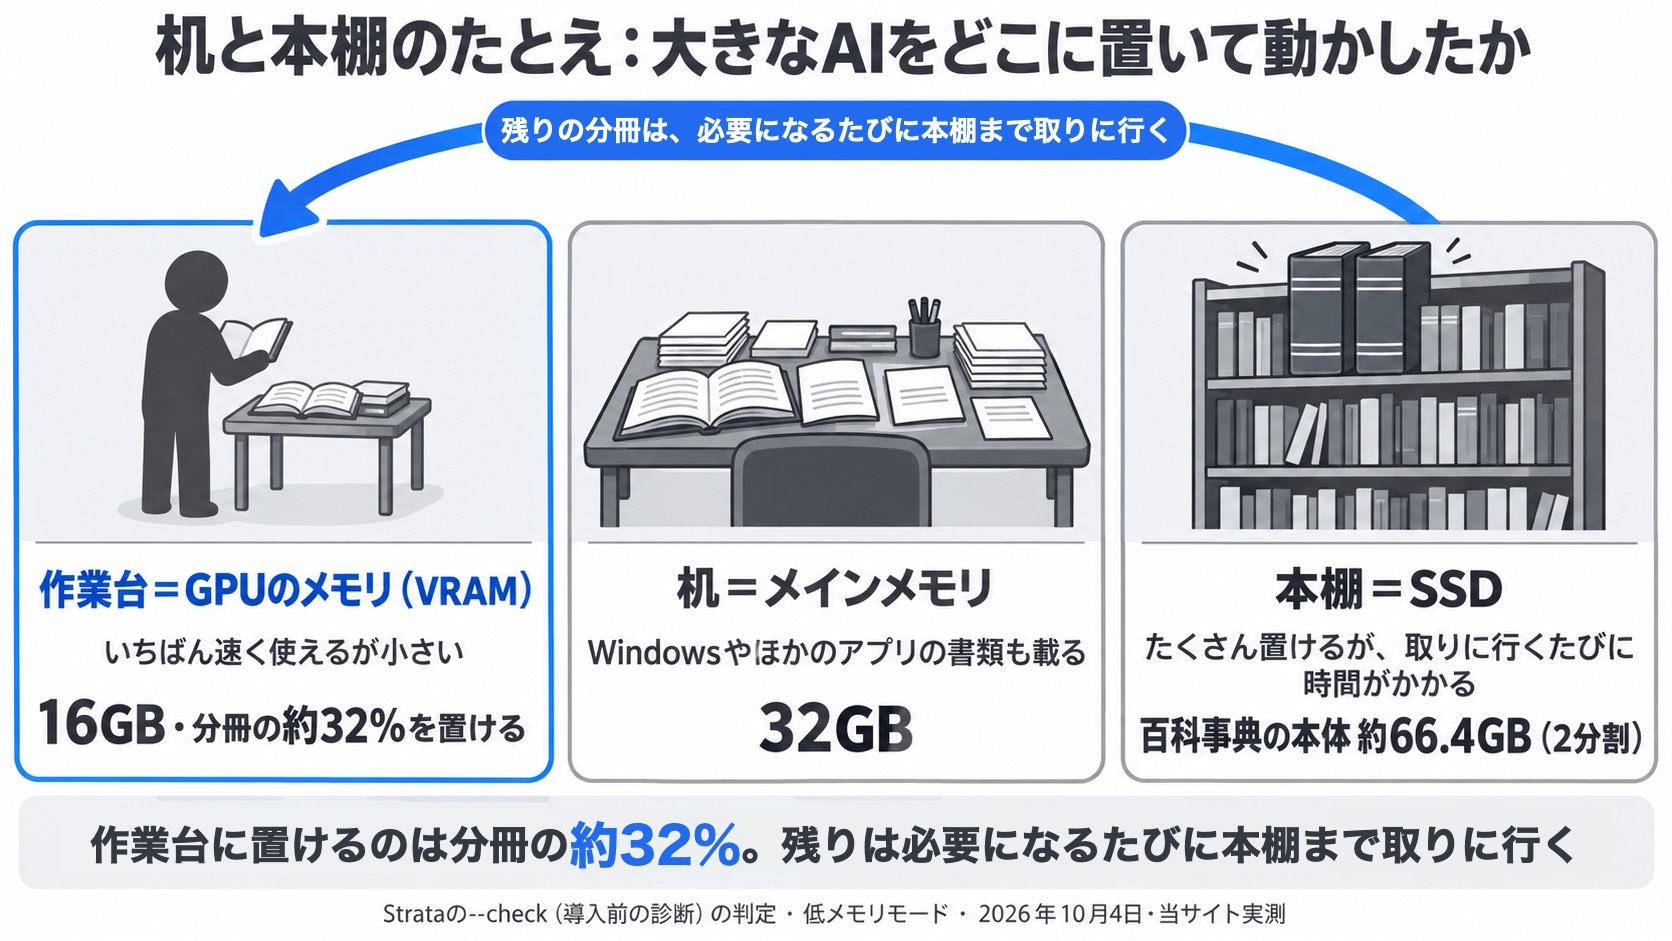
- GPUのメモリ(VRAM)=手元の作業台。いちばん速く使えるが小さい(今回は16GB)
- メインメモリ=机(今回は32GB)。SSD=本棚。たくさん置けるが、取りに行くたびに時間がかかる
- tok/s=1秒に書ける文字のかたまり(トークン)の数。日本語ならおおよそ1かたまりが1〜2文字
- 資料の長さ=8Kは長いメール数通くらい、32Kは論文1本くらい、128Kは本1冊分くらい
- 2026年11月5日に最新版のStrata 0.2.10で測り直し。論文1本くらい(32K)を渡してから書き始めるまで約57秒→約14〜18秒、短い会話の書き出しはMTPで約2〜3割速い(cold 88.6・warm 109.0 tok/s・3回の中央値)
- 作業台(VRAM)16GB+机(メモリ)32GBのPCで、Q2_0(本体2分割・約66.4GB)が起動。Strataの–check(導入前の診断)は「低メモリモードで動く」と判定(公式の推奨表では32GB向けはCoder)
- 10/4の計測では、短い質問ならすぐ返る。書き出す速さは初回だけ30.0 tok/s、話題を初めて聞く形(cold)の前置きなし(深さ0)の3回中央値で69.6 tok/s、続けて聞いた3回(warm深さ0)で91.0 tok/s
- 10/4の計測では、長い資料は読み終わるまで待つ。読む速さは341.7〜581.6 tok/sで、最初の文字まで論文1本くらい(32K)で57.4秒、本1冊分くらい(128K)で約4分
- 本1冊分の資料に隠した合言葉は2回とも正答、3回目は空きメモリ不足で監視が停止。自作20課題の品質は内容16・要件16
この記事は、FRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB・Core Ultra 7 265F・メモリ32GBのまま増設なし)で、2026年10月4日に当サイトが実測した記録をベースにしています。
ソフトはStrata(main 99f3dbd0・2026年10月3日のコミット)と出来合いのエンジン0.1.38、GPUドライバは616.64です。
2026年11月5日には、最新版のStrata 0.2.10(エンジン0.1.56)・GPUドライバ621.01で出力と読み込みの速さを測り直し、結果を最新版のStrata 0.2.10で測り直した結果に載せています。
モデルはISTA-DASLabが配布するQwen3.8-Flash-NextのQ2_0(GGUF形式・2分割)で、話しながら先の数語を予想しておく部品(MTP層)を足して動かしました。
同じFRONTIER機でほかのモデルを測った数値は、親記事のローカルLLMを動かすPCのスペックガイドに集めています。
- 結論:動いた。短い質問はすぐ返り、長い資料は待たされる。本1冊分(128K)が限界
- 今回のAIと動かす道具:Qwen3.8-Flash-NextとStrata
- 机の広さは足りたか:公式の目安と今回の構成
- 導入でPCに入ったもの(書き込まれた場所)
- 答えを書き出す速さ:初回30、2回目から70前後、続けて聞くと91(tok/s)
- 長い資料を渡すと、返事が始まるまで待たされる(入力の速さ)
- 最新版のStrata 0.2.10で測り直した結果(2026年11月)
- 作業台と机はどこまで埋まったか(VRAMとメモリ)
- 本1冊分(128K)が限界:1Mは届かなかった
- 答えの正しさ:自作20課題で内容16・要件16
- 開発元と同じ手順で測った値(strata-bench)
- どんな使い方におすすめか
- このモデルを試したPC:FRONTIER FRGKB860M/CG3
- まとめ
- よくある質問
結論:動いた。短い質問はすぐ返り、長い資料は待たされる。本1冊分(128K)が限界
- 最新版のStrata 0.2.10(11/5)では、論文1本くらい(32K)を渡してから書き始めるまで約57秒→約14〜18秒。短い会話の書き出しもMTPで約2〜3割速い
- 10/4(0.1.38)の計測では、Q2_0は起動して日本語で回答。続けて同じ形の質問をした回(warm深さ0)の書き出しは91.0 tok/s
- 10/4の資料を読む速さは最大でも581.6 tok/sで、長い資料ほど最初の文字まで待つ
- 本1冊分くらい(128K)が10/4の計測での上限。256K以上は試していない
論文1本くらい(32K)を渡してから書き始めるまでの待ち時間は、約57秒から約14〜18秒に縮みました。
2026年11月5日に最新版のStrata 0.2.10で測り直した結果で、読み込みの速さは約3〜4倍です。
短い会話の書き出しもMTPで約2〜3割速くなり、cold 88.6・warm 109.0 tok/s(3回の中央値)でした。
回ごとの大きなばらつきも含め、最新版のStrata 0.2.10で測り直した結果にまとめています。
初回の計測(10月4日・Strata 0.1.38)では、Qwen3.8-Flash-Next(Q2_0)はVRAM 16GB+メモリ32GBのPCで起動しました。
短い質問にはすぐ答えた一方、長い資料では返事までの待ち時間が目立ちました。
答えを書き出す速さは、話題を初めて聞く形(cold)の前置きなし(深さ0)の質問を3回送った中央値で、69.6 tok/sです。
1秒に70前後のかたまりが出るペースは、ふつうに文章を読む速さより速いくらいです。
気になるのは、資料を渡したときの待ち時間です。
待ち時間に加えて机(メモリ)の空きも少なく、本1冊分くらい(128K)の3回目は空きメモリが足りなくなって止まりました。
次の表は10月4日の計測結果です。
左の列が測った項目、まん中が当サイトの実測値、右が条件です。
たとえば「最初の文字まで」の行は、短い質問(深さ0)/長いメール数通くらい(8K)/論文1本くらい(32K)/本1冊分くらい(128K)の順に並んでいます。
| 項目 | 当サイト実測 | 条件・補足 |
| 出力(cold 深さ0) | 69.6 tok/s | 3回中央値。初回は30.0 |
| 出力(warm 深さ0) | 91.0 tok/s | 3回中央値 |
| 入力(読み込み) | 341.7〜581.6 tok/s | cold 深さ0〜32K |
| 最初の文字まで | 1.5秒/16.5秒/57.4秒/約4分 | 深さ0/8K/32K/128K |
| 最大の長さ | 128K(131,072)で起動・合言葉2/2 | 3回目はメモリ不足で停止。256K以上は未実施 |
| 回答品質 | 内容16・要件16(/20) | 自作20課題・各1回 |
今回のAIと動かす道具:Qwen3.8-Flash-NextとStrata
- Qwen3.8-Flash-Nextは特に分厚い百科事典を持ったAI。Strataは、普通のPC(GPU+メモリ+CPU)で動かすためのプログラム。10/4に使った0.1.38はアプリではなく、バッチファイルで起動してブラウザで使う(0.2.5からはWindows用のインストーラーでも入る)
- 低メモリモードでは、作業台(GPU)に載らない専門家(エキスパート)の分冊を、本棚(SSD)上のモデルファイルから必要なときに読む
- 先読み生成(MTP)が必須で、MTPを外した速さは測れない
AIを「ものすごく分厚い百科事典を持った物知りの人」にたとえると、125B(1,250億パラメーター)級のQwen3.8-Flash-Nextは、物知りの人の中でも特に分厚い百科事典を持っています。
Strataは、分厚い百科事典を家庭のPCの限られた机でも使えるように置き場所を工夫する仕組みで、GitHubで公開中です。
Strataが動くGPU・Mac・必要なメモリと始め方はStrata(ストラータ)とはにまとめています。
Strataの導入用のバッチファイルは、まずPCを調べてメモリ量に合うサイズを勧めます。
続けてエンジンとモデルを取り込み、ブラウザで開くチャット画面とAPI(ほかのアプリから呼び出す窓口)を用意します。
10月4日に使ったStrata 0.1.38は、導入も起動もバッチファイルで行う仕組みでした。
バッチファイルは、Windowsに命令を順番に実行させるファイルです。
中身はAIを動かすエンジン(裏方のプログラム)で、LM Studioのようにインストーラーで入れてアイコンから開く形ではありません。
起動すると黒い窓(コマンドの画面)が開き、窓を開いている間だけ、ブラウザのチャット画面やほかのアプリから使えます。
窓を閉じると、Strataも止まります。
0.2.5(2026年10月25日)からはWindows用のインストーラーでも入れられます(くわしくは導入の節)。
百科事典にはサイズ違いの版があり、Strataでは縮小コピーの度合いが違う複数のサイズ(Q2_0・IQ2_XS・IQ3_XXS・IQ3_Sなど)から選べます。
縮小コピーで薄くすること(量子化)は、薄いほど軽く扱える反面、細かい字が少しつぶれることがあります。
今回選んだQ2_0は、公式資料でいちばん速いと紹介されているサイズです。
字のつぶれが答えにどう出たかは、後半の回答品質の節に実測値を載せています。
専門家の分冊を本棚から取りに行く仕組み(MoEと低メモリモード)
今回の百科事典は、分野ごとの専門家が書いた分冊に分かれています。
答えを1かたまり(トークン)書き進めるたびに、全部の分冊を開くのではなく、そのとき必要な専門家の分冊だけを開いて進める作り方を、MoE(混合エキスパート)と呼びます。
Qwen3.8-Flash-Nextは512個のエキスパートを持ち、1トークンごとに呼ばれた専門家の分だけ手元にあれば計算が進みます。
Strataの公式資料によると、通常はモデルの1つ目のファイルに入ったエキスパートを机(メインメモリ)へ、残りを作業台(GPU)へ置き、2つ目のファイル(29GBの参照表)は本棚(SSD)に置いたまま使います。
机が足りないPCでは低メモリモードに切り替わり、エキスパートを本棚のモデルファイルから読み出す方式に変わります。
今回の構成では、Strataの–check(導入前の診断)が「GPUがエキスパートの約32%を持ち、残りはSSDから必要なときに読む」と判定しました。
公式資料も、GPUが小さいとエキスパートの大半がSSDから来るので、かなり遅くなると注意しています。
話しながら先を予想して速くする仕組み(MTP・先読み生成)が必須なこと
MTP(Multi-Token Prediction・先読み生成)は、先の数語を予想して出力を速める仕組みです。
話し慣れた人が次に言う数語を先に用意し、言いたいことと合っていればまとめて口にするのと同じ考え方です。
MTPでは小さな層が次に来る数トークンを先に予想し、本体がまとめて確かめます。
10月4日に使った0.1.38のサーバーは起動条件としてMTPを必須にしていたため、MTPを外した速さは測れませんでした。
0.2.10からは、Qwen3.8の先を予想する部品(下書き役)の既定がMTPからDFlash2に変わりました。
11月5日はMTPとDFlash2の両方で測っています(最新版のStrata 0.2.10で測り直した結果)。
同じFRONTIER機で9月3日に測ったgpt-oss-20bやQwen3.8-27Bの値は、llama-benchという別の計測ツールでMTPなしの条件です。
Strataはエンジンも違い、モデルの一部をメインメモリとSSDに置き、APIを通して測っています。
コースも靴も違う100m走のタイムと同じで、条件がそろわないため、9月3日の値との順位は付けません。
机の広さは足りたか:公式の目安と今回の構成
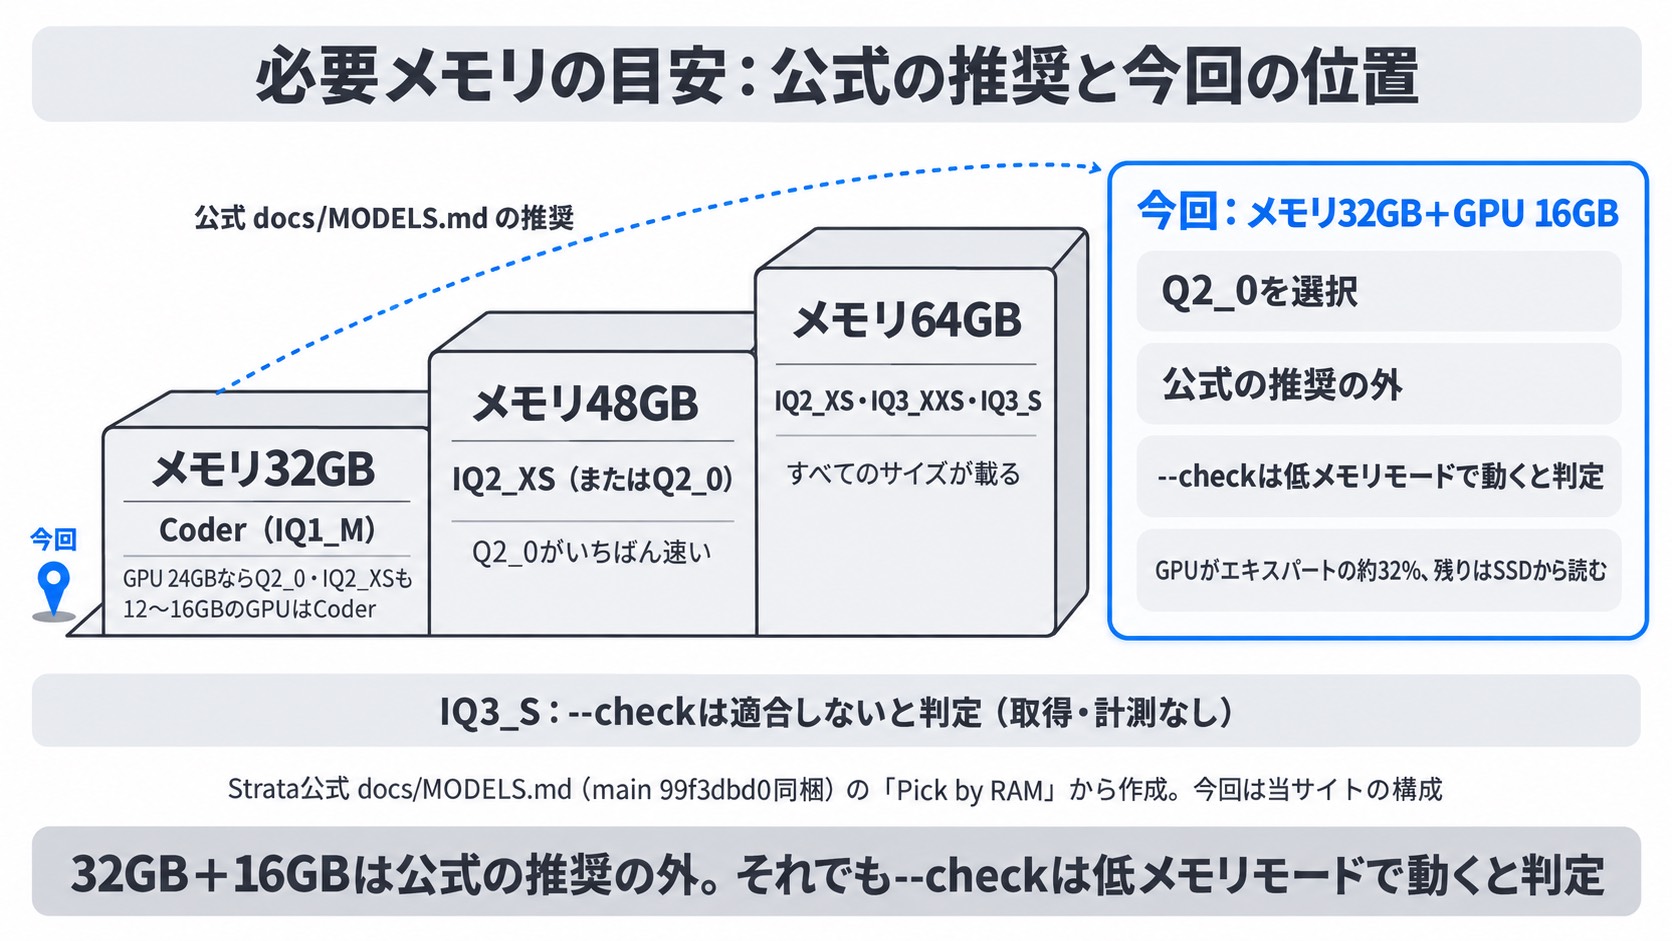
- 公式の推奨表では、メモリ(机)32GB向けはCoder(IQ1_M)。Q2_0は48GBから
- 32GB+24GBのGPUなら、Q2_0も低メモリモードで動く例として載っている
- 今回の32GB+16GBは推奨の外だが、–checkは「低メモリモードで動く」と判定
Strataの公式資料(docs/MODELS.md)には、「この机の大きさ以上で使ってね」というおすすめを、メモリの量ごとにまとめた表があります。
メモリ32GBに勧められているのはCoder(IQ1_M)で、512個のエキスパートのうちコード向けに選んだ256個だけを残した版です。
百科事典でいえば、プログラミングの分冊だけを残して薄くした版にあたります。
表の見方は、左の列がメモリ(机)の大きさ、まん中が公式のおすすめ、右が補足です。
最終行には当サイトの構成を載せています。
| メモリ | 公式の推奨 | 補足 |
| 32GB | Coder(IQ1_M) | 24GBのGPUならQ2_0・IQ2_XSも低メモリモードで動く。12〜16GBのGPUはCoder |
| 48GB | IQ2_XS(またはQ2_0) | Q2_0がいちばん速い。より大きいサイズは載らない |
| 64GB | IQ2_XS(推奨)・IQ3_XXS・IQ3_S | すべてのサイズが載る(IQ3_Sはほかのアプリを閉じて) |
| 今回(32GB+16GB) | Q2_0を選択 | 公式の推奨の外。–checkは低メモリモードで動くと判定 |
Strataの–checkが今回のPCに出した判定は次のとおりです。
- Q2_0:必要メモリ約48GB。低メモリモードなら動く(GPUがエキスパートの約32%を持ち、残りはSSDから読む)
- IQ2_XS:必要メモリ約48GB。低メモリモードなら動く(GPUが約31%を持つ)
- IQ3_XXS(約60GB)・IQ3_S(約62GB)・UD-Q4_K_XL(約48GB):適合しない
- Coder(IQ1_M):必要メモリ約32GB。低メモリモードで動く(GPUが約47%を持ち、残りはメモリに置く)
今回はStrata自身の–checkが動くと判定したため試しましたが、公式の推奨外での結果です。
IQ3_Sは–checkが適合しないと判定したため、取得も計測もしていません。
導入でPCに入ったもの(書き込まれた場所)
- 10/4(0.1.38)は管理者権限を使わずに導入(Pythonはユーザー用に導入)
- 0.2.5からはインストーラーかTerminalで入る形に変わった。ユーザー単位で管理者権限は要らない
- 主な書き込み先はPython本体・Strataの設定ファイル・Strataフォルダ内の環境とモデル
- 百科事典の本体にあたるQ2_0は2分割で約66.4GB。ダウンロードに約87分
新しい道具をPCに入れるときは、どの棚に何が置かれたかを知っておくと、あとで片付けるときに迷いません。
Strataは管理者権限を使わずに導入でき、Pythonが入っていなかったためPython 3.12.10をユーザー用として入れました。
PCへの主な書き込み先は次の3つです。
- Python本体:ユーザー領域(AppData\Local\Programs\Python)に入り、ユーザーのPATHに2項目が足される
- Strataの設定ファイル:通常は%APPDATA%\Strata\settings.json
- Strataフォルダの中身:Pythonの仮想環境(.venv)・エンジン・モデル。今回はC:\strata-bench\にまとめた
セットアップは、ダウンロードしたZIPと展開用の一時フォルダを自分で消していきます。
Pythonのインストーラーは、ユーザー領域のPackage Cacheにも導入用のファイルを残しました。
百科事典の本体にあたるモデルはQ2_0で2分割、合計約66.4GBあり、このほかにMTP層のファイルが加わります。
ダウンロードはファイルの作成から最終更新までで約87分、平均すると毎秒約12.7MBでした。
最初の起動は28.4秒、128Kに設定し直したあとの起動は16.9秒です。
途中で引っかかったのが、ページファイルの警告です。
ページファイルは、机(メモリ)が足りないときに本棚(SSD)の一角を仮置き場として使う領域です。
–checkは「Windowsのページファイルが2.0GB」と注意を出しましたが、自動管理の設定は変えずに進めました。
計測を終えて記録を見ると、OSが自分でページファイルを2,048MBから2,812MBへ広げていました。
0.2.5からの入り方(最新版の場合)
Strataは0.2.5(2026年10月25日)から入り方が変わり、WindowsではインストーラーかTerminalを使います。
Terminalは、公式のinstall.ps1で入れてstrata launchで起動する形です。
公式の説明では、通常の導入にソース一式やバッチファイルは要りません。
上の書き込み先は、10月4日にStrata 0.1.38を入れたときの記録です。
- エンジン:%LOCALAPPDATA%\Strata に入る
- 状態の記録:~/.strata(ユーザーフォルダ)に入る
- ユーザー単位の導入で、管理者権限は要らない。更新はstrata updateで行う
0.2.10からは、Qwen3.8の下書き役の既定がMTPからDFlash2に変わりました。
初回に約0.7GBと約1.2GBの部品を取りに行きます。
出典はStrataのGitHubのリリース情報と、導入の説明書(docs/INSTALL.md・docs/TERMINAL_LAUNCH.md)です。
2026年11月5日に確認しました。
答えを書き出す速さ:初回30、2回目から70前後、続けて聞くと91(tok/s)
この節は10月4日(Strata 0.1.38)の計測です。
最新版の結果は最新版のStrata 0.2.10で測り直した結果にまとめています。
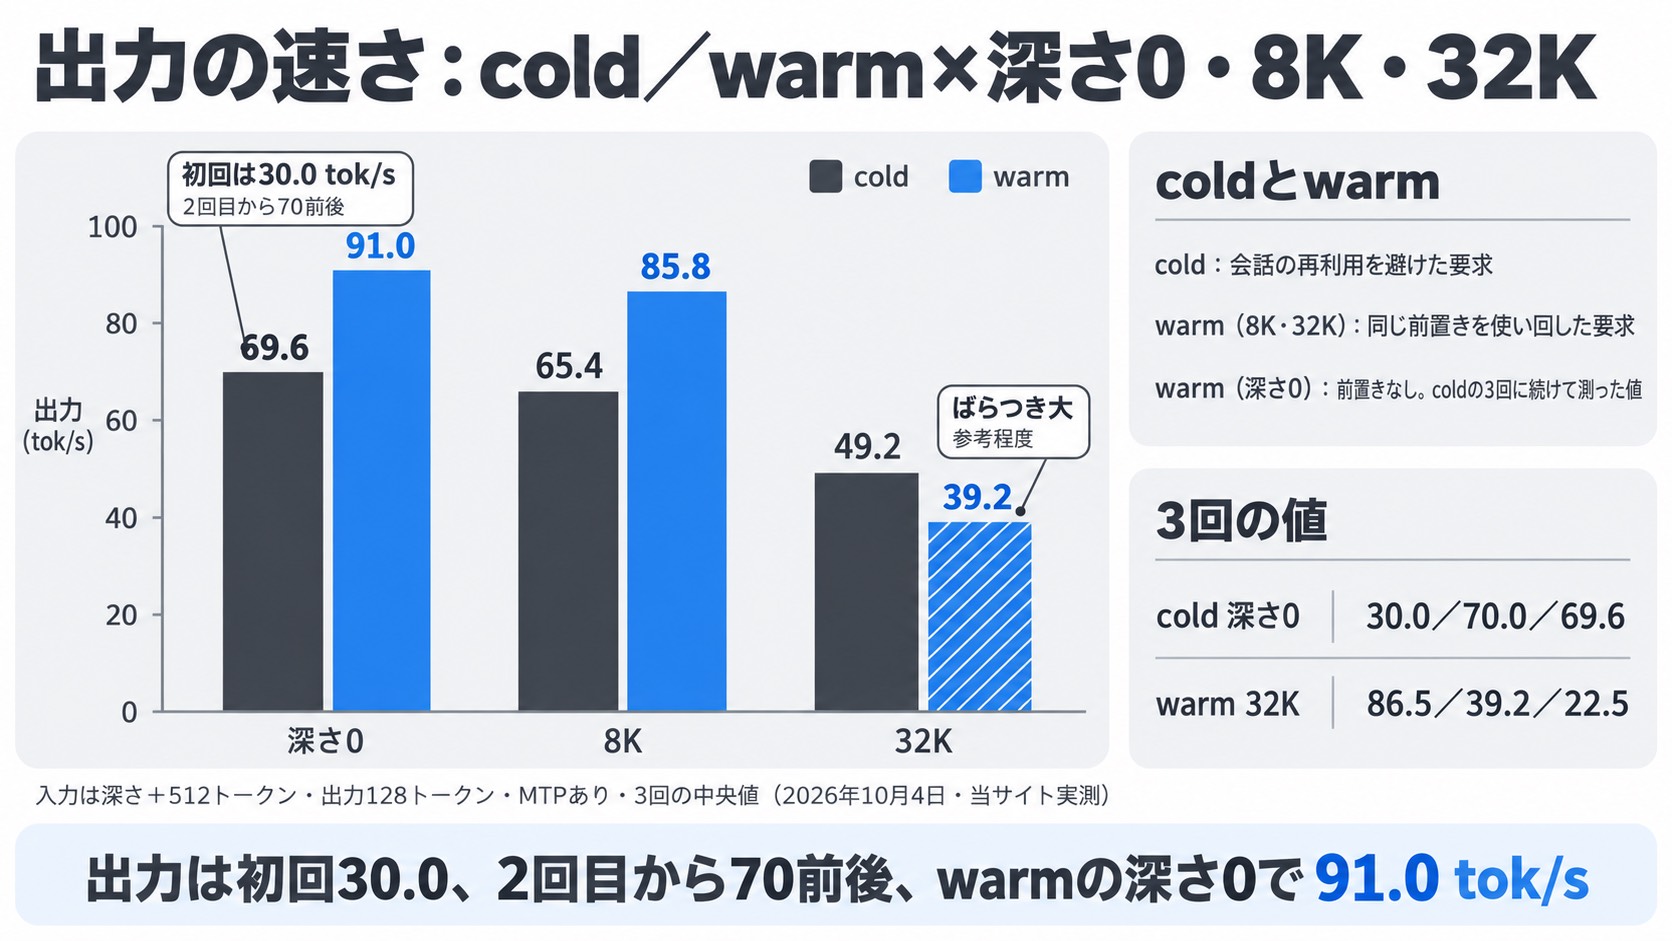
- 話題を初めて聞く形(cold)で前置きなし(深さ0)の3回は30.0/70.0/69.6 tok/sで、中央値69.6
- 初回だけ遅く、そのときの本棚(SSD)からの読み込みは最大約1.6GB/s
- 続けて測ったwarm深さ0は91.0 tok/s。論文1本くらい(32K)のwarmはばらつきが大きい
出力の速さは、物知りの人が答えを書き出していく速さです。
StrataのAPIに入力を送って128トークンを書かせ、エンジンのログに残る値を3回ずつ取りました。
測り方は2通りで、coldは「話題を初めて聞いたとき」、warmは「同じ話題を続けて聞いたとき」にあたります。
coldは会話の使い回し(KVキャッシュ)を避けた要求で、OSのファイルキャッシュまで空にした状態ではありません。
warmは同じ前置きを先に読ませて使い回した要求で、前置きのない深さ0のwarmだけは、coldの3回の直後に同じ形の要求を続けて測った3回です。
表の「深さ」は、質問の前に渡しておく前置き(資料や会話の履歴)の長さです。
深さ0は前置きなしの短い質問、8Kは長いメール数通くらい、32Kは論文1本くらいの前置きを付けた形です。
表の見方は、左の列が条件、2列目が3回の中央値、3列目が3回それぞれの値、右端が最初の文字までの時間です。
たとえば「cold 深さ0」の行の30.0/70.0/69.6は、1回目だけが遅かったことを示しています。
| 条件 | 出力 tok/s(中央値) | 3回の値 | 最初の文字まで |
| cold 深さ0 | 69.6 | 30.0/70.0/69.6 | 1.5秒 |
| warm 深さ0 | 91.0 | 90.6/91.0/94.1 | 1.1秒 |
| cold 8K | 65.4 | 56.2/65.4/74.2 | 16.5秒 |
| warm 8K | 85.8 | 67.5/100.6/85.8 | 2.7秒 |
| cold 32K | 49.2 | 50.4/43.3/49.2 | 57.4秒 |
| warm 32K | 39.2 | 86.5/39.2/22.5 | 2.6秒 |
初回は百科事典の中身を本棚(SSD)から引き出す分だけ待たされたと考えられます。
根拠にしたのは、SSDの読み込みの記録です。
1回目の最中はSSDの読み込みが最大で約1.6GB/sまで上がり、2・3回目は毎秒181〜271MiBに落ち着いていました。
同じ話題を続けて聞いたwarmでは、深さ0で91.0 tok/s、前置きを使い回した8Kで85.8 tok/sまで伸びました。
一方でwarm 32Kは86.5/39.2/22.5と回ごとの差が大きく、中央値の39.2は参考程度に見るのが妥当です。
3回目は監視プログラムを直したあとにエンジンを再起動して取り直した回で、起動条件がほかの2回とそろっていません。
coldでも、前置きが長くなるほど書き出す速さは落ちていきます。
深さ0の69.6に対して、長いメール数通くらい(8K)で65.4、論文1本くらい(32K)で49.2 tok/sでした。
長い資料を渡すと、返事が始まるまで待たされる(入力の速さ)
この節は10月4日(Strata 0.1.38)の計測です。
最新版の結果は最新版のStrata 0.2.10で測り直した結果にまとめています。
- 資料を読む速さ(cold)は深さ0で341.7、32Kで581.6 tok/s
- 最初の文字まで:短い質問は1.5秒、長いメール数通くらい(8K)は16.5秒、論文1本くらい(32K)は57.4秒、本1冊分くらい(128K)は約4分
- 9月3日の兄弟モデル(llama-bench・MTPなし)とは条件が違い、順位は付けない
入力の速さは、渡した文章をモデルが読み込む速さです。
長い資料や会話の履歴を渡すほど、答えの1文字目が出るまで長く待ちます。
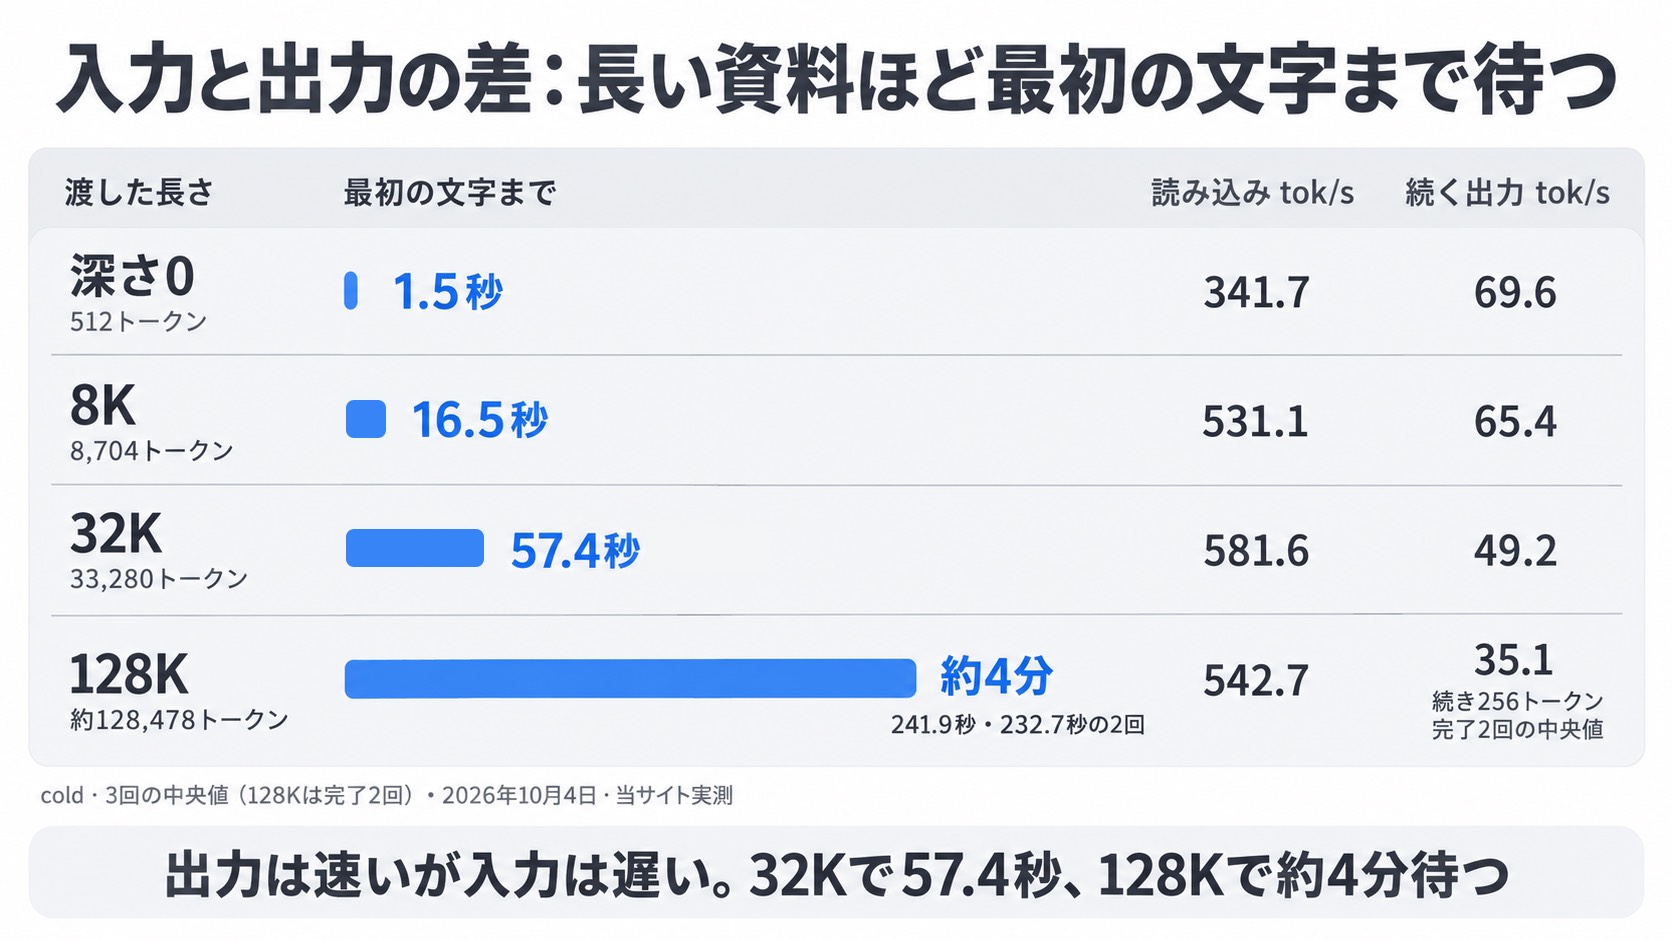
表の見方は、左の列が渡した資料の長さ、2列目が読む速さ、3列目が最初の文字までの時間、右端が読み終えたあとの書き出しの速さです。
たとえば論文1本くらいの32Kの行では、1秒に581.6トークンずつ読み、最初の文字まで57.4秒かかっています。
| 渡した長さ | 読み込み tok/s | 最初の文字まで | 続く出力 tok/s |
| 深さ0(512トークン) | 341.7 | 1.5秒 | 69.6 |
| 8K(8,704トークン) | 531.1 | 16.5秒 | 65.4 |
| 32K(33,280トークン) | 581.6 | 57.4秒 | 49.2 |
| 128K(約128,478トークン) | 542.7 | 約4分(232.7〜241.9秒) | 35.1 |
渡す文章が長いメール数通くらい(8K)から論文1本くらい(32K)に増えると、待ち時間は16.5秒から57.4秒へ伸びました。
読む速さそのものは500 tok/s台で横ばいなので、待ち時間は文章の長さにほぼ比例して伸びていきます。
続けて聞いたwarm 8K・32Kは前置きを読み直さず、新しく足した525トークンだけを読むため、その速さ(198.8・219.9 tok/s)はこの表に入れていません。
同じFRONTIER機で測ったほかのモデルの読み込みの速さも、参考として並べておきます。
表は行がモデル、右の3列が前置きの長さごとの読む速さです。
2列目の計測方法は行ごとに異なります。
| モデル(計測日) | 計測の方法 | 深さ0 | 8K | 32K |
| Qwen3.8-Flash-Next Q2_0(10/4) | Strata・MTPあり・API経由 | 341.7 | 531.1 | 581.6 |
| Qwen3.8-27B UD-Q3_K_XL(9/3) | llama-bench・MTPなし | 1,873.78 | 1,722.48 | 1,260.04 |
| gpt-oss-20b MXFP4(9/3) | llama-bench・MTPなし | 10,375.60 | 8,880.78 | 6,230.29 |
数字の開きは大きいものの、エンジンも測り方も違うため、モデルの優劣は付けません。
最新版のStrata 0.2.10で測り直した結果(2026年11月)
- 論文1本くらい(32K)を渡してから書き始めるまで、約57秒→約14〜18秒(読み込みの速さは約3〜4倍)
- 短い会話の書き出しはMTPで約2〜3割速い(cold 69.6→88.6・warm 91.0→109.0 tok/s)
- 既定になったDFlash2は、このPC(メモリ32GB)ではMTPより速くならなかった。どちらも回ごとのばらつきが大きい
2026年11月5日、同じFRONTIER機のStrataを最新版の0.2.10(エンジン0.1.56)に入れ替えて、出力と読み込みの速さを測り直しました。
モデルは10月4日と同じQ2_0のファイルです。
先の数語を予想する下書き役は、10月4日と同じMTPと、0.2.10で既定になったDFlash2の両方で測っています。
Strataの最新の対応状況はStrata(ストラータ)とはにまとめています。
表の見方は、左の列が項目、右の列が11月5日の条件です。
| 項目 | 11月5日の条件 |
| Strata | 0.2.10(エンジン0.1.56) |
| NVIDIAドライバ | 621.01 |
| モデル | Qwen3.8-Flash-Next Q2_0(10月4日と同じファイル) |
| コンテキスト | 64K |
| 下書き役 | MTP(10月4日と同じ)とDFlash2(0.2.10の既定) |
| 出力 | 128トークン・Thinkingオフ・temperature 0 |
| 回数 | 各3回の中央値 |
| 計測した項目 | 出力と読み込みの速さ |
10月4日とは、次の点で計測条件が異なります。
- Strataの版:0.1.38→0.2.10
- NVIDIAドライバ:616.64→621.01
- 画像の読み取り部品がCPUで動く設定:0.2.10の既定で入った
- 質問の長さ:深さ0=約477・8K=約8,570・32K=約32,745トークン(10月4日は512/8,704/33,280)
- 値の出どころ:11月5日はStrataのサーバーが返す値、10月4日はエンジンのログの値(どちらも測る側の計算とほぼ一致)
出力の速さ:短い会話はMTPで約2〜3割速い
前置きなし(深さ0)の短い会話は、MTPで比べて約2〜3割速くなりました。
coldは69.6から88.6 tok/s、warmは91.0から109.0 tok/sです。
warmでは1秒に100を超えるかたまりが出るペースです。
表は、左の列が条件、右の3列が出力の速さ(tok/s・3回の中央値)です。
右の列は、10月4日のMTP・11月5日のMTP・11月5日のDFlash2の順に並んでいます。
| 条件 | 10/4 MTP(0.1.38) | 11/5 MTP(0.2.10) | 11/5 DFlash2(0.2.10) |
| cold 深さ0 | 69.6 | 88.6 | 68.8 |
| warm 深さ0 | 91.0 | 109.0 | 102.9 |
| cold 8K | 65.4 | 82.9(3回で45.6〜103.6) | 78.4 |
| warm 8K | 85.8 | 75.6 | 80.2 |
| cold 32K | 49.2 | 52.9(3回目は18.6) | 21.3 |
| warm 32K | 39.2 | 23.6 | 28.9 |
前置きを付けた8K・32Kの出力は、ばらつきが大きく、10月4日と比べて何%速くなったとは言えません。
表でも、10月4日より上がった行と下がった行が混ざっています。
8K・32Kは同じ条件でも回ごとの差が大きく、cold 8KのMTPは3回で45.6〜103.6 tok/sまで開きました。
長い資料の読み込み:32Kの待ち時間が約57秒から約14〜18秒に
いちばん大きく変わったのは、長い資料を読み込む速さです。
論文1本くらい(32K)では、読む速さが581.6から1,824.9 tok/s(MTP)、2,367.6 tok/s(DFlash2)に上がりました。
書き始めるまでの時間は57.45秒から18.23秒(MTP)、DFlash2なら13.88秒です。
論文1本くらいの資料でも、20秒かからずに返事が始まります。
表は、左の列が渡した長さ、中の3列が読む速さ(tok/s・coldの3回の中央値)です。
右端には、書き始めるまでの時間を10月4日→11月5日(MTP)の順に載せています。
| 渡した長さ | 10/4 読み込み | 11/5 MTP 読み込み | 11/5 DFlash2 読み込み | 書き始めまで 10/4→11/5 MTP |
| 深さ0 | 341.7 | 333.0 | 287.7 | 1.52→1.44秒 |
| 8K | 531.1 | 777.7 | 720.6 | 16.45→11.06秒 |
| 32K | 581.6 | 1,824.9 | 2,367.6 | 57.45→18.23秒(DFlash2は13.88秒) |
短い質問(深さ0)では、書き始めるまでの時間は1.5秒前後で、大きく変わりません。
読む量が少ない短い質問よりも、長い資料で差が開きました。
既定になったDFlash2とMTPの比較
メモリ32GBのこのPCでは、既定のDFlash2はMTPより速くなりませんでした。
DFlash2の下書きが当たった割合は0.7〜0.9と高い一方、出力の速さは回ごとのばらつきが大きく、32Kのcoldは21.3 tok/sでした。
読み込みだけは32KでDFlash2のほうが速く、書き始めまでは13.88秒です。
DFlash2とMTPの差は、メモリ32GBのこのPC・この条件で出た結果です。
机(メモリ)に余裕のあるPCでも同じ順になるかは、今回の値からは分かりません。
回ごとのばらつきが大きい理由
回ごとの速さが揺れるのは、本棚(SSD)からの読み込み待ちが変わるためと考えられます。
66GBあるモデルを32GBの机で動かし、11月5日の計測では空きメモリの最小が約390〜420MBまで下がりました。
ただし、10月4日に使った停止条件(空き500MiB未満が60秒続く)には達せず、止まった回はありません。
表の値はどれも3回の中央値ですが、とくに8K・32Kの出力は1回ごとに大きく上下します。
作業台と机はどこまで埋まったか(VRAMとメモリ)
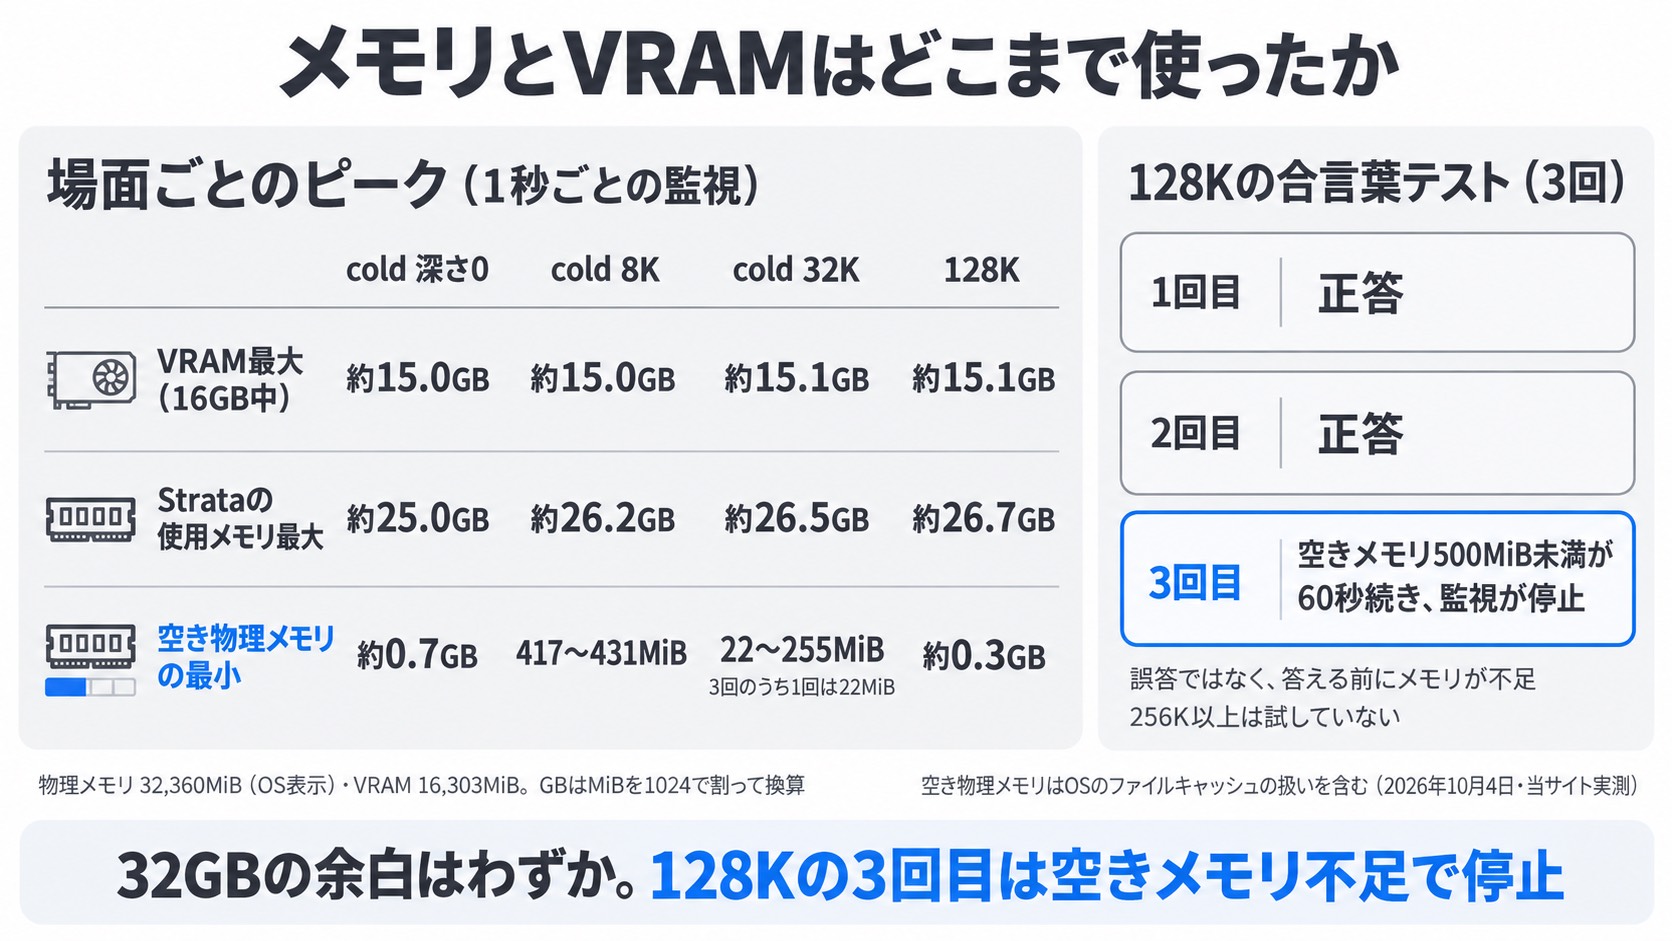
- 作業台(VRAM)は深さ0から128Kまで約15.0〜15.1GB(16GB中)でほぼ一定
- 机の空き(空き物理メモリ)は深さ0で約0.7GB、32Kでは22MiBまで減った回がある
- Strataの使用メモリは最大約26.7GB。本棚(SSD)からの読み込みは最大約2.0GB/s
机の上には百科事典のページのほか、Windowsやほかのアプリの書類も載るので、机の空きがどれだけ残るかも見ておきたい点です。
1秒ごとの監視で記録したピーク値を、場面ごとに並べました。
表の見方は、行が場面(渡した資料の長さ)、列が作業台・机・本棚それぞれのピークです。
たとえば「空き物理メモリの最小」の列は机の空きがいちばん少なくなった瞬間の値で、32Kの行の22〜255MiBは、3回のうちいちばん減った回が22MiBだったことを示しています。
| 場面 | VRAM最大 | 空き物理メモリの最小 | Strataの使用メモリ最大 | SSD読み込みの最大 |
| cold 深さ0 | 約15.0GB/16GB | 約0.7GB | 約25.0GB | 1回目 約1.6GB/s |
| cold 8K | 約15.0GB | 417〜431MiB | 約26.2GB | 約1.3GB/s |
| cold 32K | 約15.1GB | 22〜255MiB | 約26.5GB | 約2.0GB/s |
| 128K | 約15.1GB | 約0.3GB | 約26.7GB | 約1.7GB/s |
論文1本くらい(32K)の資料を読ませた3回のうち1回は、空き物理メモリが22MiBまで減りました。
32GBの机のうちStrataが約26.5GBを使い、残りをWindowsとほかのアプリで分け合う形で、余白はわずかです。
ただし、この空きの値にはOSのファイルキャッシュ(OSがすぐ片付けられる形で机に置いている控え)の扱いを含むので、空きが少ないからといって、すぐに止まるとは限りません。
メモリ不足で実際に止まったと書けるのは、次の節で触れる128Kの3回目だけです。
本棚の仮置き場にあたるページファイルの使用は、最大で2,788MBに達しました。
GPUの温度は最大58℃、GPUの電力は最大約202Wです。
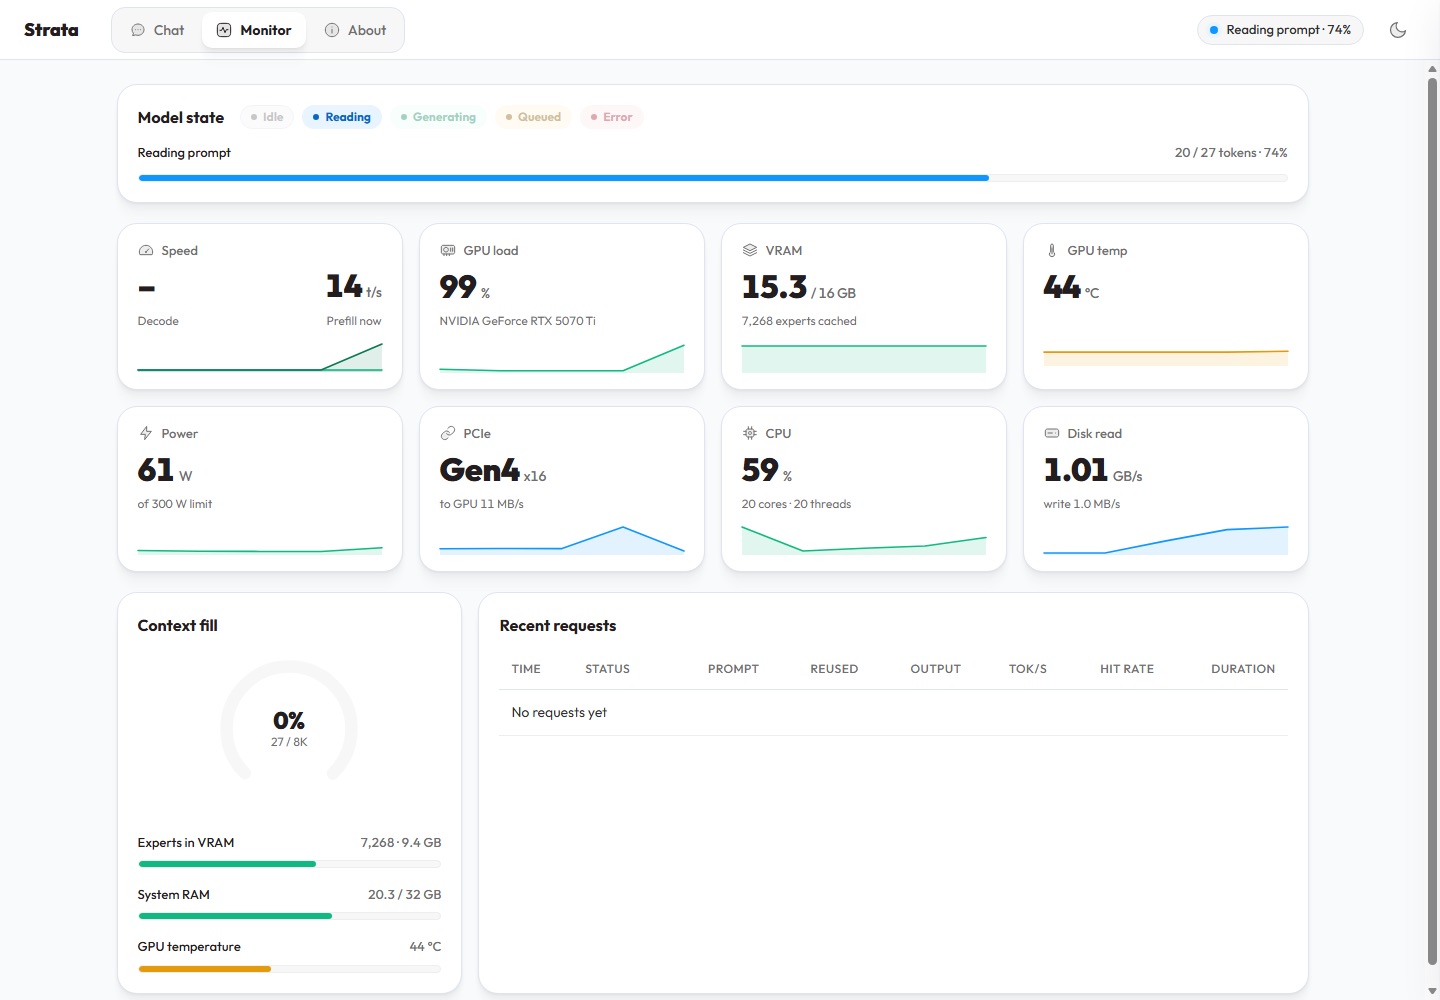
StrataのMonitorタブでも、作業台(VRAM)の埋まり方を確かめられます。
8K設定で画面を確認したときは、VRAM 15.3/16GB、VRAMに置かれたエキスパート7,268個(9.4GB)、System RAM 20.3/32GB、SSDの読み込み1.01GB/sと表示されていました。
画面の数字は1枚の瞬間値で、上の表のピーク値とは別です。
本1冊分(128K)が限界:1Mは届かなかった
- 本1冊分くらいにあたる131,072トークンで起動し、約12.8万トークンの資料に隠した合言葉を2回とも正答
- 1回の読み込みに約4分。続きの出力は22.0/48.2 tok/s
- 3回目は空きメモリ500MiB未満が60秒続き監視が停止。256K以上は未実施
モデルが一度に机に広げておける資料の長さを、コンテキストと呼びます。
上限を探るため、本1冊分くらいにあたる131,072トークン(128K)の設定で起動しました。
約12.8万トークンの文章の中央付近に日本語の合言葉を1つ隠し、読み終えたあとに合言葉を答えさせています。
表の見方は、行が1回目〜3回目、列が合言葉の正誤・読む速さ・最初の文字までの時間・続きの書き出しの速さです。
3回目の行が「―」なのは、答える前に止まって値が取れなかったためです。
| 回 | 合言葉 | 読み込み tok/s | 最初の文字まで | 続き256トークンの出力 tok/s |
| 1回目 | 正答 | 532.1 | 241.9秒 | 22.0 |
| 2回目 | 正答 | 553.2 | 232.7秒 | 48.2 |
| 3回目 | ― | ― | ― | 空きメモリ500MiB未満が60秒続き、監視が停止 |
合言葉は2回とも正しく答えましたが、1回ごとに読み込みだけで約4分かかりました。
3回目は空きメモリが500MiBを切った状態が60秒続き、監視プログラムが自分でサーバーを止めています。
停止はモデルの誤答ではなく、答える前の空きメモリ不足によるものです。
128Kの3回目で止まった時点で、256K・512K・1Mは試さずに打ち切りました。
1Mは未実施で、設定できなかったという意味ではありません。
公式のdocs/INSTALL.mdによると、モデルが学習した長さは262Kで、262Kを超える設定は、文章の位置の数え方を計算で引き伸ばす方法(rope scaling)を使う実験的な扱いです。
公式資料の速度表には、Q2_0で128Kのときの出力76 tok/sが載っています。
ただし測定機はRTX 5070(12GB)・Ryzen 5 7600・メモリ64GBで、メモリ32GBで低メモリモードに入った今回の構成とは条件が違います。
SNSのXでは、別のPCで1Mまで動かし出力150〜160 tok/sが出たという報告も見かけましたが、当サイトでは確かめていない他人の値です。
答えの正しさ:自作20課題で内容16・要件16
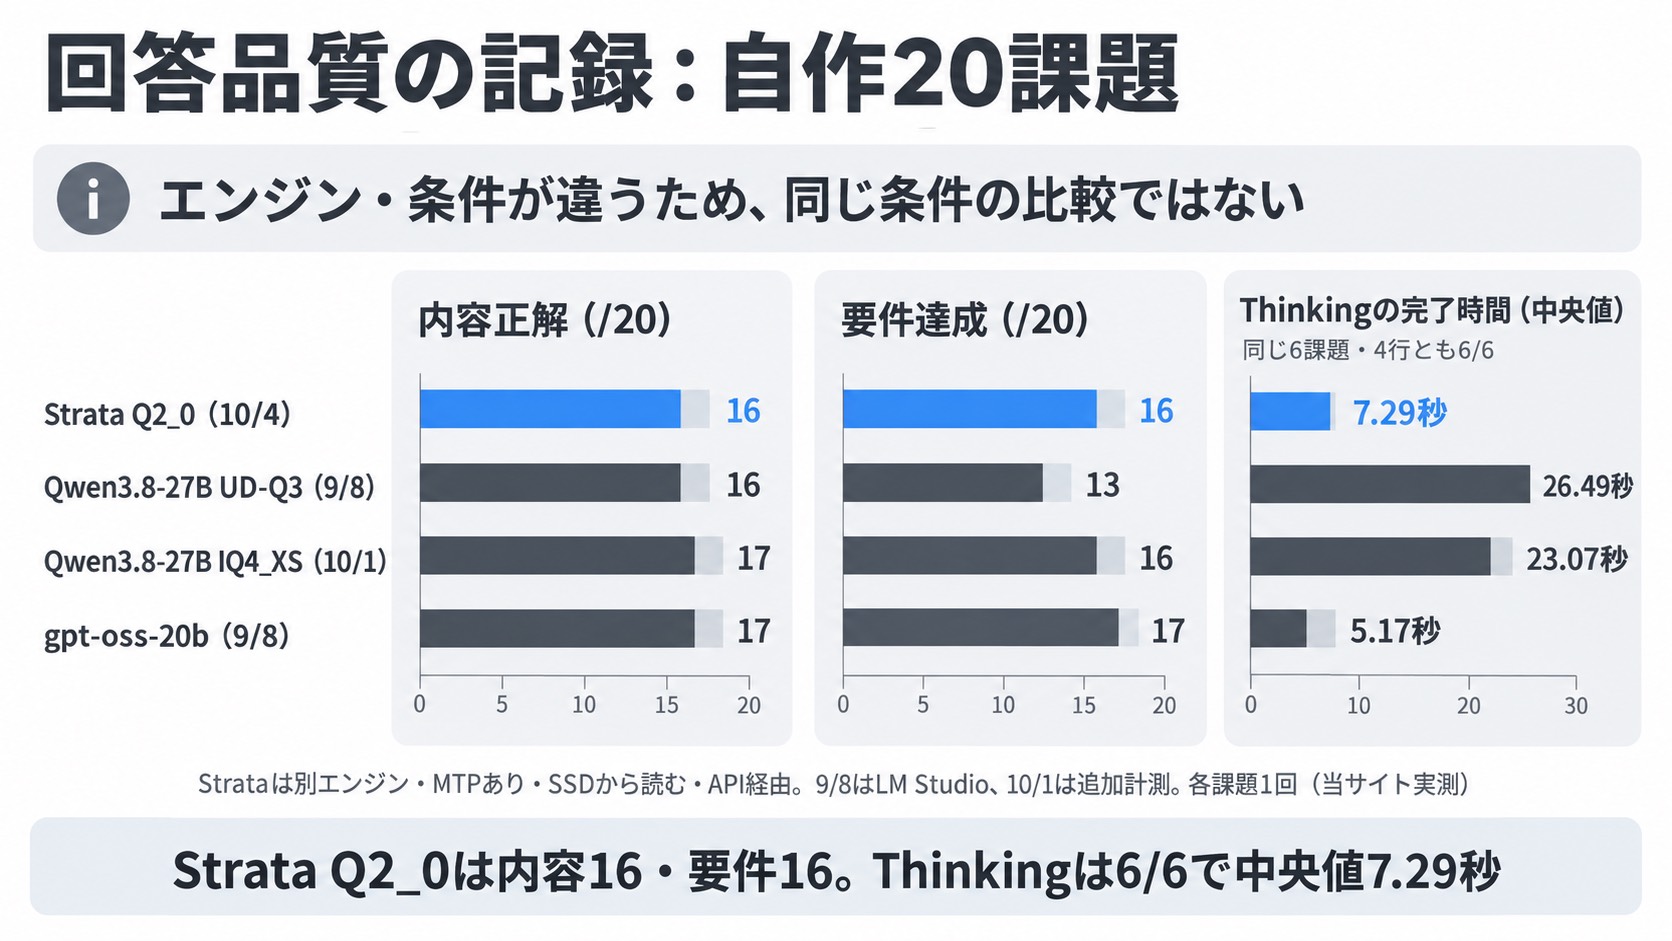
- 9月8日と同じ自作20課題で、答えの中身が合っていた数(内容正解)16・指示の形まで守れた数(要件達成)16
- Thinking(答える前に下書きして考えるモード)は同じ6課題すべて正答、完了時間の中央値7.29秒
- 繰り返しの安定性は4/9。2文で答える指示に1文で返した場面もあった
答えの正しさは、学校のテストのように、決まった問題を解かせて確かめました。
問題は9月8日にほかのモデルへ出したのと同じ自作の20課題で、context 8192(一度に机に広げる資料の長さの上限)、temperature 0(毎回いちばん確からしい語を選ぶ設定)で各課題1回ずつ答えさせています。
表の見方は、「内容正解」が答えの中身が合っていた数、「要件達成」が中身に加えて「2文で」のような指示の形まで守れた数です。
右の2列は、Thinkingをオンにして同じ6課題を解かせた結果と、答え終わるまでの時間の中央値です。
| モデル(条件) | 内容正解 /20 | 要件達成 /20 | Thinking 同じ6課題 | Thinkingの完了時間中央値 |
| Strata Q2_0(10/4) | 16 | 16 | 6/6 | 7.29秒 |
| Qwen3.8-27B UD-Q3(9/8) | 16 | 13 | 6/6 | 26.49秒 |
| Qwen3.8-27B IQ4_XS(10/1) | 17 | 16 | 6/6 | 23.07秒 |
| gpt-oss-20b(9/8) | 17 | 17 | 6/6 | 5.17秒 |
内容正解の16/20は、9月8日のQwen3.8-27B UD-Q3と同じ数でした。
内訳を見ると、文章から情報を抜き出す課題(3/3)、不明点や矛盾を指摘する課題(2/2)、引用文に紛れた指示を無視する課題(2/2)は満点です。
点を落としたのは計算(1/3)と判断(1/3)でした。
Thinkingをオンにすると、基本設定で3/6だった同じ6課題がすべて正答になりました。
完了までの時間の中央値は7.29秒で、表のQwen3.8-27Bの2行(23.07秒・26.49秒)より短く済んでいます(条件の違いは表の注のとおり)。
計算問題を言い換えた追試も、基本設定では×、Thinkingでは○でした。
temperature(答えのゆらぎの大きさ)を0.7に上げ、3課題を3回ずつ答えさせる繰り返しでは、合格は4/9でした。
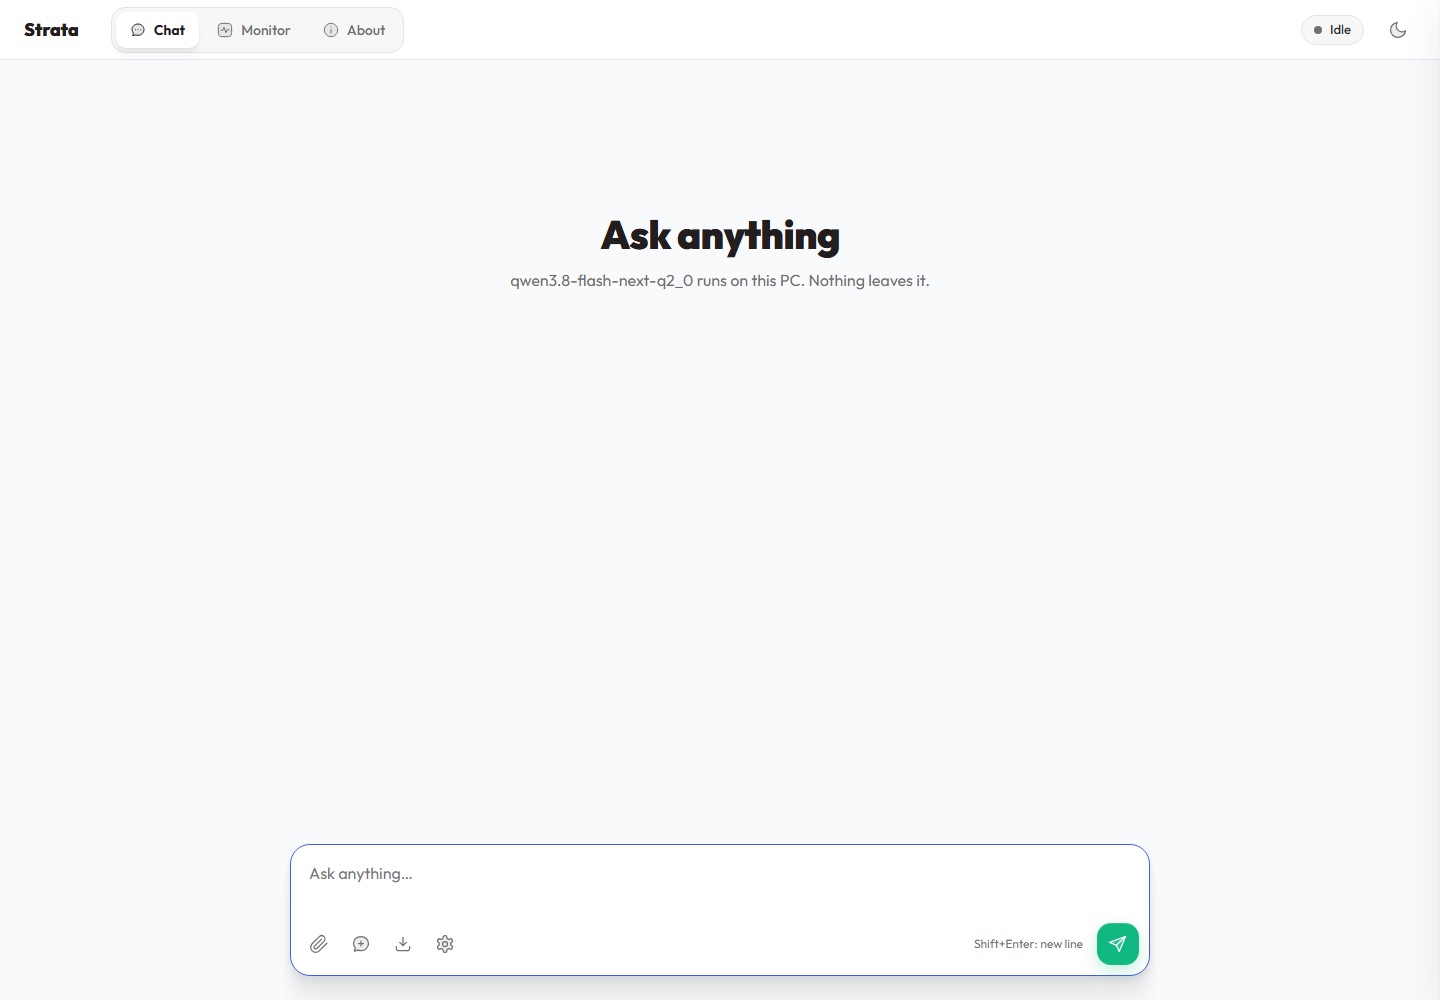
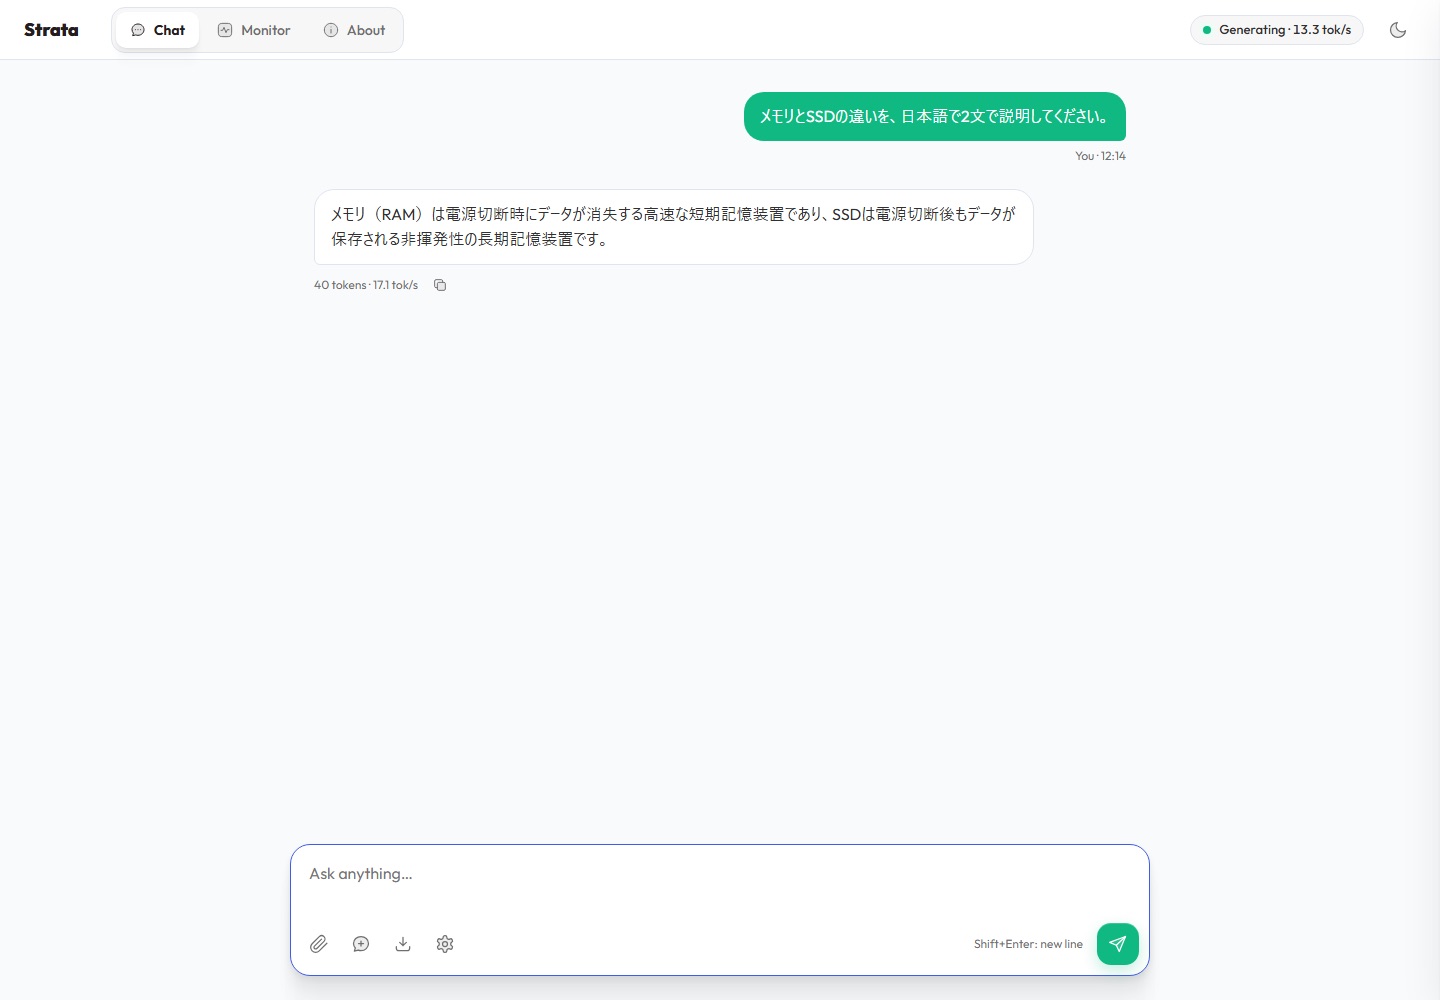
チャット画面からも日本語で質問してみました。
「メモリとSSDの違いを、日本語で2文で説明してください。」と頼むと、日本語の答えは返ってきたものの、1文にまとめた答えでした。
画面には40 tokens・17.1 tok/sと出ていましたが、短い1回の表示なので、上の速度表とは並べません。
開発元と同じ手順で測った値(strata-bench)
- Strata付属のstrata-bench(コード作業の指示・出力256・temperature 0)で各3回
- 4Kで入力307.2・出力52.6、32Kで入力668.3・出力54.5 tok/s
- 公式表はRTX 5070 12GB・メモリ64GBの構成で、今回とは前提が違う
同じレシピで料理を作っても、台所の広さが違えば仕上がるまでの時間は変わります。
Strataには、開発元が速度の計測に使うスクリプト(strata-bench)が入っていて、公式の数字を同じ手順で確かめるため、4Kと32Kで各3回走らせました。
表の見方は、左から資料の長さ、実際に渡したトークン数、読む速さ、書き出す速さの順です。
| 文脈 | 実際の入力トークン | 入力 tok/s | 出力 tok/s |
| 4K | 4,077〜4,232 | 307.2 | 52.6 |
| 32K | 31,522〜31,660 | 668.3 | 54.5 |
strata-benchの32Kの出力54.5 tok/sと、先に載せたcold 32Kの49.2 tok/sは、指示の中身と出力の長さ(256対128トークン)が違うので一致しません。
どちらも同じPCの値で、測り方の違いがそのまま数字に出ています。
次の表は公式の測定機の値で、たとえるなら机(メモリ)が64GBある広い台所で作ったときの記録です。
| 構成 | 出力(短い会話) | 出力(128K) | 読み込み |
| 公式の測定機(RTX 5070 12GB・Ryzen 5 7600・メモリ64GB) | 94 tok/s | 76 tok/s | 2,650 tok/s |
メモリ32GBでエキスパートの多くをSSDから読む今回の構成とは、同じQ2_0でも前提が違うので、数字の差をそのままパフォーマンスの差とは見なせません。
どんな使い方におすすめか
- 短い質問を何度も:おすすめ(10/4は最初の文字まで1.1〜1.5秒・出力は初回30.0、2回目から約70〜91 tok/s。最新版のMTPはwarmで109.0 tok/s)
- 長い資料を読ませる:最新版で32Kの待ち時間は約57秒→約14〜18秒。128Kは10/4の計測で約4分
- ほかのアプリと並べて毎日使う常用:メモリ32GBでは余白が足りない
今回の記録をもとに、使い方を3つに分けて解説します。
短い質問を繰り返す、長い資料を渡す、ほかのアプリと並べて毎日使う場合の使い勝手を見ていきます。
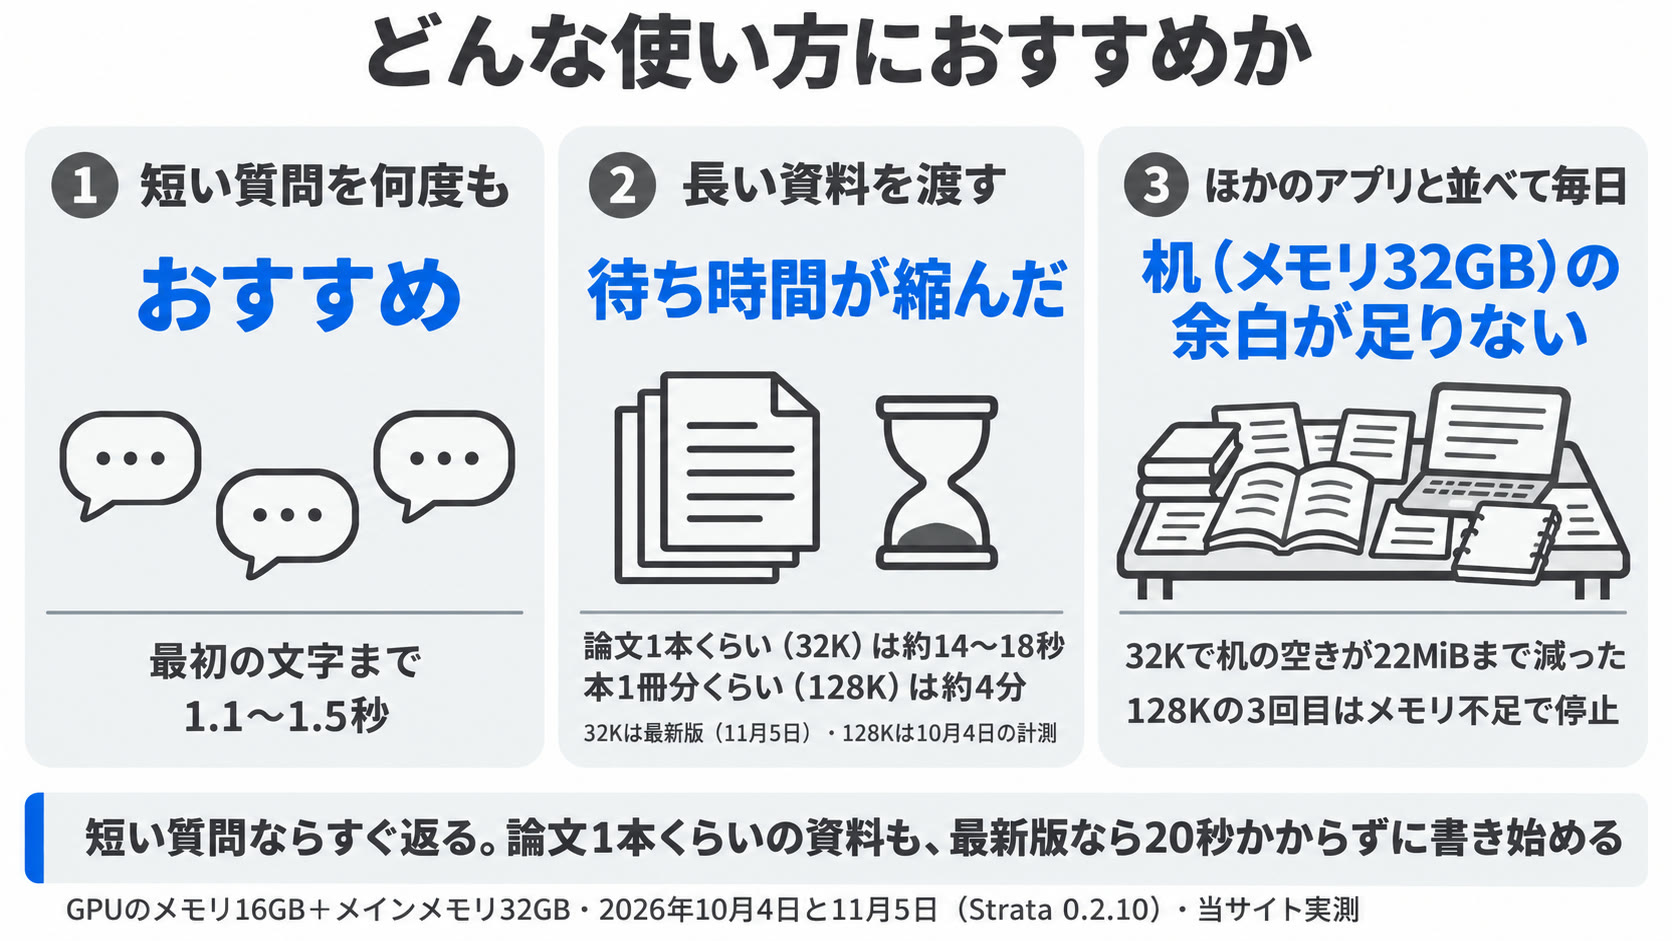
短い質問を何度も投げる使い方におすすめです。
10月4日の計測では、深さ0なら最初の文字まで1.1〜1.5秒(中央値)で、出力も2回目からは約70〜91 tok/s出ました。
最初の1回(最初の文字まで7.7秒・30.0 tok/s)を過ぎると、warm深さ0の3回は90.6〜94.1 tok/sに収まり、短いやり取りの数字は安定していました。
最新版の0.2.10では、MTPのwarm深さ0が109.0 tok/sまで上がっています。
長い資料を読ませる使い方は、最新版で待ち時間が大きく縮みました。
論文1本くらい(32K)なら、書き始めまで約57秒かかった10月4日に対し、11月5日の0.2.10では約14〜18秒です。
本1冊分くらい(128K)は10月4日の計測で読み込みに約4分かかりました。
新しい資料を渡すたびに読み込みの時間がかかります。
同じ前置きを使い回せるwarmなら、8Kで2.7秒、32Kで2.6秒まで縮むので、同じ資料に続けて質問する形なら待ち時間を抑えられます。
ほかのアプリと並べて毎日使う常用には、メモリ32GBでは余白が足りません。
32Kで空きメモリが22MiBまで減り、128Kの3回目はメモリ不足で止まりました。
今回もGPUを使う別のアプリが一覧に残ったままの計測です。
16GBのGPUで余白を残して動かしたいなら、作業台(VRAM)に収まるモデルのほうが扱いやすい場面もあります。
量子化の選び方まで含めて27Bの密モデルを試したQwen3.8-27Bを16GBで動かした記録、MXFP4で動かしたgpt-oss-20bの16GB実測、MoEのモデルをVRAMだけで動かしたGemma 4 26B-A4Bの16GB実測で、使い方に合うモデルを比べられます。
このモデルを試したPC:FRONTIER FRGKB860M/CG3
- FRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB・Core Ultra 7 265F・メモリ32GB・1TB)
- メモリは増設せず32GBのまま計測
- 公式資料では、メモリ64GBならQ2_0を含むすべてのサイズが載る
今回の計測に使ったのは、FRONTIERのFRGKB860M/CG3です。
RTX 5070 Ti(16GB)とCore Ultra 7 265F、メモリ32GB、1TBのストレージという構成で、メモリは増設せず届いたままの状態で測りました。
メモリを64GBにするのは、たとえるなら机を広くすることにあたります。
公式のdocs/MODELS.mdは、64GBならすべてのサイズが載る(IQ3_Sはほかのアプリを閉じて)としています。
RTX 5090(32GB)や統合メモリの大きいMacまで候補に入れるなら、RTX Spark・Mac・RTX 5090を比べた記事も判断材料です。
まとめ
Qwen3.8-Flash-Next(125B)のQ2_0は、作業台(VRAM)16GB+机(メモリ)32GBのPCでも起動し、日本語で答えを返しました。
10月4日(Strata 0.1.38)の計測では、短い質問ならすぐ返り、書き出す速さはcold深さ0の中央値で69.6 tok/s(初回は30.0)、続けて測ったwarmで91.0 tok/sです。
11月5日に最新版のStrata 0.2.10で測り直すと、論文1本くらい(32K)の資料を渡してから書き始めるまでが、約57秒から約14〜18秒に縮みました。
短い会話の書き出しもMTPで約2〜3割速くなっています。
既定になったDFlash2は、メモリ32GBのこのPCではMTPより速くならず、どちらも回ごとのばらつきが大きい結果です。
気になるのは、長い資料を渡したときの待ち時間と、机の空きの少なさです。
10月4日の計測では、論文1本くらい(32K)の資料で最初の文字まで57.4秒、本1冊分くらい(128K)で約4分かかり、128Kの3回目は空きメモリが足りなくなって止まりました。
Strataの公式表でも、32GBのPCに勧められているのはCoderで、Q2_0は推奨の外です。
短い質問を重ねる使い方なら125Bの答えを手元で試せる一方、長い資料を日常的に読ませたいなら、メモリの多いPCかVRAMに収まるモデルを選ぶほうが現実的です。
よくある質問
Qwen3.8-Flash-Nextはメモリ32GBで動く?
動きました。
RTX 5070 Ti(16GB)とメモリ32GBのPCで、Q2_0がStrataの低メモリモード(机に載らない分を本棚のSSDから取りに行く方式)で起動し、日本語で答えを返しています。
ただしStrataの公式資料が32GB向けに勧めているのはCoder(IQ1_M)でQ2_0は推奨の外にあたり、論文1本くらいの資料(32K)では空きメモリが22MiBまで減った回がありました。
必要なメモリとVRAMはどれくらい?
Strataの公式資料(docs/MODELS.md)では、Q2_0はメモリ48GBから、64GBならすべてのサイズが載ると書かれています。
メモリ32GBの場合、24GBのGPUならQ2_0とIQ2_XSが低メモリモードで動き、12〜16GBのGPUにはCoder(コード向けの分冊だけ残した版)が勧められています。
今回の32GB+16GBでは、Strataの導入前の診断がQ2_0を低メモリモードで動くと判定し、VRAMは約15.0〜15.1GBまで使いました。
出力と入力の速さはどれくらい?
短い質問ならすぐ返り、資料が長いほど返事が始まるまで待ちます。
2026年11月5日に最新版のStrata 0.2.10で測り直すと、書き出す速さ(MTP・3回の中央値)はcold深さ0で88.6 tok/s、warmで109.0 tok/sでした。
論文1本くらい(32K)を渡してから書き始めるまでは約14〜18秒で、回ごとのばらつきは大きめです。
10月4日(0.1.38)の当サイトの実測(RTX 5070 Ti・メモリ32GB)では、書き出す速さはcold深さ0の3回中央値が69.6 tok/s、warmで91.0 tok/sで、初回だけはSSDからの読み込みで30.0 tok/sでした。
資料を読む速さは341.7〜581.6 tok/sで、最初の文字が出るまで論文1本くらい(32K)で57.4秒、本1冊分くらい(128K)で約4分かかりました。
1Mコンテキストは使える?
今回の構成では確かめられていません。
本1冊分くらいにあたる131,072トークン(128K)で起動し、合言葉テストは2回とも正答しましたが、3回目は空きメモリが500MiBを切ったまま60秒続き、監視が停止しました。
128Kの3回目で止まった時点で、256K・512K・1Mは試さずに打ち切っています。
Strataの導入に管理者権限は要る?何が入る?
管理者権限は要りません。
10月4日にStrata 0.1.38を入れたときの主な書き込みは、ユーザー用に入れたPython 3.12.10(ユーザーのPATHに2項目追加)、Strataの設定ファイル(通常は%APPDATA%\Strata\settings.json)、Strataフォルダ内の仮想環境・エンジン・モデルです。
0.2.5からはインストーラーかTerminalで入れる形に変わり、エンジンは%LOCALAPPDATA%\Strata、状態の記録は~/.strataに入るユーザー単位の導入です。
AIの中身にあたるモデル本体は、Q2_0で約66.4GBあります。
Qwen3.8-27Bとどちらを使えばよい?
使い方で分かれ、125Bの答えを短い質問で試したいならQwen3.8-Flash-Next、作業台(VRAM)に収めて余白を残したまま使いたいならQwen3.8-27Bが候補です。
今回のStrataでは資料を読む速さが341.7〜581.6 tok/sで、長い資料ほど待ち時間が伸びました。
27Bの量子化の選び方と実測はQwen3.8-27Bの16GB実測の記事にまとめています。
- 計測日:2026年10月4日(導入作業は10月3日夜から)
- 機材:FRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB〔16,303MiB〕・Core Ultra 7 265F・メモリ32GB〔増設なし〕)
- OS・ドライバ:Windows 11 Pro(26100)・NVIDIAドライバ616.64
- ソフト:Strata main 99f3dbd0(2026年10月3日)・出来合いエンジン0.1.38・Python 3.12.10
- モデル:Qwen3.8-Flash-Next Q2_0(ISTA-DASLab配布のGGUF・2分割・合計約66.4GB)+MTP層
- 速度:StrataのAPI・MTPあり・入力は深さ+512トークン・出力128トークン・3回の中央値(エンジンログの値)
- cold/warm:coldは会話の再利用(KV)を避けた要求で、OSのファイルキャッシュは空にしていない。warmは同じ前置きを先に読ませて再利用した要求(深さ0は前置きがないので、coldと同じ形の要求を続けて3回)
- 長い文脈:131,072で起動・入力約128,478トークン・中央付近に日本語の合言葉1つ。中央値は完了2回から算出
- 回答品質:9月8日と同じ自作20課題・context 8192・temperature 0・各課題1回
- メモリ・VRAM:1秒ごとの監視の標本内のピーク(最小)値
- 既存アプリは閉じずに計測(GPUを使う別アプリが一覧に残っていた)。他のアプリの影響を完全に除いた値ではない
- ページファイルは自動管理のまま(OSが2,048MBから2,812MBに拡大)
- 測り直し:2026年11月5日・Strata 0.2.10(エンジン0.1.56)・NVIDIAドライバ621.01・同じQ2_0・64K・出力128トークン・Thinkingオフ・temperature 0・MTPとDFlash2で各3回の中央値(サーバーが返す値)。計測した項目は出力と読み込みの速さ