RTX Spark vs Mac M5 Max vs RTX 5090|ローカルLLMに向くのはどれ?帯域・メモリで比較【2026年】
LLMの講座を3年前に受講してから、「ローカルで生成AIを動かしたい」という目標があります。
LLMを学ぶと、ローカル環境での生成AIの実行が最終目標だとわかります。
しかし、多額の予算がなく、まだ実現できていません。
生成AIを自分のPCの中で動かすとなると、候補はMac(M5 Max・M5 Ultra)、RTX 5090を搭載したデスクトップ、2026年6月に登場したRTX Sparkの3つに絞られます。
RTX Sparkは、大容量の統合メモリとCUDAを薄型ノートに搭載した新しいタイプの1台です。
スペックと当サイトの実測を突き合わせて、「結局RTX Sparkは本命候補に入るのか」を解説します。
「そもそもRTX Sparkって何? 今買うべきか待つべきか」はRTX SparkとDGX Sparkの違いと、どれを買うか待つかのガイドで解説しています。
- ローカルAIを動かすPCは、大きなモデルを載せる「メモリの量」と、答えを書く速さを決める「メモリ帯域」の2つで選ぶ
- RTX Sparkは128GBの統合メモリとCUDAを両立する唯一のノートだが、帯域は3者で最も低い
- 本命は速さ重視のRTX 5090、大きなモデルを丸ごと動かすMac M5 Max・M5 Ultra
- StrataのMac対応で評価が変わる可能性があり、詳しくはStrataの解説記事で更新していく
この記事は、2026年10月16日時点のNVIDIA・Apple・Microsoft・Arm・MediaTekの各公式発表と、当サイトの実測をベースにしています。
結論:ローカルLLMならどれを選ぶか【2026年】
用途がゲームや一般作業で、今すぐPCが要るなら、現行モデルを買って問題ありません。
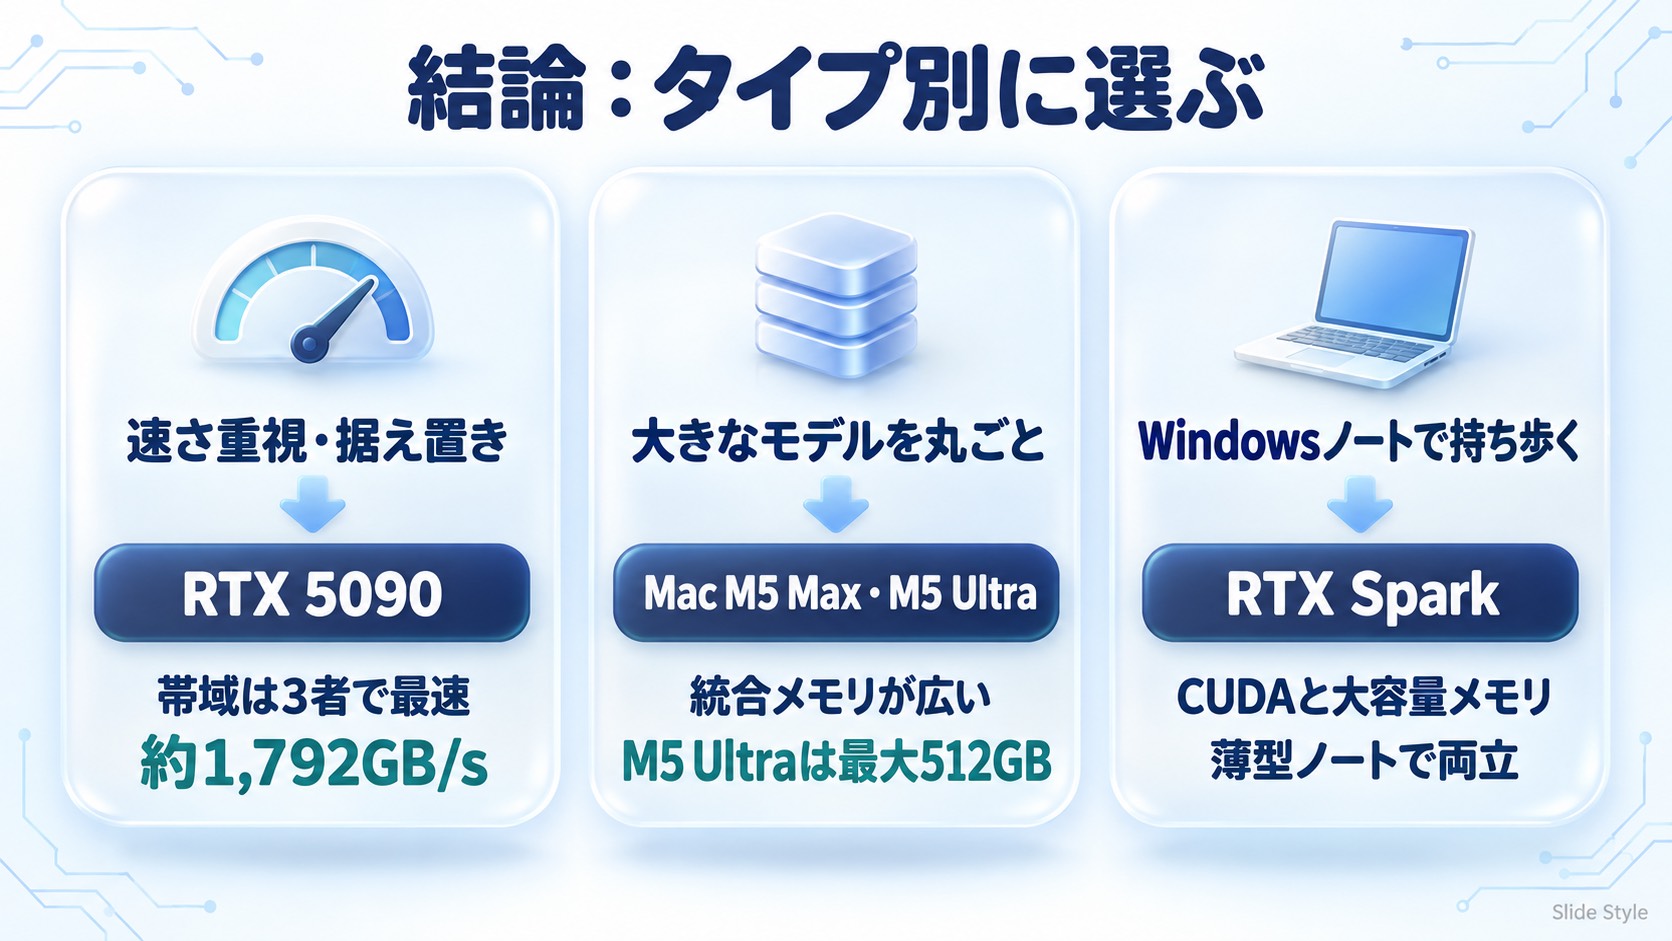
ローカルAIを本格的に動かすなら、用途によって本命が分かれます。
- 速さ重視・据え置きでよい → RTX 5090。
帯域約1,792GB/sで中型モデルなら最速、画像生成もCUDAの資産を活かせる。
VRAM 32GBの壁と電力は割り切る前提 - 大きなモデルを丸ごと動かしたい → Mac M5 Max・Mac Studio M5 Ultra(最大512GB)。
帯域も実用的で、静音・省電力。
1台で携帯まで済ませたい人はM5 Max、大容量の統合メモリでも足りない人はM5 Ultraが軸になる - Windowsノートで CUDA と大容量メモリを持ち歩きたい → RTX Spark。
大容量の統合メモリとCUDAを持ち歩ける点が特徴だが、帯域300GB/sは3者で最も低く、発売後の実測とArm対応の確認が要る
RTX Sparkは、大容量の統合メモリとCUDAを持ち歩きたい人の候補です。
一方、開発時の待ち時間に関わるメモリ帯域は3者で一番低く、速さを優先すると本命から外れます。
価格・スペックと当サイトの実測から、用途に合う機種を解説します。
本格的にローカルAIを使うなら、現時点ではMac M5 Maxを軸に、速さが必要な場面で据え置きのRTX 5090を足す形がおすすめです。
大容量の統合メモリでは足りないと分かっている人だけ、M5 Ultraを軸に据えます。
RTX Sparkは、発売後に実測の速度とArm対応の進み具合を見てから判断したいモデルです。
- この節の要点:ゲーム・一般用途なら現行モデルでよい
- ローカルAIを本格的に使うなら、速さはRTX 5090、大容量はMac M5 Max・M5 Ultra
- RTX Sparkは大容量メモリとCUDAを持ち歩けるが、帯域の低さが弱点
候補の機種と価格【2026年】
表は1行に1機種をまとめています。
「AIで使えるメモリ」の列はモデルを載せられる容量、右端のボタンは購入ページへのリンクです。
RTX Spark搭載ノートは、日本で価格が出ているSurface Laptop Ultraが発売済み、MSI Prestige N16 Flip AI+が予約受付中です。
NVIDIAの公式発表では、この2機種のほかにもAcer・ASUS・Dell・HP・Lenovo・MSIの各社から順次登場する予定です。
| 機種 | AIで使えるメモリ | 主な構成 | 価格(確認日) | 購入 |
| フロンティア FRGHLB850/WS1013 セール会場の機種 | RTX 5090(VRAM 32GB) | Ryzen 9 9950X3D2 Dual Edition/メモリ64GB/4TB(Gen5)/1200W | 1,499,800円 (10月22日時点・受注生産で注文できる表示) | 公式ページを見る |
| フロンティア FRMFGZ890/270K MSIコラボモデル | RTX 5090(VRAM 32GB) | Core Ultra 7 270K Plus/メモリ32GB/1TB/1500W | 1,279,800円 (10月22日時点・在庫なしの表示) | 公式ページを見る |
| フロンティア FRGBLMB650/SG3 | RTX 5090(VRAM 32GB) | Ryzen 9 9950X3D/メモリ64GB/2TB/1200W | 1,399,800円 (10月22日時点・在庫なしの表示) | 公式ページを見る |
| マウス G TUNE FG-A9G90 | RTX 5090(VRAM 32GB) | Ryzen 9 9900X/メモリ64GB/2TB/1200W | 1,469,800円から (10月22日時点・品切れ中の表示) | 公式ページを見る |
| HP OMEN MAX 45L パラマウント ≫ 解説記事を読む | RTX 5090(VRAM 32GB) | Ryzen 9 9950X3D/メモリ32GB/2TB/1200W | 1,298,000円 (10月22日時点・欠品中(再入荷待ち)の表示。HP直販は構成が復活することがあります) | HP公式で在庫を見る |
| MacBook Pro(M5 Max) | 統合メモリ 最大128GB | GPUコア数で帯域が変わる(32コア460GB/s・40コア614GB/s) | 構成ごとにAmazonで確認 | Amazonで見る |
| Mac Studio(M5 Ultra) | 統合メモリ 最大512GB | 帯域1.2TB/s(64・80コアGPU共通)。949,800円から | 構成ごとにAmazonで確認 | Amazonで見る |
| Microsoft Surface Laptop Ultra RTX Spark搭載・15型ノート ≫ 解説記事を読む | 統合メモリ 24GB〜128GB | RTX Spark(5,120コアまたは6,144コアGPU)/2.0kg/10月16日発売 | 513,480円から 128GB・1TBは1,094,280円 (価格はMicrosoft Store・2026年10月9日確認・10月16日発売) | Amazonで探す |
| MSI Prestige N16 Flip AI+ RTX Spark搭載・16型2in1 ≫ 解説記事を読む | 統合メモリ 128GB/64GB | RTX Spark(6,144コアGPU)/約1.9kg/公式ストア・販売店で予約受付中 | 128GBは販売店で1,459,800円 64GBはMSI STOREで1,099,800円 (税込・どの店も同じ価格・2026年10月9日確認) | Amazonで探す |
2026年10月22日時点で、RTX 5090のデスクトップを公式ページから注文できたのは、フロンティアのセール会場に10月19日に追加されたFRGHLB850/WS1013だけでした。
ほかの4機種は注文できない表示です。
WS1013は週替わりのセール会場に並ぶ機種のため、会場の入れ替えで表示が変わることがあります。
在庫の表示は日によって変わるため、当サイトでは毎日公式ページを確認し、変わったらこの表を直します。
同じボディでインテルCPUのHyperX OMEN MAX 45Lも、同じ時点で欠品中(再入荷待ち)の表示でした。
レノボの日本の直販サイトには、2026年10月9日時点でRTX 5090を選べるデスクトップがありませんでした。
HPの構成は「欠品中」でも販売終了ではなく、週替わりで復活することがあるため、購入を考えている人には、定期的な公式ページの確認をおすすめします。
Mac Studio(M5 Ultra)は949,800円からと、表のRTX 5090デスクトップより価格は下がります。
帯域1.2TB/s・最大512GBという構成は、RTX 5090のVRAM 32GBやM5 Maxの統合メモリには載せきれない、大きなモデルを丸ごと動かす用途に向いています。
VRAMに載りきらないモデルの一部をメインメモリへ逃がす使い方まで考えるなら、メモリ64GBの構成が余裕を取りやすい一方、在庫や価格は構成によって変わります。
MacBook Pro(M5 Max)は、GPUコア数の多い構成を選ぶほど帯域が上がるため、ローカルAI向けに買うなら構成の確認が欠かせません。
一方でMac Studio(M5 Ultra)は64コア・80コアのどちらを選んでも帯域は変わりません。
RTX Spark搭載ノートは、Surface Laptop UltraとMSI Prestige N16 Flip AI+の2機種が日本で発表済みです。
どちらも大容量の統合メモリを選べば、Mac M5 Maxと同じ容量を持ち歩けます。
Surface Laptop Ultraは15型で2.0kg、MSI Prestige N16 Flip AI+は16型の2in1で約1.9kgとわずかに軽く、ペンで操作できる2in1という使い方の違いもあります。
同じ構成でもSurfaceは1,094,280円、MSIは販売店で1,459,800円と価格差があり、購入先やタイミングでも変わるため、最新の価格は各解説記事で確認するのがおすすめです。
120万〜140万円前後の機材は、マウスコンピューターなら36回まで手数料0%で分けられます(2026年10月9日時点)。
メーカー別の0%回数と月々の支払い早見表はパソコンの分割払いガイドにまとめています。
RTX 5090や大容量メモリのMacを買う前に、16GBのGPUでどこまでできるかを確かめる方法もあります。
VRAM容量ごとにできることはローカルLLM用のGPU・PCの選び方にまとめています。
- この節の要点:RTX 5090デスクトップで10月22日時点に注文できたのは、フロンティアのWS1013だけ
- Mac M5 Max・M5 Ultraは構成ごとにAmazonで価格を確認する形
- RTX Spark搭載ノートはSurface(10月16日発売)とMSI(予約受付中)の2機種
3つの違いは「メモリの量」と「帯域」と「CUDA」
RTX 5090・Mac M5 Max(M5 Ultra)・RTX Sparkの違いは、3つの軸で説明できます。
どれだけ大きなモデルを載せられるか(メモリの量)、どれだけ速く答えを書けるか(帯域)、どのソフトウェア資産が使えるか(CUDAかMLXか)です。
メモリの量は百科事典を広げる作業台の広さ、帯域は作業台へ本を運ぶ通路の幅にたとえられます。
通路が広いほど一度にたくさん運べて、AIが答えを書くのも速くなります。
| 項目 | RTX 5090 | Apple M5 Max | Apple M5 Ultra | RTX Spark |
| AIで使えるメモリ | 32GB(GDDR7・専用VRAM) | 最大128GB(統合) | 最大512GB(統合) | 最大128GB(統合) |
| メモリ帯域 | 約1,792GB/s | 最大614GB/s(40コアGPU) | 1.2TB/s | 300GB/s(NVIDIAの開発者向け資料・製品ページには記載なし) |
| エコシステム | CUDA(業界標準) | MLX / Metal | MLX / Metal | CUDA(業界標準) |
| OS | Windows(x86/x64) | macOS | macOS | Windows on Arm |
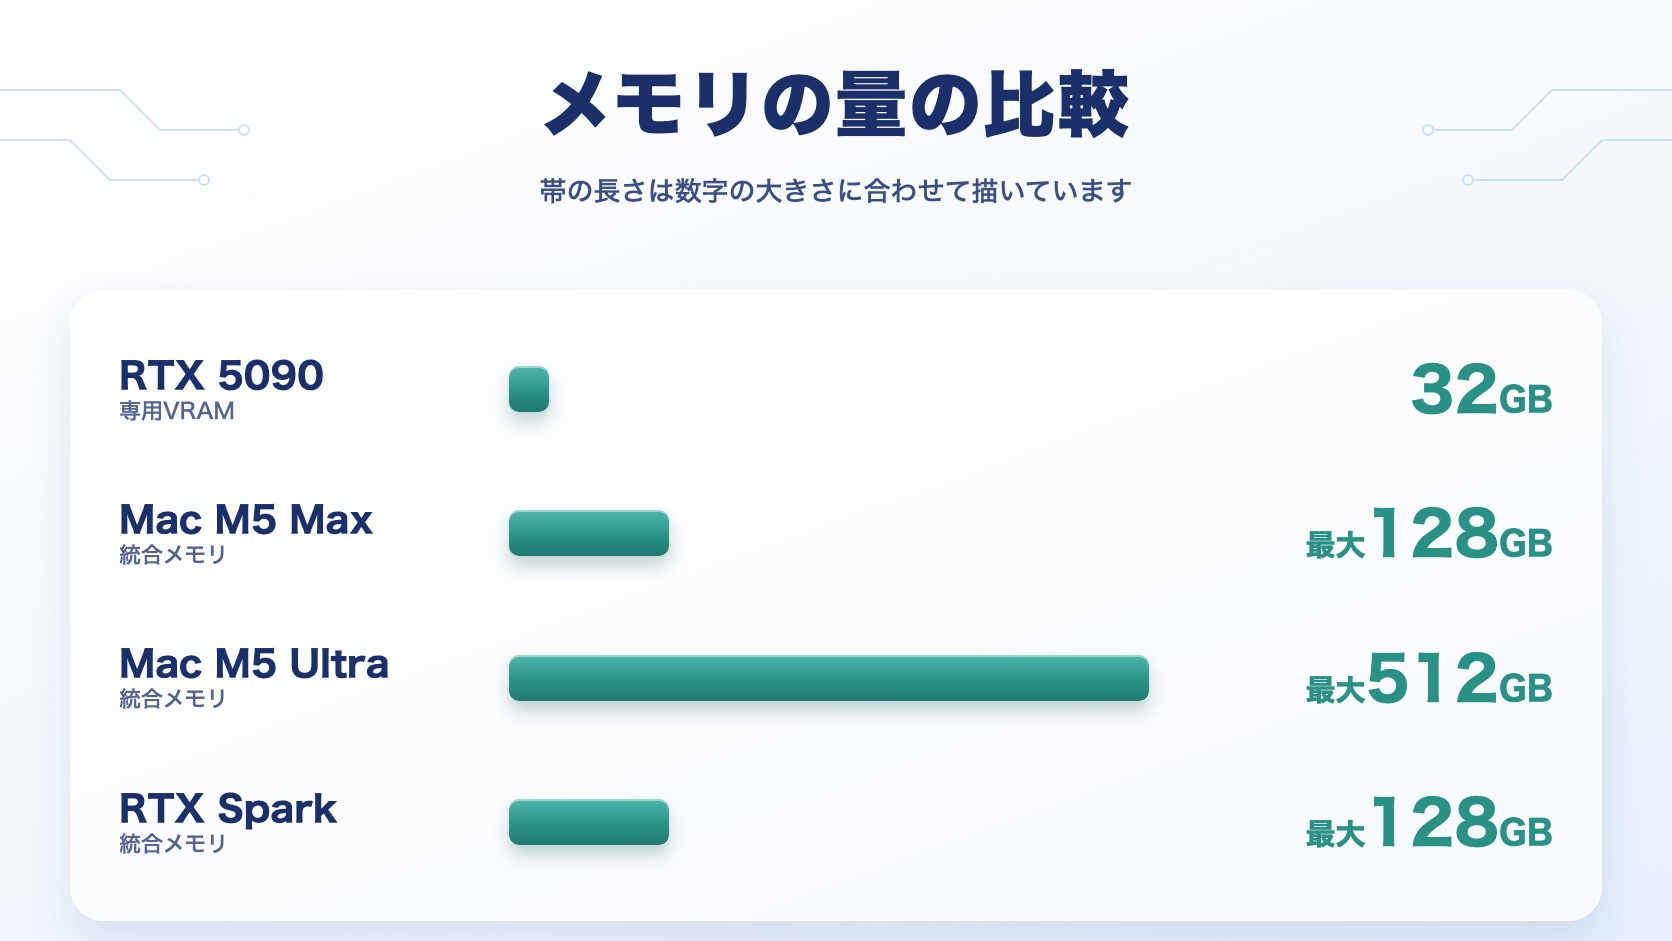
メモリの量 — 大きなモデルを丸ごと載せられるか
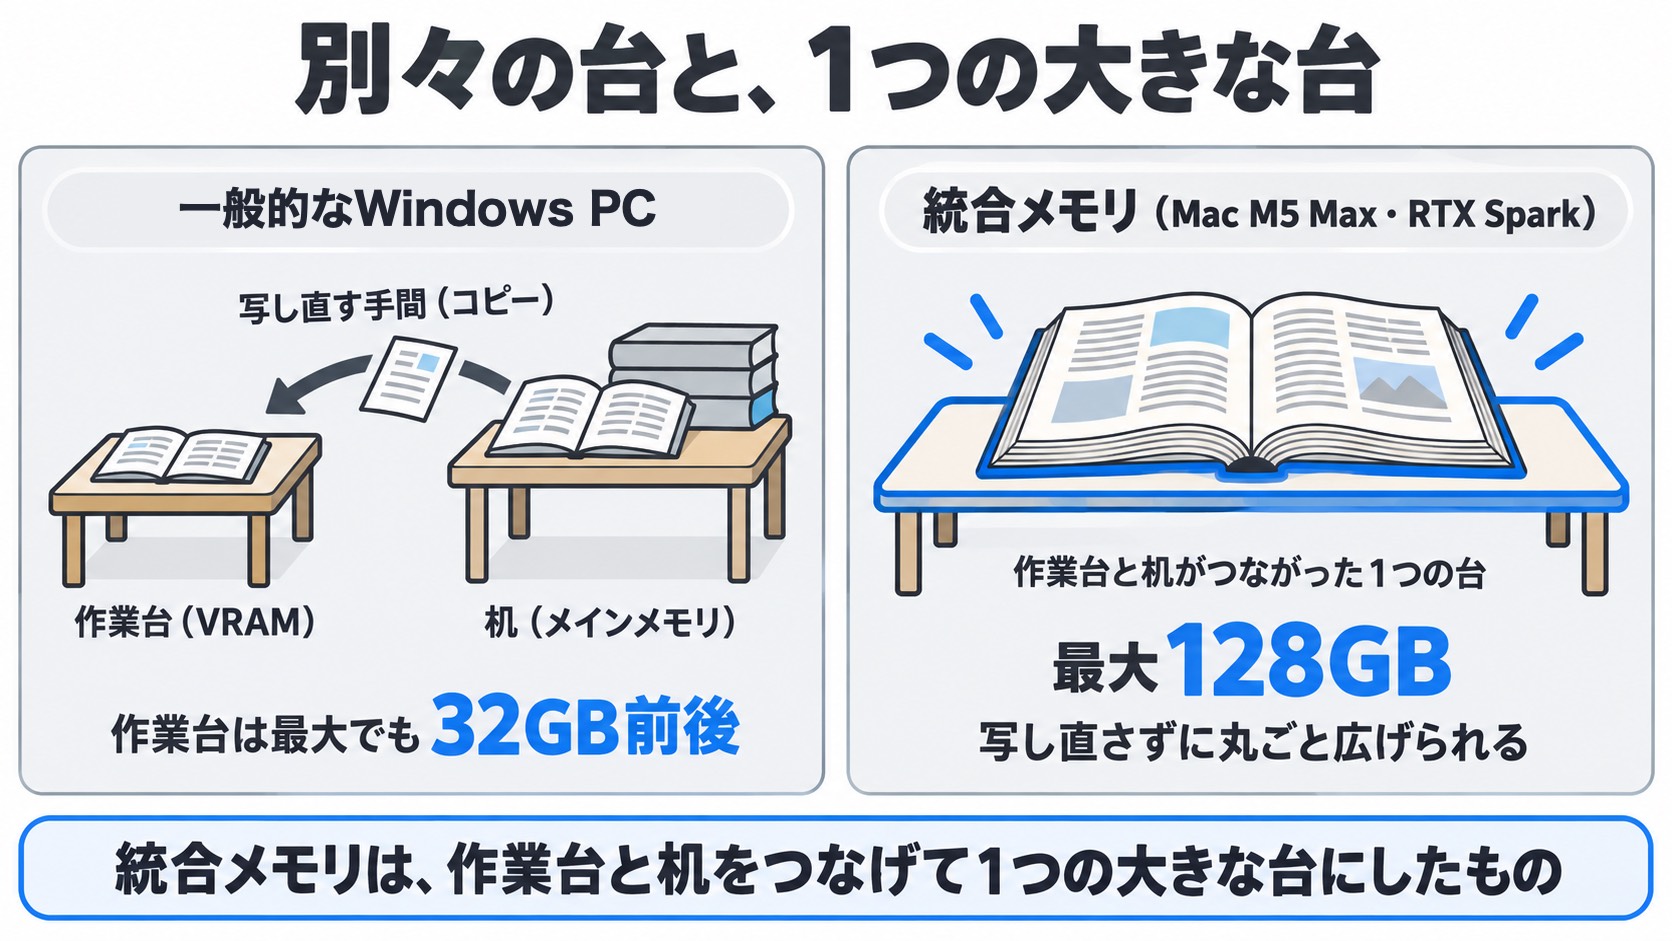
RTX 5090は専用のVRAM32GBが作業台で、GPUにデータを渡すたびに写し直す手間が発生し、大きなモデルは載りきりません。
Mac(M5 Max以上)とRTX Sparkは、CPUとGPUが同じメモリを共有する統合メモリで、写し直さずに巨大なモデルを丸ごと広げられます。
容量だけで見ればMac M5 MaxとRTX Sparkは同じ128GBクラスで、Mac Studio M5 Ultraはさらに上の512GBです。
「大容量の統合メモリ」自体はRTX Sparkの発明ではなく、Appleが先に実現していた仕組みで、巨大モデルを丸ごと載せられる点だけならMacでも前からできていました。
NVIDIA公式の値では、RTX SparkのAIパフォーマンスは最大1ペタフロップス(FP4)で、1,200億パラメータ(120B)級のLLMを最大100万トークンのコンテキストで手元実行できます。
メモリの種類もRTX 5090は専用のGDDR7、Mac・RTX Sparkは統合メモリ用のLPDDR5X系と、そもそも作りが異なります。
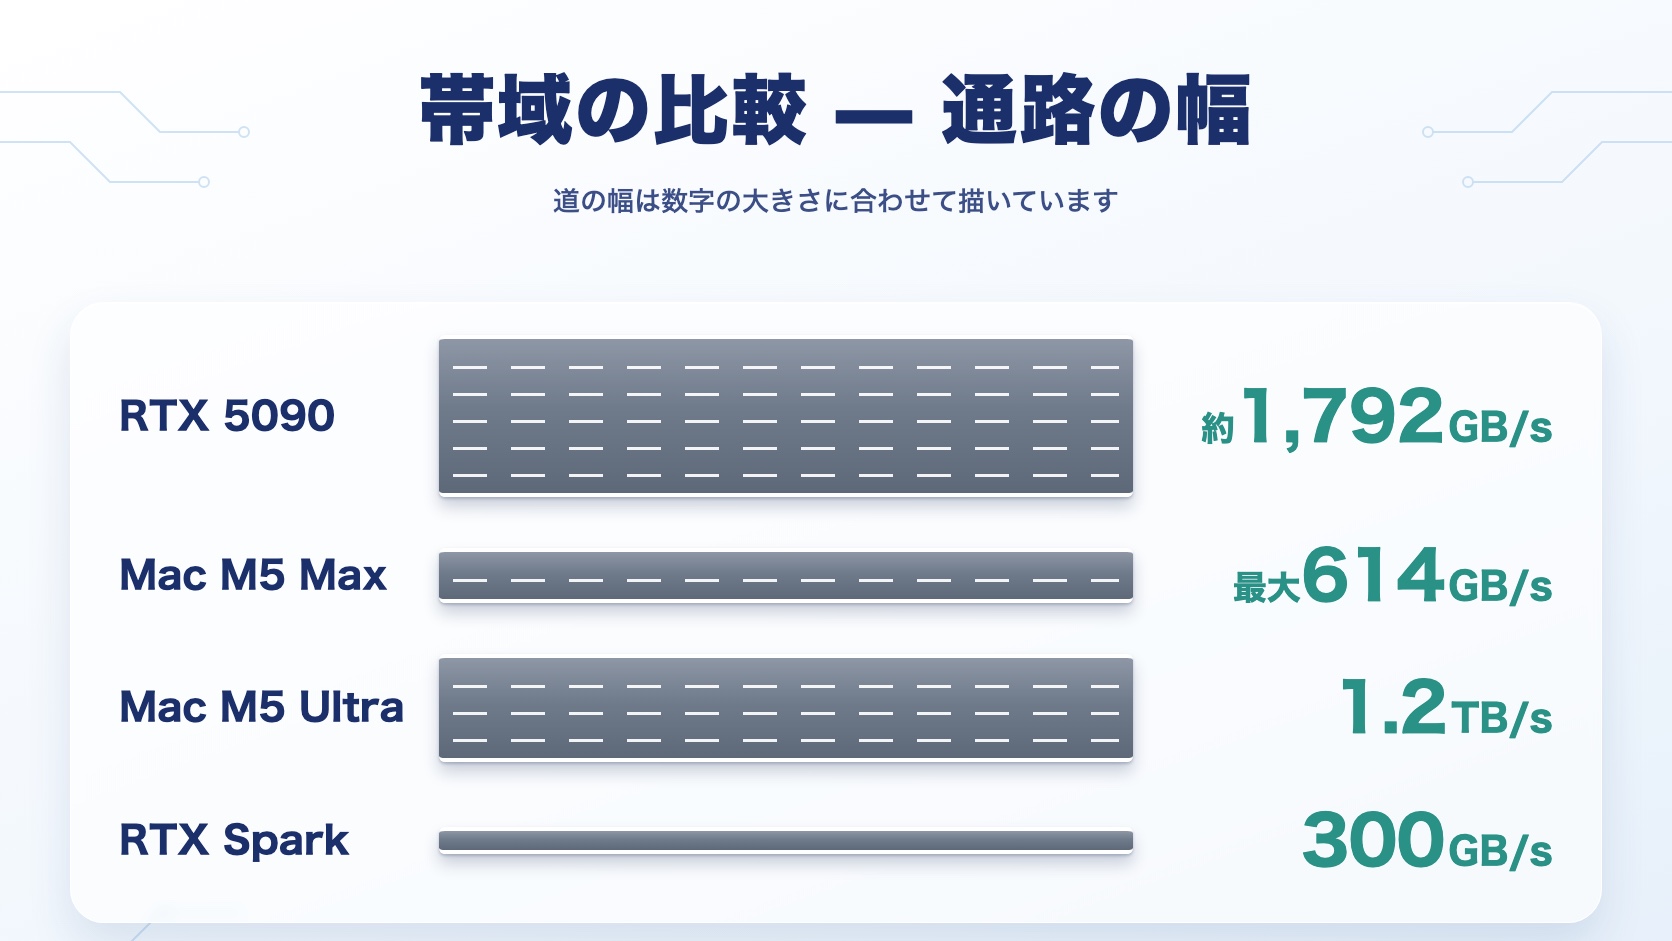
帯域 — 答えを書く速さを決める通路の幅
容量が近いMac M5 MaxとRTX Sparkでも、帯域はMac M5 Maxが614GB/s、RTX SparkはNVIDIAの開発者向け資料で300GB/sと倍以上違います(製品ページには記載なし。同じGB10系のDGX Sparkは公式で273GB/秒)。
RTX Sparkは、作業台(メモリの量)は大広間ほど広いのに、そこへ本を運ぶ通路(帯域)は細い組み合わせです。
大きなモデルを載せることはできても、速く回す場面では通路の細さが足を引っ張ります。
RTX 5090は約1,792GB/sとさらに広く、Mac Studio M5 Ultraの1.2TB/sを含めても、比較した機種で通路がもっとも広いのはRTX 5090です。
対話的に試行錯誤を重ねるコーディング作業では、帯域の差がそのまま答えを待つ時間の差として表れやすくなります。
RTX Sparkと同じGB10系のチップを搭載する開発機(DGX Spark)とその互換機の価格や買い方は、DGX Sparkと互換機の比較にまとめています。
CUDAとMacのMLX — 使えるソフトウェア資産の違い
CUDAは、NVIDIA製GPUでAIを動かすための土台です。
新しいモデルやフレームワーク(vLLM・Unslothなど)はCUDA前提で設計されることが多く、RTX 5090とRTX SparkはどちらもCUDA資産をそのまま使えます。
Macの土台はMLX(Metal)で、新モデルへの対応は速いものの、CUDA前提の最新フレームワークは一手間かかることがあります。
CUDAが使えるかどうかは、最新のAI開発環境をすぐに試せるかに直結します。
RTX Sparkの新しさは、CUDAと大容量の統合メモリを、薄型のWindowsノートで両立した点にあります。
当サイトがRTX 5070 Ti(16GB)でファインチューニング(学習)を試したときは、コードが走るあいだ画面にCUDAの文字が流れていき、「こんな風に使っているんだ」と実感しました。
あの表示を見ると、学習まで考えるならCUDAが使えるRTX 5090が欲しくなります。
RTX 5090はゲーム用というより、Macと比べて選ぶ計算資源です。
学習の実測は16GBのGPUでファインチューニングを試した記事で解説しています。
メモリの量・帯域・CUDAを軸に、3者の強みと弱点を表にまとめます。
| プラットフォーム | 強み | 弱点 |
| RTX 5090 | 帯域約1,792GB/sで中型モデルが最速。CUDAで画像生成にも強い | VRAM 32GBの壁で大型モデルは丸ごと載らない。消費電力が大きい |
| Mac M5 Max | 128GBの統合メモリで大型モデルも丸ごと載る。帯域614GB/sで省電力 | MLX中心でCUDA前提の最新ツールは一手間かかる |
| RTX Spark | 128GB×CUDA×携帯を1台で両立する唯一の組み合わせ | 帯域300GB/sで3者の中でもっとも低い |
RTX 5090は速さと画像生成、Macは容量と省電力、RTX Sparkは携帯性とCUDAが強みです。
どの軸を優先するかで選ぶ機種が変わります。
- この節の要点:容量ではMac M5 MaxとRTX Sparkが同じクラス
- 帯域はM5 Maxの614GB/sがRTX Sparkを大きく上回る
- RTX Sparkの強みはCUDA資産をそのまま使えること
ローカルLLMの速さ
ローカル推論のトークン速度は、ざっくり「メモリ帯域 ÷ モデルのサイズ」で決まります。
同じ帯域でも、モデルが大きくなるほど1トークン書くたびに運ぶデータが増え、速度は落ちます。
比較表に示した帯域の差は、回答を待つ時間にも表れます。
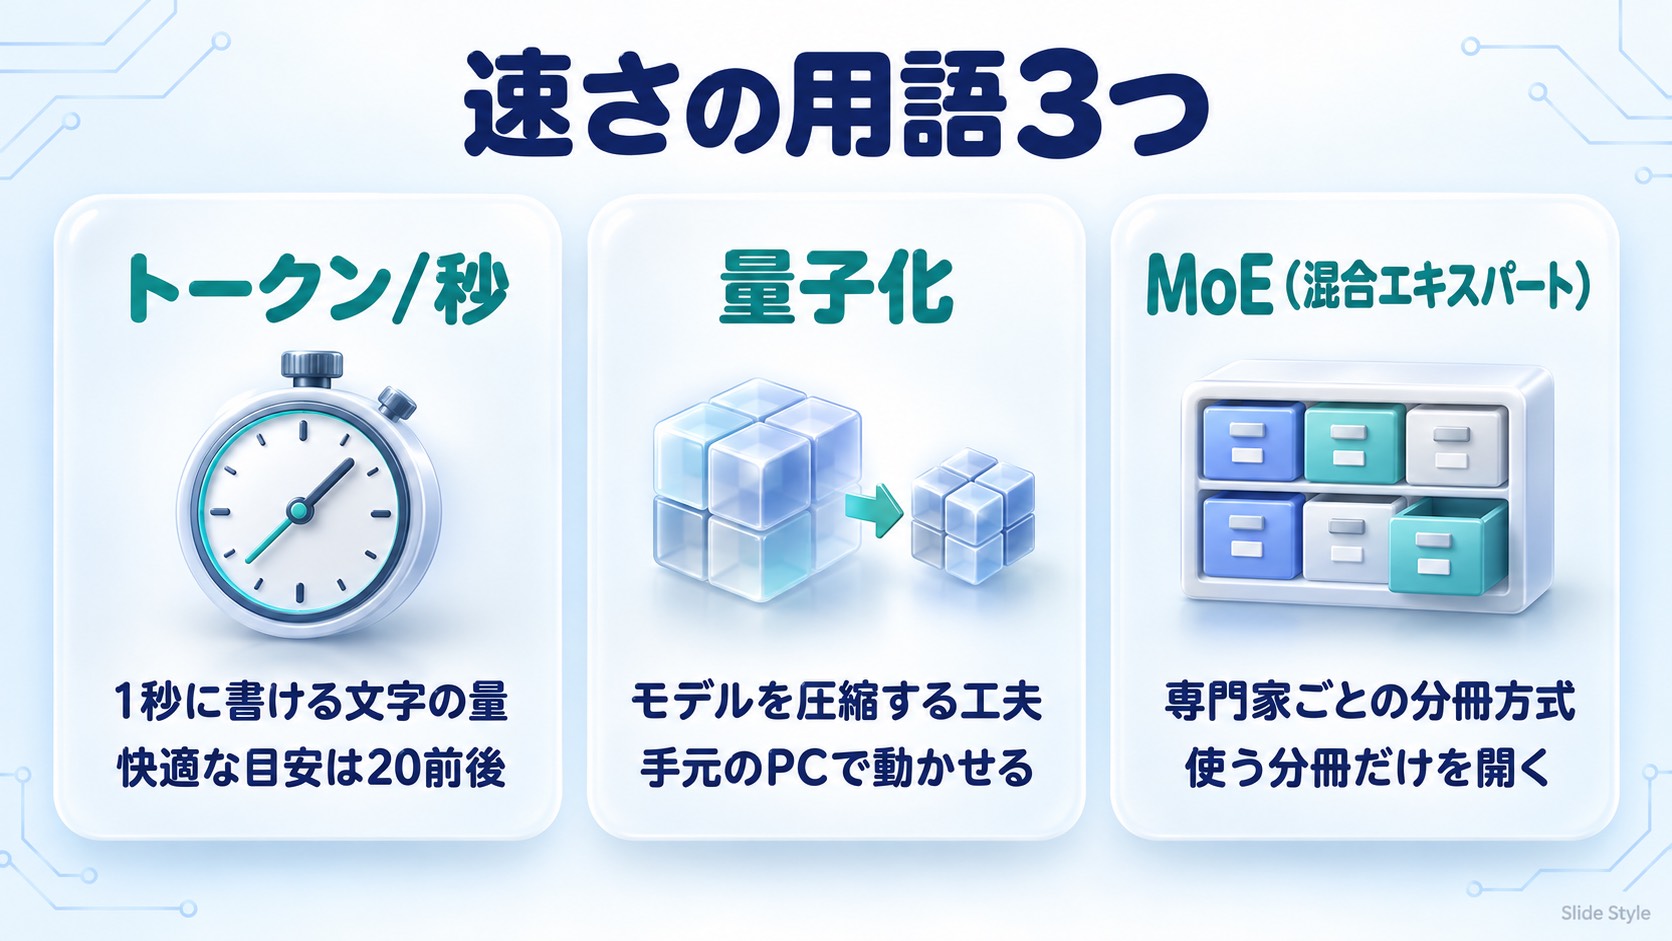
速度の説明で使う言葉は、次の3つです。
トークン/秒(tok/s)は、AIが1秒に書ける文字のかたまりの数で、人が快適に読める目安は20前後です。
量子化(Q4など)は、モデルを圧縮してメモリ使用量を減らす手法で、精度を少し割り引く代わりに手元で動くようにします。
MoE(混合エキスパート)は、モデルが専門家ごとの分冊に分かれていて、1トークンごとに必要な分冊だけを開く方式で、巨大なモデルでも実際に動かす部分は一部に絞られます。
当サイトでは、VRAM16GBのRTX 5070 Tiでgpt-oss-20bを実測しています。
llama.cppのllama-benchで、深さ0(前置きの文章なし)の生成は約226トークン/秒、32K(論文1本くらい)まで文章を積んでも約181トークン/秒でした。
20B級なら、16GBのGPUでも読む速さを大きく超えて動くことが確認できます。
条件と回答品質はgpt-oss-20bの16GB実測にまとめています。
ローカルのコーディング支援で評価が高いQwen3-Coder-Next(80B MoE)は、全体は80Bでも、1トークンごとに動く部分は3Bぶんだけです。
モデル全体が大きくても、速度を保ちやすい設計です。
ただし、この規模のモデルを動かすには大容量の統合メモリが前提です。
より大きなモデルを大容量の統合メモリで動かす場合の速度は、Mac側には次の節で紹介するStrata開発元の計測値があります。
容量が同じでも帯域が倍以上違うため、同じ大型モデルではMac M5 Maxのほうが速く答えを返すと考えられます。
公式値から単純計算すると、答えを書く速さの差は2倍前後です。
実際の速度はソフトウェアの最適化しだいで変わるため、あくまで帯域から見た見立てです。
次の節では、無料ソフトStrataを使った当サイトの実測と、開発元によるMacの計測値を紹介します。
- この節の要点:速度はおおむね「帯域÷モデルのサイズ」で決まる
- 当サイトのRTX 5070 Ti(16GB)実測はgpt-oss-20bで約226トークン/秒
- RTX Sparkの大型モデル実測は発売後の確認待ち
Strataで構図が変わるかもしれない
Strata(ストラータ)は、総125BのQwen3.8-Flash-Nextを普通のPCで動かす無料のオープンソースソフトです。
2026年10月13日のv0.1.44で、Mac(Apple Silicon・Metal)への対応を試験的に追加しました(M1〜M5・macOS 15以上)。
開発元がM5 Maxで測った速度は、量子化Q2_0で毎秒107〜114トークンです(MTPという先読みの仕組みあり)。
当サイトがRTX 5070 Ti(VRAM16GB・メモリ32GB)のWindowsで同じQ2_0を測った数値は毎秒69.6トークン(初回は30.0)です。
GPUの規模・メモリの量・計測条件が違うため、数値だけで順位は付けられません。
ただし、Strataの対応によりMacの評価が上がる可能性はあります。
詳しくはStrataの解説記事で更新していきます。
当サイトのRTX 5070 Ti実測の全体像はQwen3.8-Flash-NextをStrataで動かした実測にまとめています。
- この節の要点:StrataがMacへ試験的に対応(10月13日)
- 開発元の数値はM5 MaxでQ2_0毎秒107〜114トークン
- 当サイトのRTX 5070 Ti実測は毎秒69.6トークン・条件が違うため順位は付けない
RTX Sparkを選ぶ前に知っておきたいこと
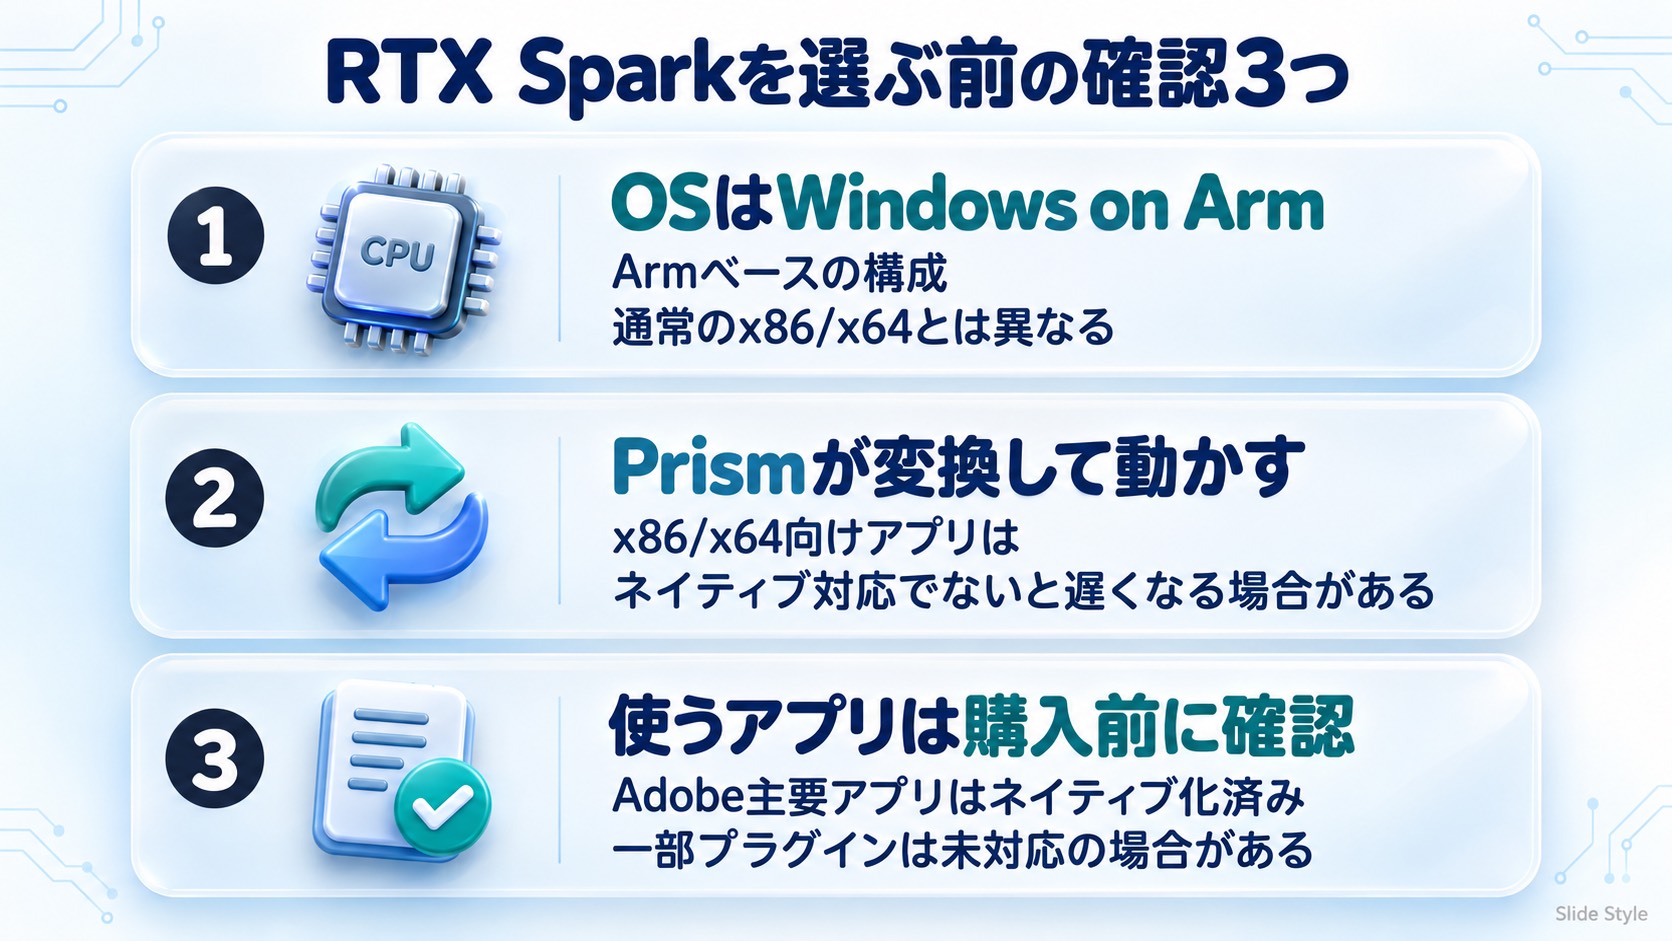
RTX SparkのCPUは、NVIDIAとMediaTekが共同設計したArmベースのNVIDIA Grace CPU(20コア)で、OSもWindows on Armの構成です。
x86/x64向けに作られたアプリは、MicrosoftのPrismというエミュレーション層が翻訳して動かすため、ネイティブ対応していないアプリは遅くなることがあります。
一方、NVIDIAのGPU・CUDA・レイトレーシング・DLSSはエミュレーションを通らずネイティブ動作するため、GPU側の処理は速度が落ちません。
CPU(Arm)とGPU(CUDA)の役割の分かれ方や、同じArm版WindowsのSnapdragon搭載PCとの違いは、RTX SparkとSnapdragon搭載PCの違いの解説で図にしています。
Adobe Premiere Pro・After Effects・Audition・Media EncoderはArm64ネイティブ化済み(v26.0〜)ですが、サードパーティプラグインや一部のRAW/ProRes、H.264/HEVCのハードウェアデコードは未対応の場合があります。
3DCGソフトのBlenderも、5.3でRTX Spark搭載のWindows 11機への対応と統合メモリ向けの最適化が入ります(2026年10月19日時点でベータ版が配布中・正式版は11月10日に公開予定)。
RTX Spark搭載機を買う前に、使いたいアプリの対応状況を確かめておくのがおすすめです。
- この節の要点:RTX SparkはArmベースのWindows on Arm機
- x86/x64向けアプリはPrismのエミュレーションで遅くなる場合がある
- Adobe主要アプリはネイティブ化済みだが、使うアプリの対応状況は購入前に確認する
電力・総コストと、ローカルLLMの賢さの限界
電力と総コスト — 速いだけでは決まらない
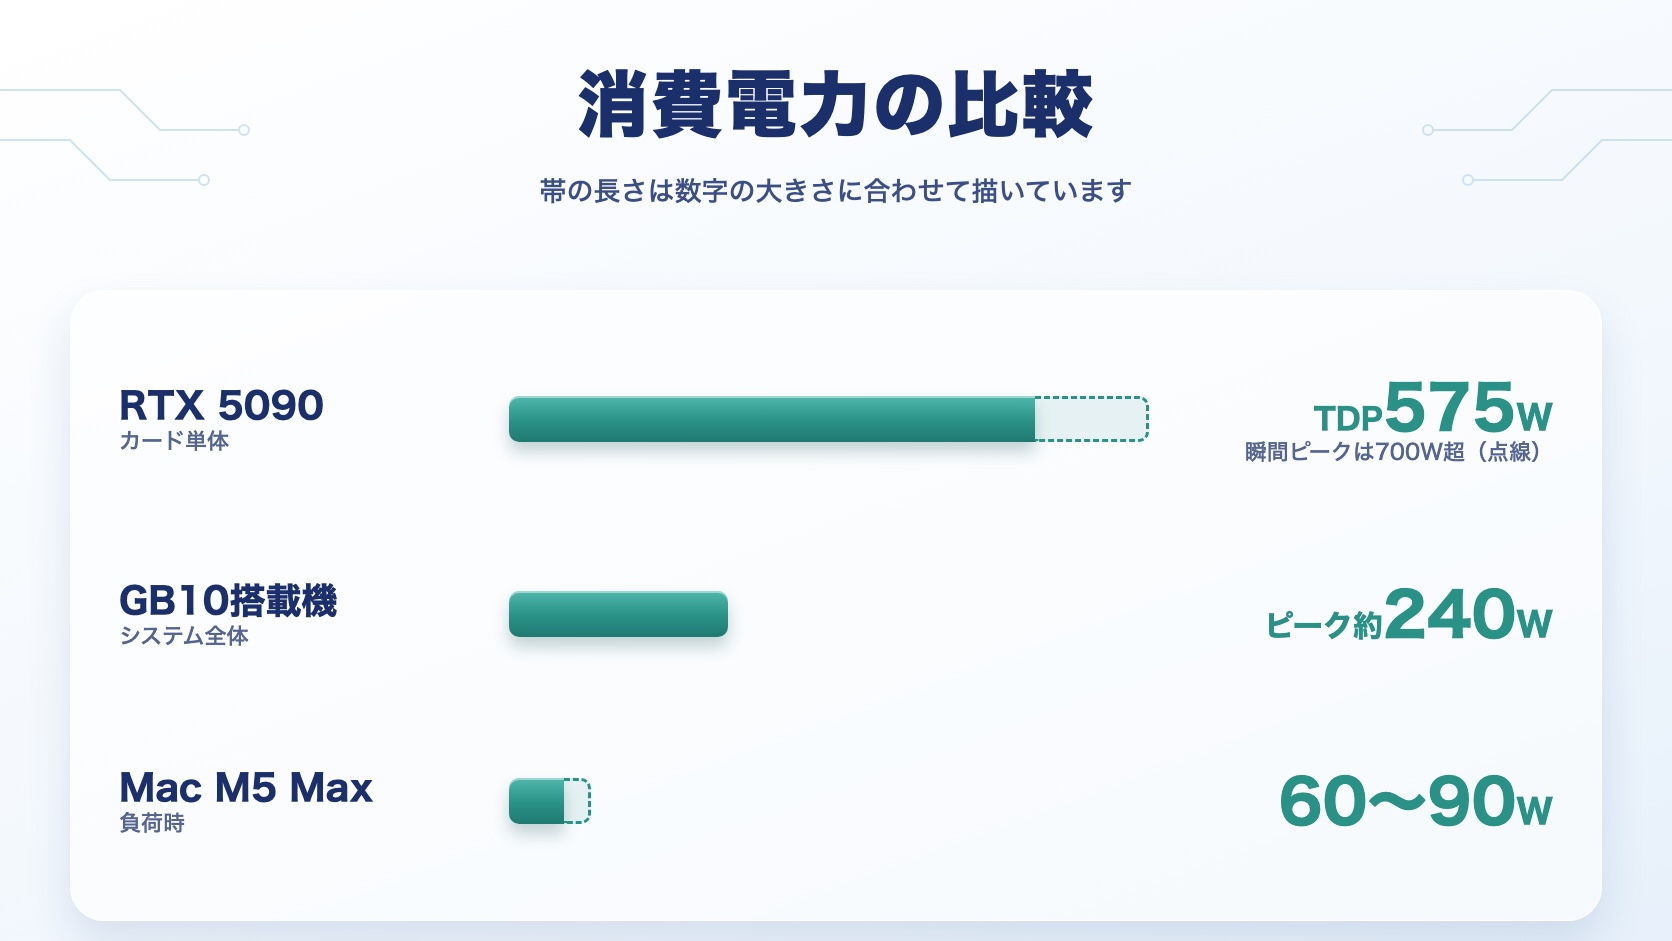
RTX 5090はカード単体でTDP575W、瞬間ピークは700Wを超えます。
画像生成や学習を回すなら頼もしい一方、電気代と発熱・騒音は据え置き専用機として割り切る前提です。
RTX Sparkと同じGB10系のチップを搭載する機種(以下、Spark系)は、システム全体でピーク約240W、アイドル時は約25W前後です。
Mac M5 Maxは負荷時でも60〜90Wに収まります。
1日8時間ローカル推論を回すなら、RTX 5090の消費電力はSpark系の2倍以上、Macの6〜9倍にあたる計算です。
本体価格だけでなく、数年使ったときの電気代まで含めて見ると、省電力のMac・Spark系と、ハイパフォーマンス・高消費電力のRTX 5090で性格がはっきり分かれます。
RTX Spark搭載機はノートとして設計されているため、動作音も据え置きのゲーミングPCほど大きくなりにくいと考えられます。
据え置きで電源とスペースを確保できるならRTX 5090、持ち歩きながら長時間の処理を見守りたいならMacやRTX Spark搭載ノート、という使い方の違いにもつながります。
3年前にLLMをローカルで構築する環境を調べた時も、最後まで電力問題を解決できませんでした。
ローカルLLMの賢さの限界 — クラウドのClaudeには届かない
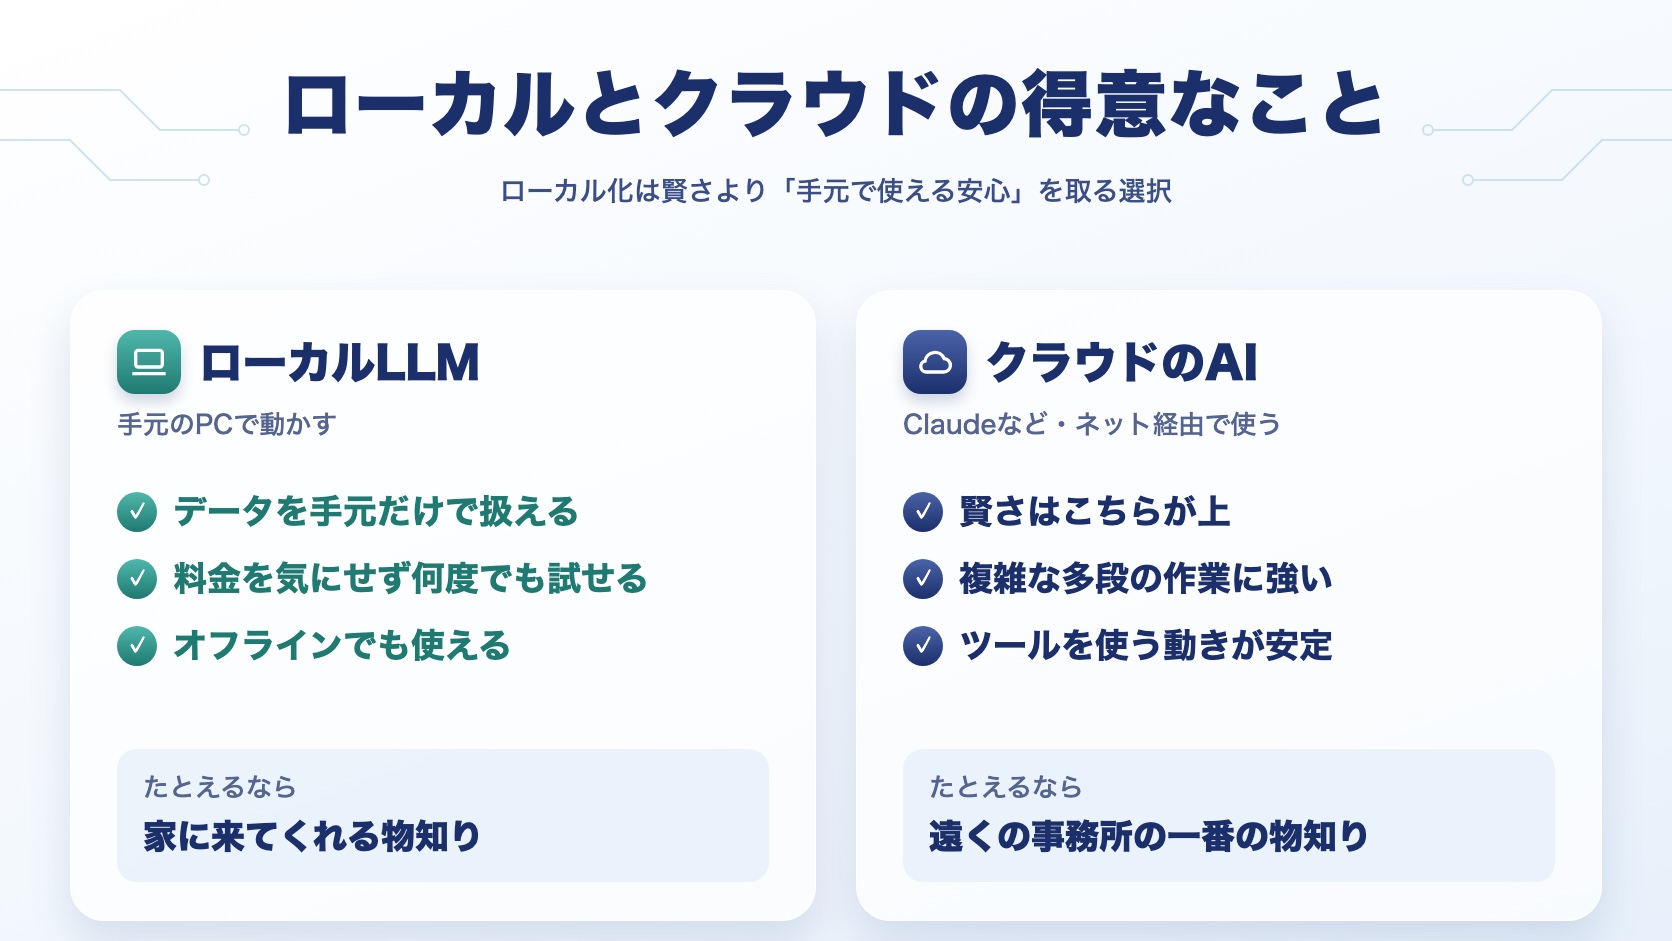
家に来てもらえる物知りの人は気軽に頼めますが、遠くの事務所にいる一番の物知り(クラウドのClaude)ほど博識とは限りません。
ローカルで評価の高いコーダーモデルQwen3-Coder-Next(80B MoE)は、プログラムの不具合を直せるかを測るSWE-bench Verifiedで約67%です。
クラウドの最新Claude本体のSWE-bench Verifiedの数値はAnthropicが公式には出していませんが、公開済みの各種ベンチマークを見る限り、ローカルモデルはクラウドの水準には届いていません。
複雑な多段タスクでは精度が下がり、ファイル操作などの道具を使う動き(ツール呼び出し)が不安定になったり、存在しないファイルパスを書いてしまったりする場面が増えやすいという報告もあります。
ローカル化は、賢さよりも、プライバシーを守り、コストを抑え、オフラインで使うための選択です。
だからこそ、ローカルLLMの強化が重要です。
受講した講座でも、そこがゴールとして扱われていました。
賢さの差はあっても、ローカルLLMをClaude Codeなどのコーディング支援ツールに直接つなぐハードルは下がっています。
Ollamaがv0.14.0からAnthropicのMessages APIにネイティブ対応し、翻訳レイヤーなしでローカルモデルに繋げられるようになりました。
LiteLLMのようなプロキシ(間に立つ取り次ぎ役)を挟む方法もあり、設定は環境にもよりますが数十分ほどで済みます。
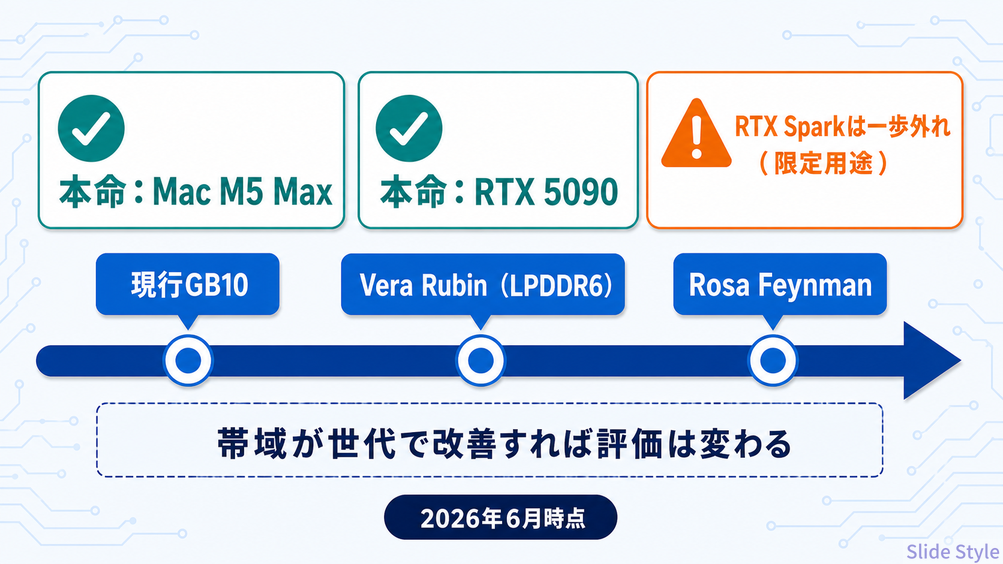
NVIDIAは現行世代で止めるつもりはなく、より速いメモリを搭載する次世代「Vera Rubin」、さらに先の「Rosa Feynman」という世代を予告しています。
今の弱点である帯域が世代を追って広がっていけば、RTX Sparkの評価は今後変わっていく可能性があります。
本命から外れるのはあくまで2026年の今の話で、AI関連の環境は今後もアップデートされていきます。
- この節の要点:RTX 5090はSpark系の2倍以上、Macの6〜9倍の電力がかかる
- ローカルの最良コーダーモデルでもSWE-bench Verifiedは約67%
- ローカル化の利点はプライバシー・コスト・オフラインで使えること
まとめ
ローカルAIの1台は、どのくらい大きなモデルを、どのくらいの速さで動かしたいかで決まります。
メモリの量・帯域・CUDAの3つの軸を踏まえ、現時点の判断を解説します。
- ゲーム・一般用途は現行モデルを今すぐ買って問題なし
- ローカルAIを本格的に使うなら、速さはRTX 5090、大容量はMac M5 Max・M5 Ultraが本命
- RTX Sparkは128GBとCUDAを持ち歩けるが、帯域300GB/sが弱点
- StrataのMac対応で評価が変わる可能性があり、Strataの解説記事で更新していく
- RTX 5090のデスクトップは在庫の変動が大きく、購入前に公式ページで確認する
価格・在庫・Arm対応の進み具合は、各解説記事とこの記事で随時更新していきます。
よくある質問(FAQ)
ローカルでLLMを動かすには、どれくらいのメモリが必要ですか?
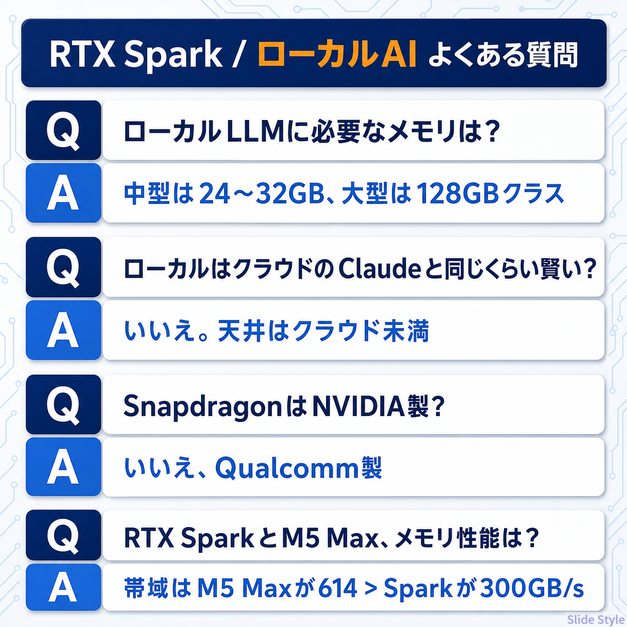
24〜32B級のコーダーモデル(Devstral 24B・Qwen 27Bなど)なら、24〜32GBのVRAMでも動きます。
Qwen3-Coder-Next(80B MoE)のような大型モデルを丸ごと載せるなら、大容量の統合メモリ(Mac M5 MaxやRTX Spark)が目安です。
GPUのVRAMに全部載らない場合は、一部をメインメモリへ逃がす形でも動かせますが、そのぶん速度は落ちます。
RTX SparkとMac M5 Max、どちらが速いですか?
容量はどちらも最大128GBで同じですが、帯域(データを運ぶ通路の幅)はMac M5 Maxが614GB/s、RTX SparkはNVIDIAの開発者向け資料で300GB/s(製品ページには記載なし)。
帯域ではMac M5 Maxが上回り、RTX SparkはCUDAエコシステムで差別化します。
同じ大きさのモデルを動かす場面では、帯域の差がそのまま答えを書く速さの差として表れやすいとみられます。
生成AIをやるならMacとWindowsどちらが良いですか?
速度と対応フレームワークの広さならCUDAのNVIDIA系、大容量モデルと省電力ならMacが有利です。
画像生成や学習タスクもCUDA系のNVIDIAが強い分野です。
発熱と騒音が少ない点もMacの日常使いでは効いてきます。
RTX Sparkは両者の利点を1台に狙った設計ですが、帯域が狭く、速度の面では本命のMac M5 MaxやRTX 5090に一歩譲ります。
RTX Sparkでも、アプリの動作が遅くなりますか?
Arm64にネイティブ対応していないアプリは、エミュレーションを挟むぶん遅くなることがあります。
Adobeの主要アプリはArm64ネイティブ化済みですが、プラグインなど一部は未対応の場合があるため、購入前に使うアプリの最新の対応状況を確かめておくと安心です。
一方、GPU・CUDA・レイトレーシングなどNVIDIAのGPU処理自体はエミュレーションを通らないため、速度が落ちません。
StrataはMacで使えますか?
2026年10月13日のv0.1.44から、Apple Silicon搭載Mac(M1〜M5・macOS 15以上)に試験的に対応しています。
開発元の計測ではM5 MaxでQ2_0が毎秒107〜114トークンです。
メモリが少ないMacではSSDから読みながら動かす形になり、速度はさらに下がります。
Command Line Toolsを入れてから`./setup.sh`を実行すると、Macでもエンジンがビルドされます。
詳しくはStrataの解説記事で更新しています。
Mac Studioを2台つなぐと、もっと大きなモデルを動かせますか?
MLXの公式ドキュメントでは、Thunderbolt 5でつないだMacどうしで計算を分け合う仕組み(JACCL)が案内されています。
モデルを2台に分けて動かす「テンソル並列」もこの仕組みで動かせます。
macOS 26.2以降が条件で、最初にmacOSの復旧モードで設定を有効にする手順があります。
M5 Ultra搭載のMac Studioは1台949,800円から(2026年10月17日時点・Apple Store)で、2台そろえると約190万円からです。
2台構成の速さは、MLXの公式ドキュメントに数値が出ていません。
125B級のQwen3.8-Flash-Nextなら、当サイトはVRAM 16GBのRTX 5070 Ti搭載デスクトップで動くことをStrataの実測記事で確かめています。
512GBのMac Studioを待たずに2台で始める考え方や、MacとRTX機を予算で比べた結果は、MacでローカルLLMを動かす記事で解説しています。
参考ソース(公式)
この記事で使った数値・事実の出典です。
価格や発売状況のように確認日が変わるものは、本文の各該当箇所に時点を明記しています。
- NVIDIA公式 製品ページ:https://www.nvidia.com/ja-jp/products/rtx-spark/
- NVIDIA Windows on Arm Porting Guide「System Overview」(RTX Spark のメモリ帯域 300GB/s・256ビット):https://docs.nvidia.com/rtx-spark/rtx-spark-porting-guide/latest/overview.html(2026年10月10日確認)
- NVIDIA DGX Spark ユーザーガイド「Hardware Overview」(DGX Spark のメモリ帯域 273GB/s):https://docs.nvidia.com/dgx/dgx-spark/hardware.html(2026年10月10日確認)
- NVIDIA Newsroom(RTX Spark / Microsoft 共同発表):https://nvidianews.nvidia.com/news/nvidia-microsoft-windows-pcs-agents-rtx-spark
- Arm 公式 newsroom:https://newsroom.arm.com/news/arm-agentic-pc-era-with-nvidia-rtx-spark
- MediaTek 公式プレスルーム:https://www.mediatek.com/press-room/mediatek-collaborates-with-nvidia-on-rtx-spark-to-power-the-next-wave-of-windows-pc-experiences
- Microsoft Windows Experience Blog:https://blogs.windows.com/windowsexperience/2026/05/31/introducing-a-powerful-new-chapter-for-windows-pcs-accelerated-by-nvidia-rtx-spark/
- Apple Newsroom(M5 Pro / M5 Max・2026年3月):https://www.apple.com/newsroom/2026/03/apple-debuts-m5-pro-and-m5-max-to-supercharge-the-most-demanding-pro-workflows/
- Adobe 公式(Windows on Arm 対応状況):https://helpx.adobe.com/x-productkb/multi/windows-arm-support.html
- Strata 公式GitHub(Mac対応・v0.1.44リリースノート):https://github.com/Niko1221/Strata/releases/tag/v0.1.44
- MLX 公式ドキュメント「Distributed Communication」(JACCL・Thunderbolt 5 の RDMA・macOS 26.2 以降):https://ml-explore.github.io/mlx/build/html/usage/distributed.html(2026年10月17日確認)
- Apple Store(Mac Studio の価格):https://www.apple.com/jp/shop/buy-mac/mac-studio(2026年10月17日確認)
- Blender 5.3 リリースノート「Cycles」(RTX Spark 対応・統合メモリの最適化):https://developer.blender.org/docs/release_notes/5.3/cycles/(2026年10月19日確認)