gpt-oss-20bの必要スペックは?VRAM 16GBで速度226 tok/sと回答品質を実測(RTX 5070 Ti)
gpt-oss-20bの必要スペックを調べると、「VRAM 16GB」という目安がよく出てきます。
ただ、16GBのGPUで実際にどれくらいの速さが出て、答えの正確さはどの程度なのかは、その目安だけでは分かりません。
FRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB)で2026年9月3日に速度を、9月8日に回答品質を実測し、その結果をまとめます。
先に結論を言うと、16GBのGPUを持っているなら、gpt-oss-20bは最初に試す1本として無理のない選択です。
16GBの作業台に百科事典を広げても、まだ空きが残る大きさだからです。
- AI(gpt-oss-20b)=分厚い百科事典を持った物知りの人。20B(中身は21B)は百科事典の分厚さの目安
- GPUのメモリ(VRAM)=手元の作業台。いちばん速く使えるが広さに限りがある(今回は16GB)。はみ出した分は机(メインメモリ)や本棚(SSD)へ取りに行くことになり、遅くなる
- MXFP4(量子化)=百科事典を縮小コピーして薄くした版。薄いほど軽いが、細かい字が少しつぶれることがある
- MoE(専門家混合)=百科事典が分野ごとの専門家の分冊に分かれていて、1トークン書くたびに必要な分冊だけを開く仕組み
- tok/s=1秒に書ける文字のかたまり(トークン)の数。日本語ならおおよそ1かたまりが1〜2文字
- 文脈の長さ=8Kは長いメール数通くらい、32Kは論文1本くらい。読んだ資料はメモ(KVキャッシュ)として作業台に置かれ、長いほど場所を取る
- 書く速さが速い。当サイト実測(RTX 5070 Ti)で生成226 tok/s、論文1本くらいの文脈(32K)を積んでも181 tok/s
- 作業台にゆとりをもって載る。32Kの文脈を積んでもVRAM峰(作業台がいちばん埋まった量)は12.92GBで、16GBの中に約3GBの余白が残る
- 小テストの成績がよい。基本20課題で内容正解17/20・要件達成17/20。ローカル10種の中で最高
- 答える前の下書き(Thinking)は完全にオフにできないが、いちばん短いlow設定なら完了は中央値0.85秒
この記事は、RTX 5070 Ti 16GB搭載機(FRONTIER FRGKB860M/CG3)で、2026年9月3日に測った推論速度と、9月8日に測った回答品質をもとにしています。
速度の比較に使う他モデルの数字は、同じ機材・同じ条件(llama-bench)で測った値です。
回答品質は、LM Studio・context 8192(一度に読ませる資料の長さの上限)・GPUへの自動割当で当サイト自作の課題を解かせた結果で、10種のうちQwen3.5 9B Q8だけはllama.cppで実行した条件差があります。
測っていないこと(Ollamaの速度・32Kでの回答品質・12GB/8GBでの動作・学習)は、測っていないと明記します。
① 結論:16GBのGPUならgpt-oss-20bが最初の1本に向く理由(作業台にゆとりをもって載る)
- 書く速さ・小テストの正答数・作業台(VRAM)の空きの3点で、16GB帯の最有力候補
- 専門家の分冊方式(MoE)で、21B分のうち1トークン書くたびに使うのは3.6B分だけ。規模のわりに軽い
- 縮小コピーの版(量子化)はMXFP4の1種類だけで、選び直す手間がない
16GBのGPUを、広さ16GBの作業台だと考えてみてください。
gpt-oss-20bの百科事典は、その作業台に全部広げ、さらに論文1本くらいの資料メモを置いても、端に約3GBの空きが残ります。
机や本棚へページを取りに行かずに済むので、ローカルAIを初めて試す1本として扱いやすいモデルです。
16GB帯で最初に選ぶ理由は3つあります。
- 速度が10モデル中で最上位
- 基本20課題の正答が10種のローカルモデルで最も多い
- 32Kの長文を積んでもVRAMに約3GBの空きが残る
gpt-oss-20bの百科事典は、分野ごとの専門家の分冊に分かれています(MoE=専門家混合)。
21B分の分冊を持っていても、1トークン書くたびに使うのは約3.6B分だけなので、20Bという規模のわりに軽く動きます。
百科事典を縮小コピーして薄くした版(量子化)は、gpt-oss-20bではMXFP4の1種類だけです。
Qwen3.8-27Bのように、どの薄さの版にするかを選び直す手間もありません。
同じ専門家の分冊方式(MoE)でも、Gemma 4 26B-A4Bは画像を読める代わりに、32Kの資料を積むと作業台を15.50GBまで使い、16GBの余白は小さくなります。
画像も扱いたい場合の選び方はGemma 4 26B-A4Bの記事にまとめています。
② 必要スペック:百科事典の大きさと作業台の空き(本体サイズとVRAMの余白)
- 百科事典そのもの(本体)は11.28GiB。32Kの資料を積んでも、全部を作業台(GPU)に広げて読み込める
- 32Kでも作業台がいちばん埋まった量(VRAM峰)は12.92GBで、16GBの中に約3GBの余白
- 12GB・8GBの作業台は未計測。12GBは読ませる資料を短くする前提の見込みまでで、断定はしない
作業台に百科事典を広げ、読んだ資料のメモも同じ作業台に重ねていく場面を思い浮かべてください。
資料が長くなるほどメモが増え、作業台の空きは少しずつ減っていきます。
gpt-oss-20bは、論文1本くらいの資料(32K)を読ませたあとでも、16GBの作業台に約3GBの空きを残しました。
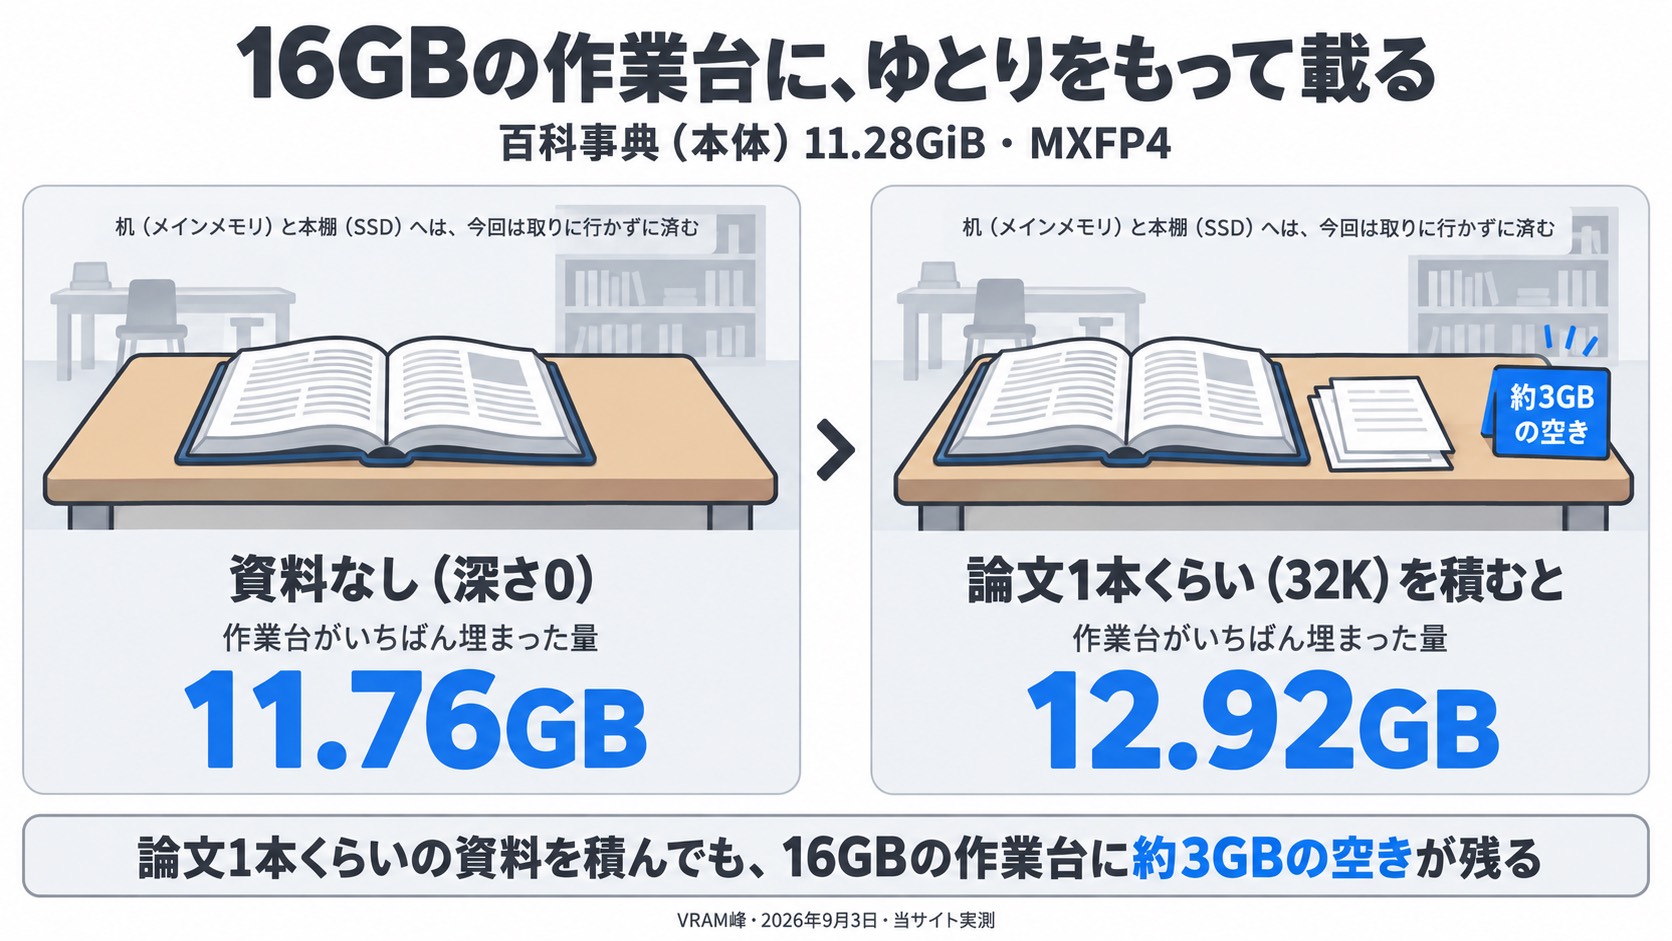
gpt-oss-20bの本体(百科事典そのもの)は11.28GiB(MXFP4)で、全層をGPUに載せる指定(-ngl 99=百科事典を全部作業台に広げる指定)でも読み込みエラーは出ません。
文脈の深さ(先に読ませておく資料の長さ)を0から32,768トークンまで伸ばしても、VRAM峰は11.76GBから12.92GBまでしか増えません。
16GBのGPUなら、32Kの長文脈を積んだ状態でも3GB前後の余白が残る計算です。
作業台の端に、まだ何も置いていないすき間が残っている状態だと考えると分かりやすくなります。
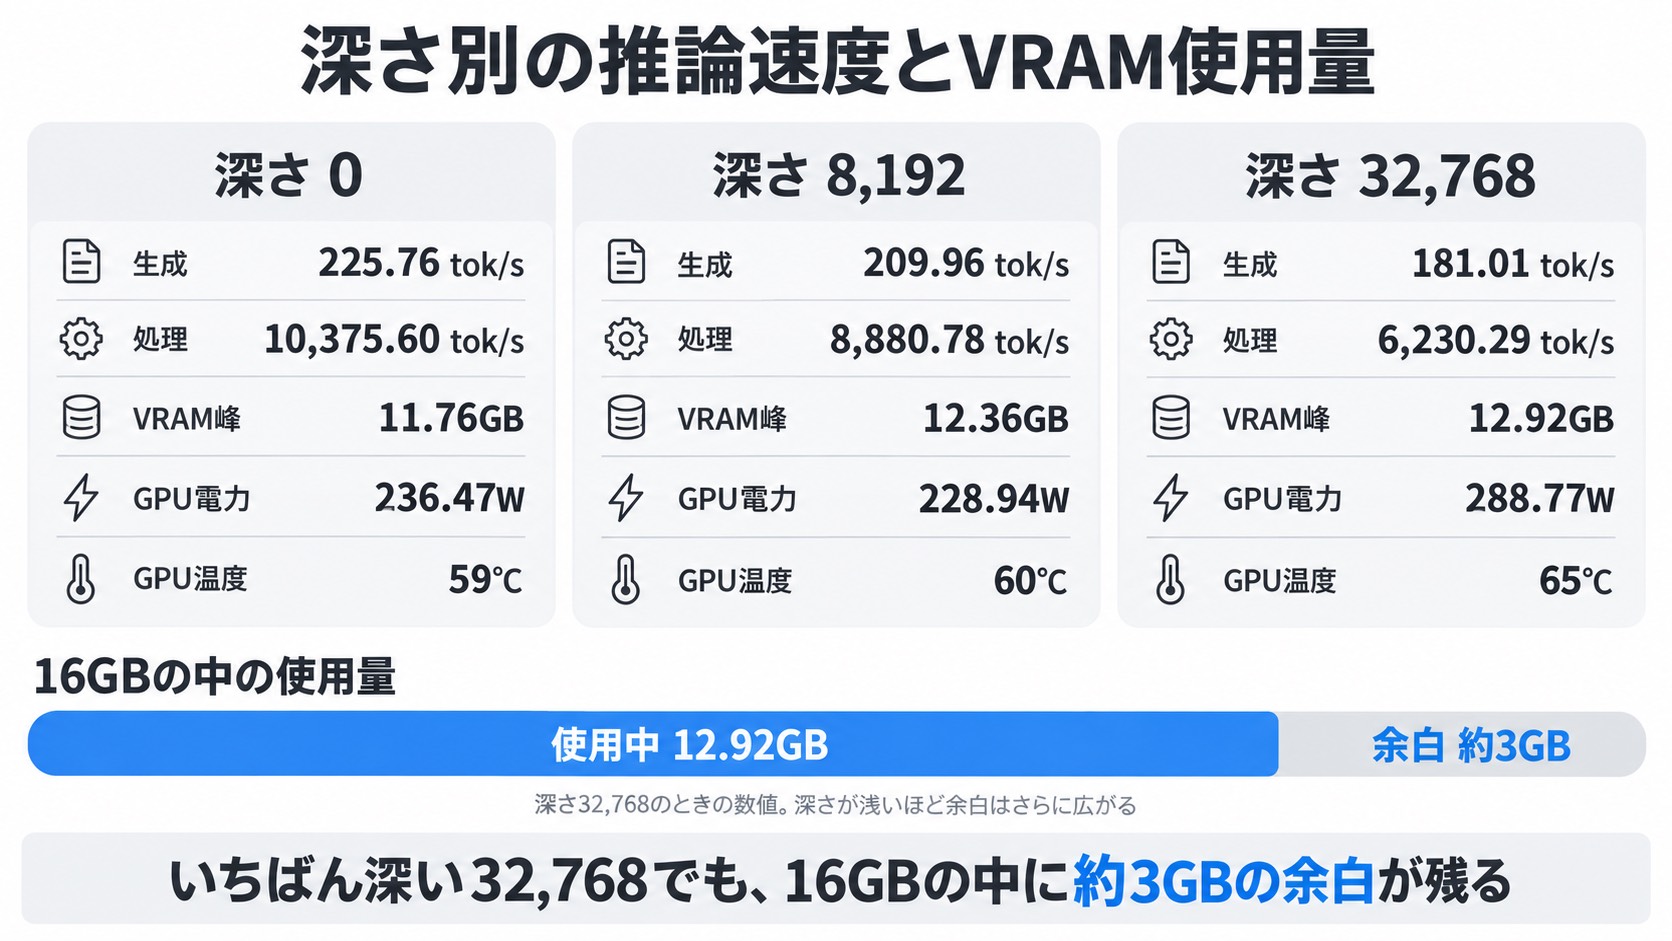
次の表は、左から、先に読ませた資料の長さ(文脈の深さ)、答えを書く速さ(生成 tg128)、資料を読む速さ(処理 pp512)、作業台がいちばん埋まった量(VRAM峰)、GPUの電力と温度の順に並んでいます。
たとえば8,192の行は長いメール数通くらい、32,768の行は論文1本くらいの資料を読ませた状態での値です。
| 文脈の深さ | 生成 tg128 | 処理 pp512 | VRAM峰 | GPU電力 | GPU温度 |
| 0 | 225.76 tok/s | 10,375.60 tok/s | 11.76GB | 236.47W | 59℃ |
| 8,192 | 209.96 tok/s | 8,880.78 tok/s | 12.36GB | 228.94W | 60℃ |
| 32,768 | 181.01 tok/s | 6,230.29 tok/s | 12.92GB | 288.77W | 65℃ |
資料が長くなるほど、書く速さも読む速さも落ちていきます。
32Kまで文脈を伸ばすと、生成速度は225.76から181.01 tok/sへ19.8%落ち、処理速度(pp512)は10,375.60から6,230.29 tok/sへ40.0%落ちます。
速さは落ちても、作業台の使用量(VRAM峰)は12.92GBにとどまり、16GBの容量に余裕を残せます。
同じ実測で比べると、Gemma 4 26B-A4Bは32Kで15.50GBまで使うため、作業台の空きの残り方はgpt-oss-20bのほうが明確に大きいと分かります。
12GBや8GBのGPUで動くかどうかは、当サイトでは測っていません。
本体11.28GiBに32Kの文脈を積んだ状態でVRAM峰が12.92GBになった実測からは、12GBだと文脈を短くしないと厳しい見込みまでしか言えず、動く・動かないを断定できません。
作業台が狭い分、読ませる資料を短くしてメモを減らす工夫が要りそうだ、という見込みです。
8GBについては本体サイズだけで枠を超えるため、実機での動作確認が必要です。
8GBの作業台では、百科事典を広げた時点で一部がはみ出す大きさだということになります。
③ 速度:資料を積んでも書く速さはどれくらいか(深さ別の推論速度と同条件の他モデル比較)
- 21B分の百科事典のうち、1トークン書くたびに使うのは3.6B分だけ。薄い4B級の密モデル並みの速さで書ける
- 同じ条件・資料なし(深さ0)の書く速さで、10モデル中トップ
- 電力1Wあたり約0.95 tok/sは、当サイト実測からの計算値
専門家が大勢いる相談窓口でも、答えをひと言書き進めるたびに呼ばれるのがその場に合った数人だけなら、手間は少なく済みます。
gpt-oss-20bも21B相当の百科事典を持ちますが、1トークン書くたびに使うのは、必要な専門家の分冊を中心にした約3.6B分だけです(MoE=専門家混合)。
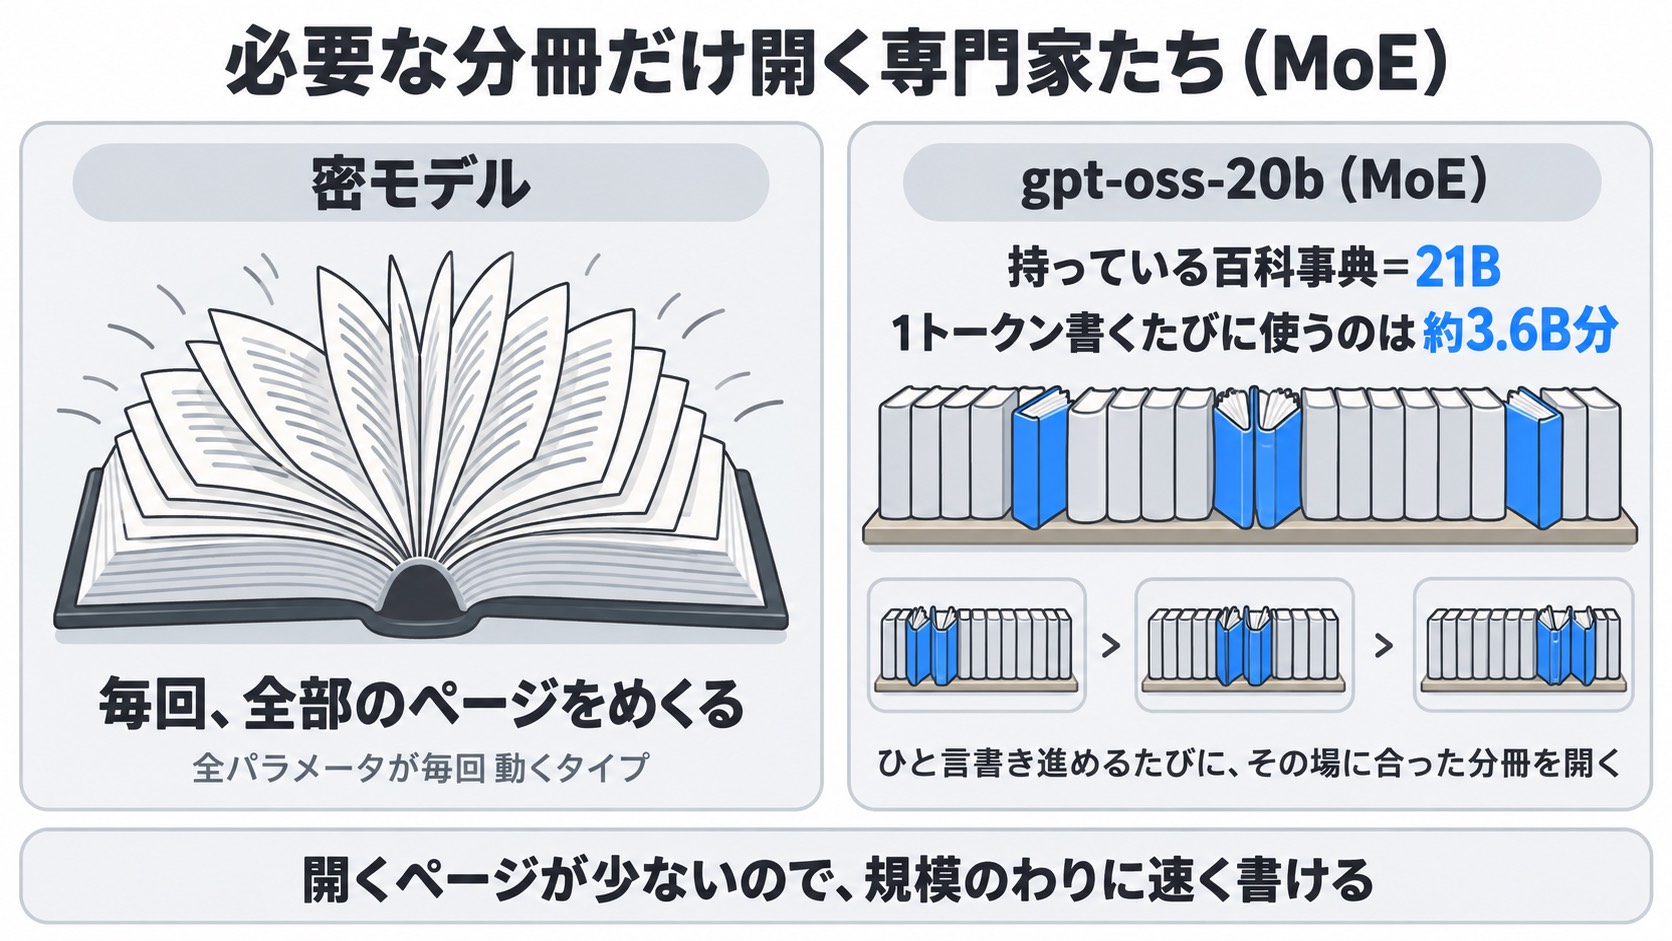
実際に開くページが少ないため、密モデル(全パラメータが毎回動くタイプ)の4B級に近い速さで生成できます。
同じ条件(深さ0)の生成速度を比べると、規模のわりに速く動くことが分かります。
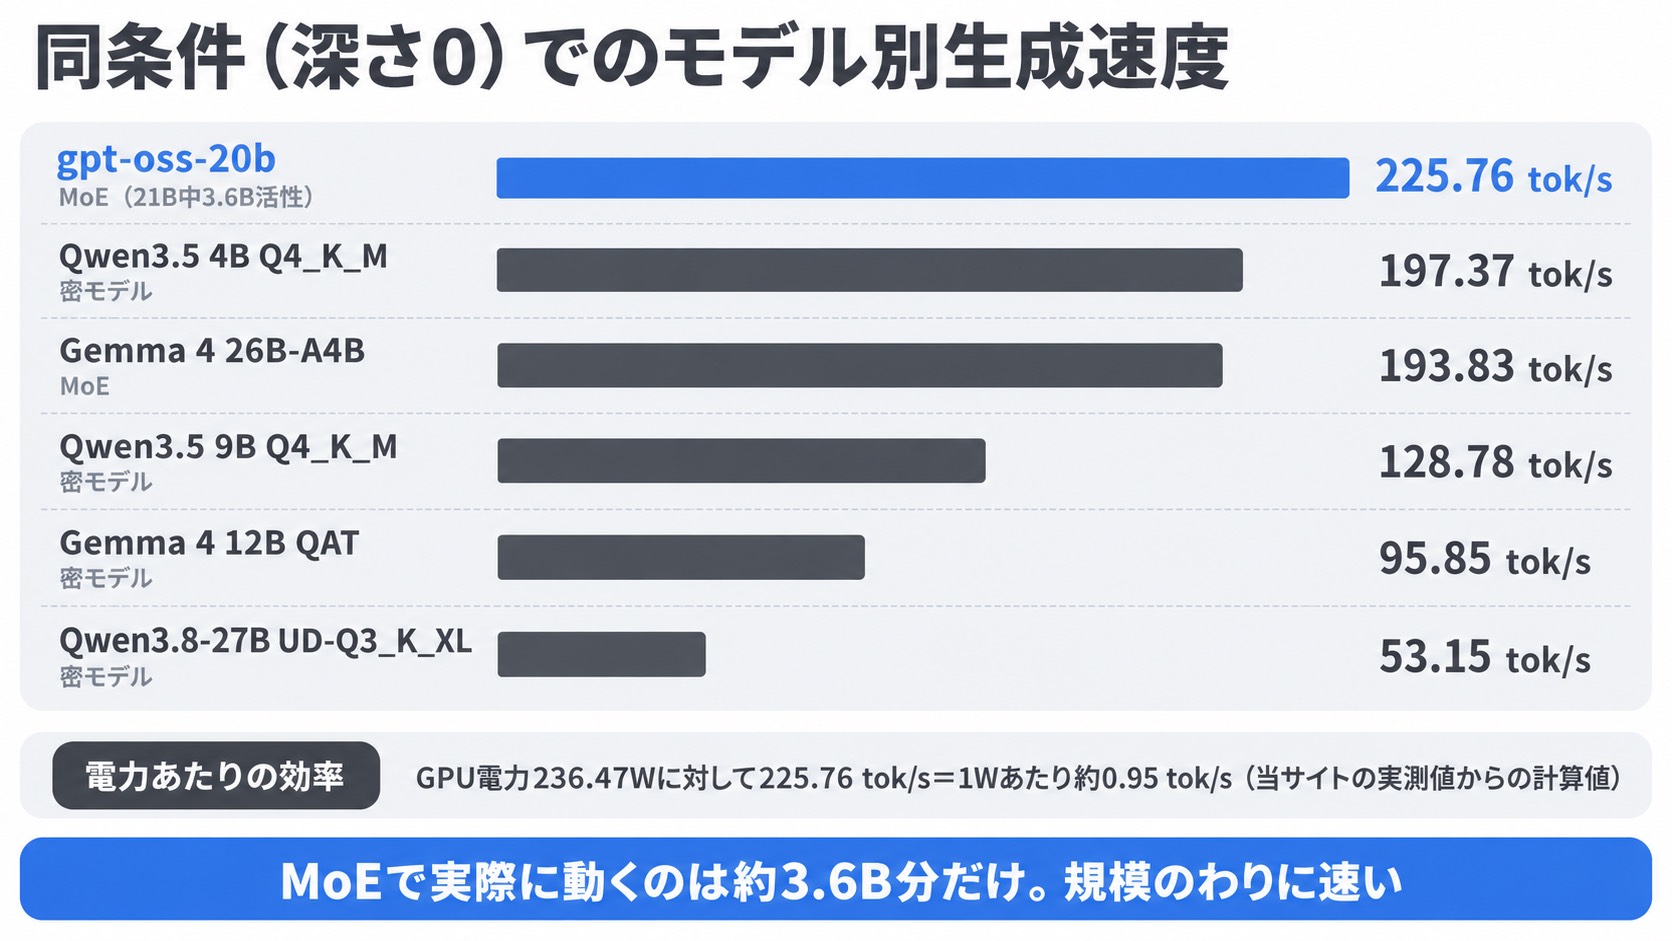
次の表は、同じPC・同じ条件で、資料なし(深さ0)の質問に答えを書く速さを並べたものです。
たとえばQwen3.5 4B Q4_K_Mは百科事典の薄い密モデルですが、21B分を持つgpt-oss-20bのほうが1秒に多く書けています。
| モデル | 方式 | 生成 tok/s(深さ0) |
| gpt-oss-20b | MoE(21B中3.6B活性) | 225.76 |
| Qwen3.5 4B Q4_K_M | 密モデル | 197.37 |
| Gemma 4 26B-A4B | MoE | 193.83 |
| Qwen3.5 9B Q4_K_M | 密モデル | 128.78 |
| Gemma 4 12B QAT | 密モデル | 95.85 |
| Qwen3.8-27B UD-Q3_K_XL | 密モデル | 53.15 |
車の燃費のように、使った電力あたりどれだけ書けたかでも見てみます。
深さ0のGPU電力236.47Wに対して生成225.76 tok/sなので、1Wあたり約0.95 tok/sという計算になります(当サイトの実測値からの計算値)。
速度の比較結果は、今回の機材・ベンチマーク条件でのモデル間の差を示しています。
コーディングの実力や日本語の自然さは速度の数字から判断できず、当サイトでは別に計測していません。
この深さ0のベンチマークは、1回あたり約12秒で終わっています。
1秒ごとに記録したGPU使用率を見ると、待機中の0%台から生成の開始と同時に92〜94%まで跳ね上がり、生成が終わると1秒足らずで0%に戻っていました。
21B中3.6Bだけが動くという軽さは、tok/sの数字だけでなく、GPUが全力で動く時間の短さにも表れています。
④ ふだんのチャット画面ではどうか:LM Studioの体感とllama-benchの違い
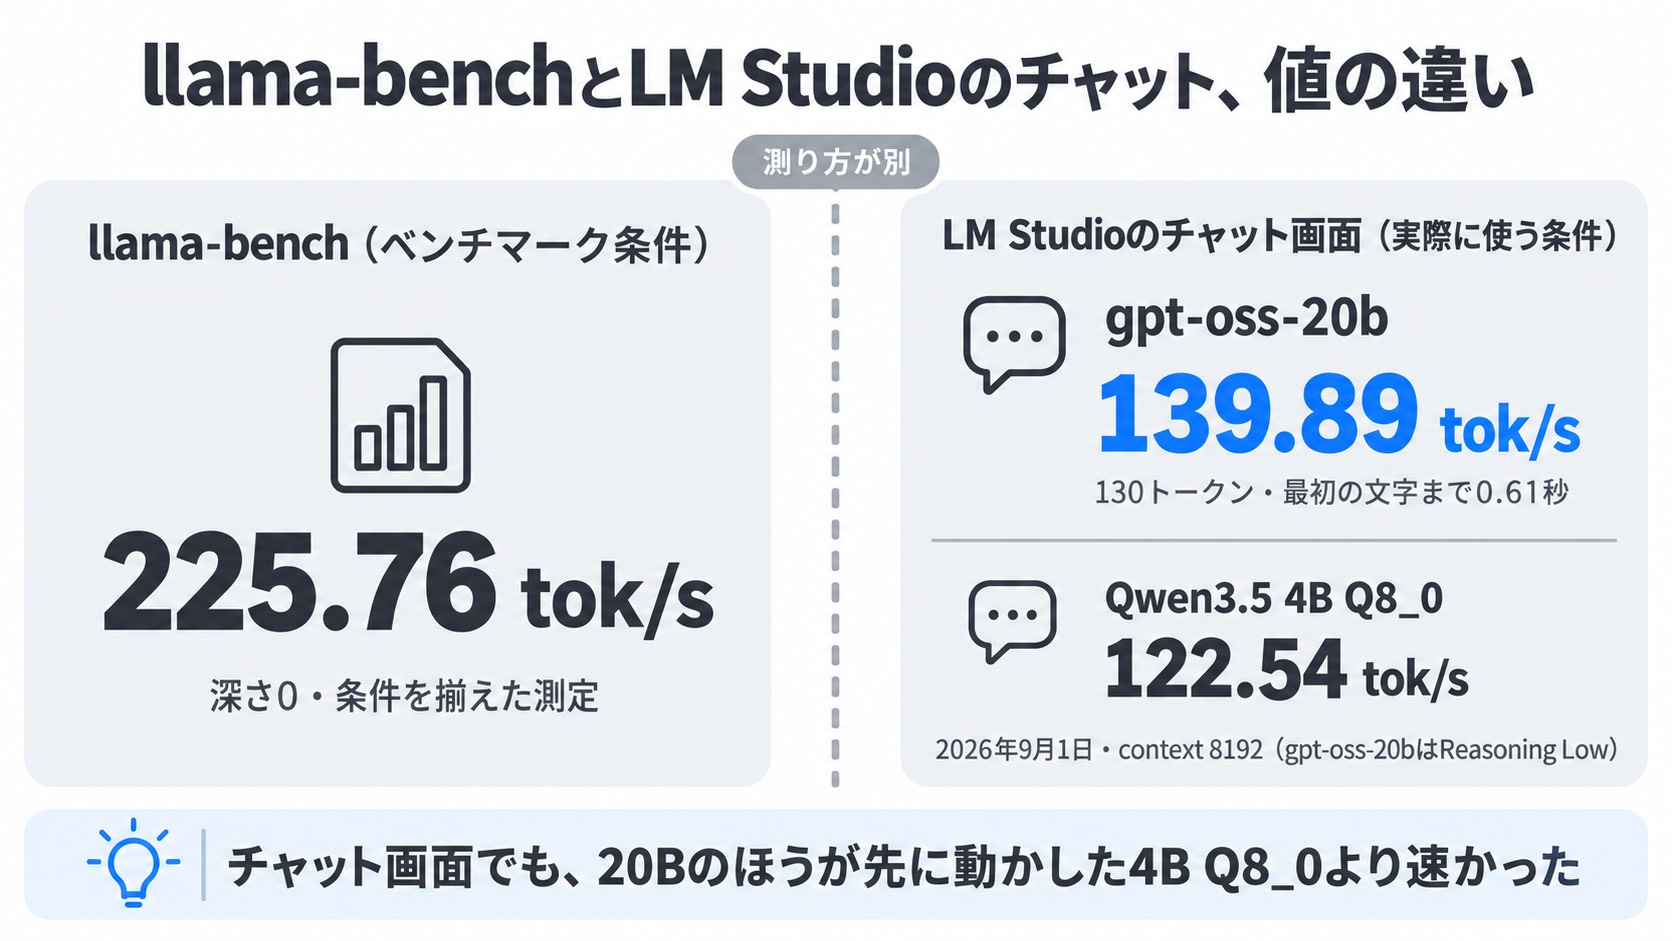
- LM Studioのチャット画面での実測は139.89 tok/s。計測用のllama-bench(225.76)とは測り方が別なので並べない
- Qwen3.5 4B Q8_0(122.54 tok/s)より20Bのほうが速く、分冊方式(MoE)の軽さをチャット画面でも確かめられる
- 内部部品harmonyの更新エラー(EPERM)は、LM Studioの再起動+再試行ボタンで解決
同じ選手の100m走でも、競技場でスパイクを履いて測ったタイムと、ふだんの靴で道を走ったタイムは並べて比べません。
llama-benchは条件をそろえた計測用の道具、LM Studioはふだん使うチャット画面で、同じgpt-oss-20bでもコースと靴が違う測り方になります。
LM Studio 0.4.23のチャット画面で、context 8192・Reasoning Lowの設定のまま1回だけ動かすと、139.89 tok/s・130トークン・最初の文字まで0.61秒という値が出ました(2026年9月1日計測)。
llama-benchの225.76 tok/sとは別物で、チャット画面の1回はテンプレートの処理(質問を決まった書式に整える下準備)や思考の分を含むため、そのまま並べて比較できる数字ではありません。
実際に使う場面の体感としては、チャット画面の139.89 tok/sのほうが近い値になります。
初めてgpt-oss-20bのチャットを動かしたときは、先に動かしていたQwen3.5 4B Q8_0(122.54 tok/s)より、20Bのほうが速い値が出ました。
21Bのうち動くのは約3.6Bというカタログ値を、数字で実感した瞬間です。
同じモデルでも、チャット画面の値とベンチマークの値は別物として見る必要があると、あらためて気づかされます。
gpt-oss-20bを動かす前には、ひとつつまずきがありました。
LM Studioの内部部品「harmony」(0.3.6)の更新がEPERMエラーで失敗し、そのままでは実行できない状態だったのです。
LM Studioを完全に再起動し、ダウンロード画面のエラー表示の横にある再試行ボタンを押すと、更新は通りました。
gpt-oss-20bを動かすにはharmonyが必要です。
スマートフォンのアプリ更新が途中で止まったときと同じく、まずは再起動から試します。
このエラーに当たったら、LM Studioを完全に再起動してから再試行してください。
⑤ 答えの正しさ:基本20課題の内訳と回答例
- 20問の小テスト(基本20課題)で内容正解17/20・要件達成17/20、ローカル10種で最高
- 計算・資料からの抜き出し・同じ問題を繰り返したときの安定性が強み。不明・矛盾の見分けは1/2
- U1(1問)は実行エラーで採点できず。誤答と同じ扱いにはしていない
物知りの人に、計算・資料の読み取り・ひっかけを混ぜた20問の小テストを受けてもらったイメージです。
2026年9月8日、LM Studio 0.4.23・context 8192・temperature 0(毎回同じ答えになりやすい設定)・最大出力2048(答えの長さの上限)の条件で、計算・条件判断・情報抽出など10分野20課題に各1回答えさせました。
内容正解17/20、要件達成17/20で、当サイトが同じ課題を出したローカル10種の中では最も高い結果です。
分野ごとに見ると、得意・不得意がはっきり分かれます。
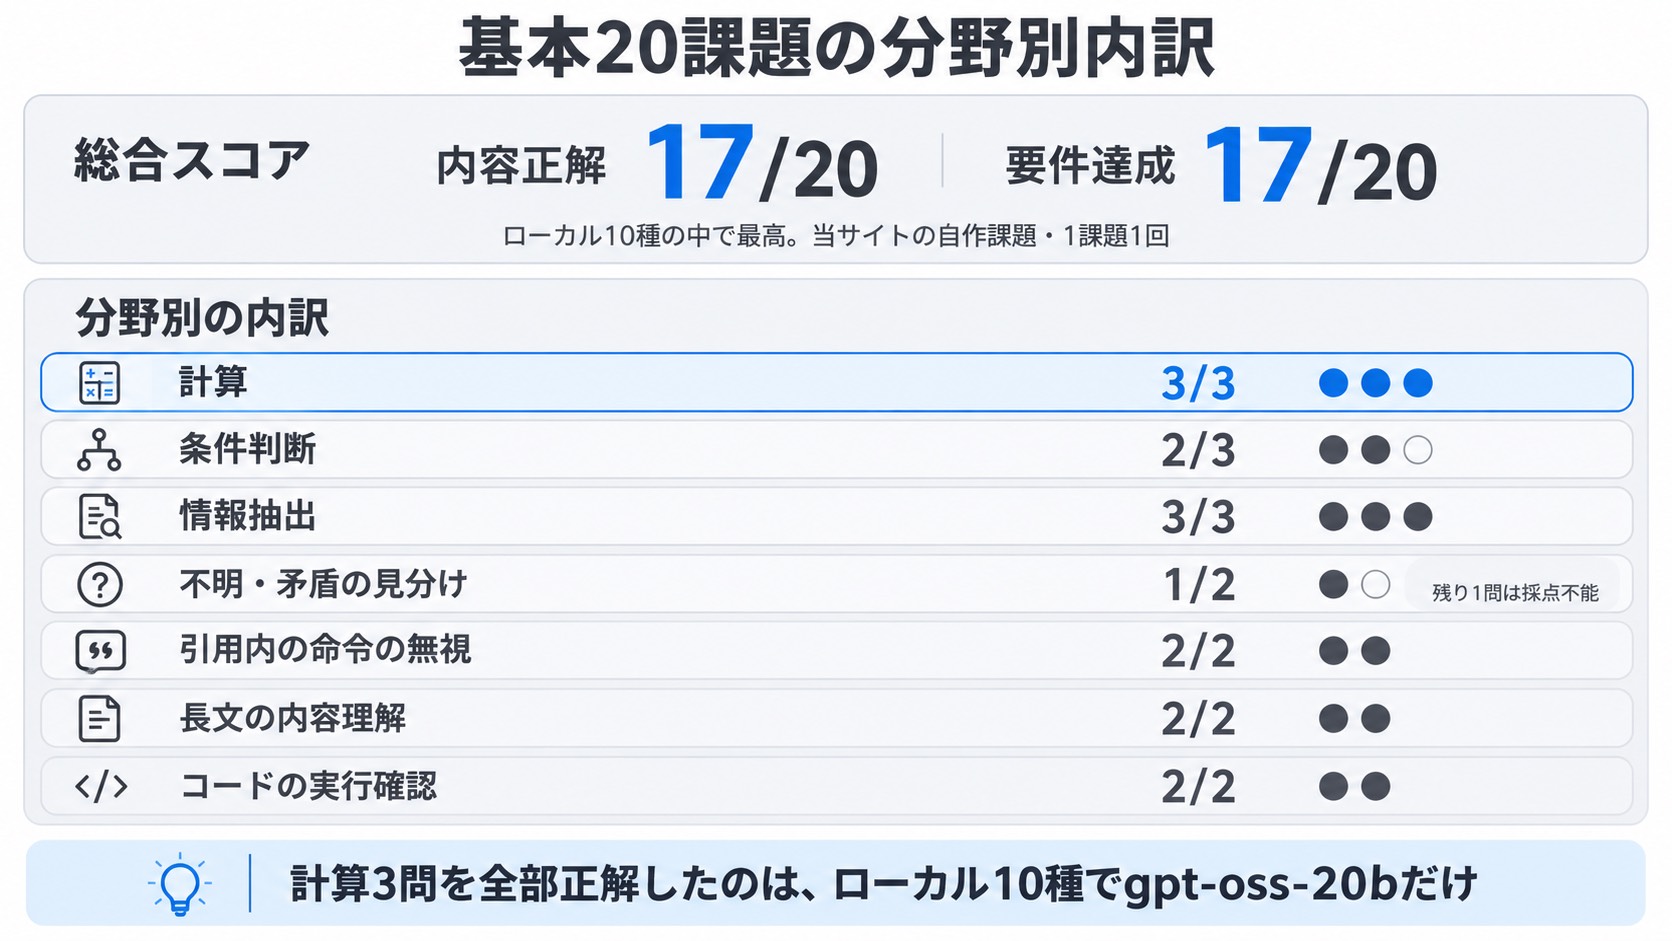
次の表は、小テストの分野ごとの正答数です。
たとえば「計算」の3/3は3問すべてに正解した、「不明・矛盾の見分け」の1/2は2問のうち1問に正解したという意味です。
| 分野 | 正答数 | 備考 |
| 計算 | 3/3 | ローカル10種で唯一の満点 |
| 条件判断 | 2/3 | |
| 情報抽出 | 3/3 | |
| 不明・矛盾の見分け | 1/2 | 残り1問は採点不能(後述) |
| 引用内の命令の無視 | 2/2 | |
| 長文の内容理解 | 2/2 | |
| コードの実行確認 | 2/2 |
計算3問を全部正解したのは、ローカル10種の中でgpt-oss-20bだけでした。
実際の回答例を見ると、傾向がつかみやすくなります。
「定価12,800円を15%引きにし、値引き後の金額に10%の税を加え、送料550円を足す」という計算課題では、JSON(プログラムで読み取りやすい決まった書式)だけで{“total”:12518}と正しい値を返しています。
別の計算課題「5台を各1200円、3台を各1800円で買った。全8台の平均単価はいくらか」でも、{“average”:1425}とJSONのみで正しく答えています。
単価が異なる2種類の商品をまとめて平均する条件でも、形式を崩さず数値だけを返せています。
一方、「不明・矛盾の見分け」の分野は1/2にとどまりました。
この2問のうち1問(架空の製品資料から重量・バッテリー時間・価格を抜き出す課題)は、実行系の出力解析エラーで最終回答が得られず、内容の正誤を採点できていません。
答案用紙が読み取れる形で戻ってこず、正しいか間違いかを確かめられなかった状態です。
別の呼び出し方(OpenAI互換API)でも同じ生成失敗が再現し、20問中のこの1問は未達成分に含めていますが、誤答と同じ扱いにはしていません。
もう1問(開始時刻が資料によって食い違うケース)には「矛盾」「時刻は確定できずnull」と正しく答えており、不明・矛盾の判断そのものができないわけではありません。
同じ問題を何度出しても同じように正解できるかを見る、繰り返しの安定性のテスト(3課題×3回)でも、内容9/9・要件9/9でローカル10種の中で唯一の満点でした。
画像を入力して表やグラフを読み取らせる課題には対応していません。
資料から数字を読み取る用途は強い一方、写真や図を見せて読ませる使い方は最初から選択肢に入らない点は押さえておきます。
⑥ 答える前の下書き(Thinking):lowとhighで正答数と待ち時間はどう変わるか
- 答える前の下書き(Thinking)は完全にオフにできない。いちばん短い設定はlow
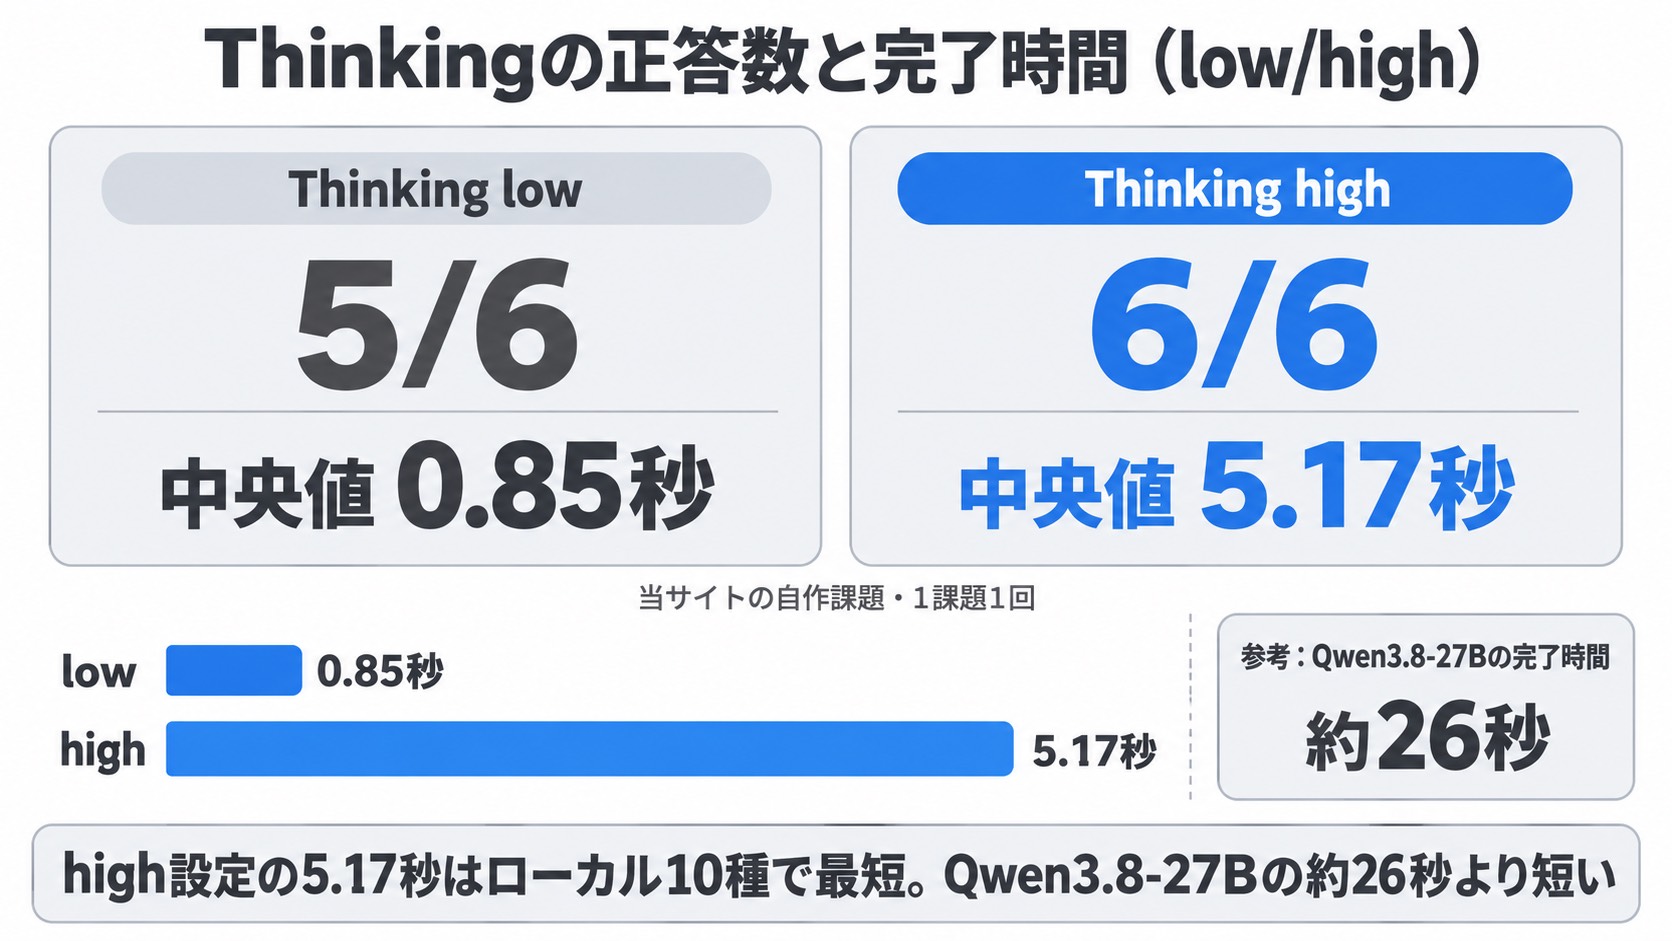
- low 5/6→high 6/6、完了時間は中央値0.85秒→5.17秒
- じっくり下書きしても5.17秒で、ローカル10種で最短。Qwen3.8-27Bの約26秒より大幅に短い
答える前に、メモ用紙で下書きしてから話し始める人を思い浮かべてください。
下書きを短く済ませればすぐ答えられ、じっくり書けば時間はかかります。
gpt-oss-20bにはこの下書き(Thinking)の長さを選ぶつまみがあり、今回の6課題では、じっくり下書きした設定のほうが正答が1つ増えました。
gpt-oss-20bはThinking(考える処理)を完全にオフにできない設計で、最小のlow設定までしか下げられません。
基本のlow設定で同じ6課題を解かせると5/6、Thinkingを最大のhigh設定に切り替えると6/6まで伸びました。
完了までの時間は基本設定の中央値0.85秒に対し、high設定では5.17秒。
high設定の5.17秒はローカル10種の中で最短で、Qwen3.8-27Bの約26秒より短い待ち時間です。
計算問題の表現を明確にした追試(小数第3位を四捨五入して小数点以下2桁までと明示した課題)でも、基本設定・Thinkingの両方で正答しています。
短い事務処理には基本のlow設定、計算や条件判断が絡む場面にはhigh設定という使い分けが現実的です。
メールの宛名チェックなら短いメモで即答、見積もりの計算なら下書きしてから答える、という感覚に近い使い分けです。
⑦ 向く使い方・向かない使い方
- 向く:短い事務作業・計算・資料からの抜き出し・長文の要約
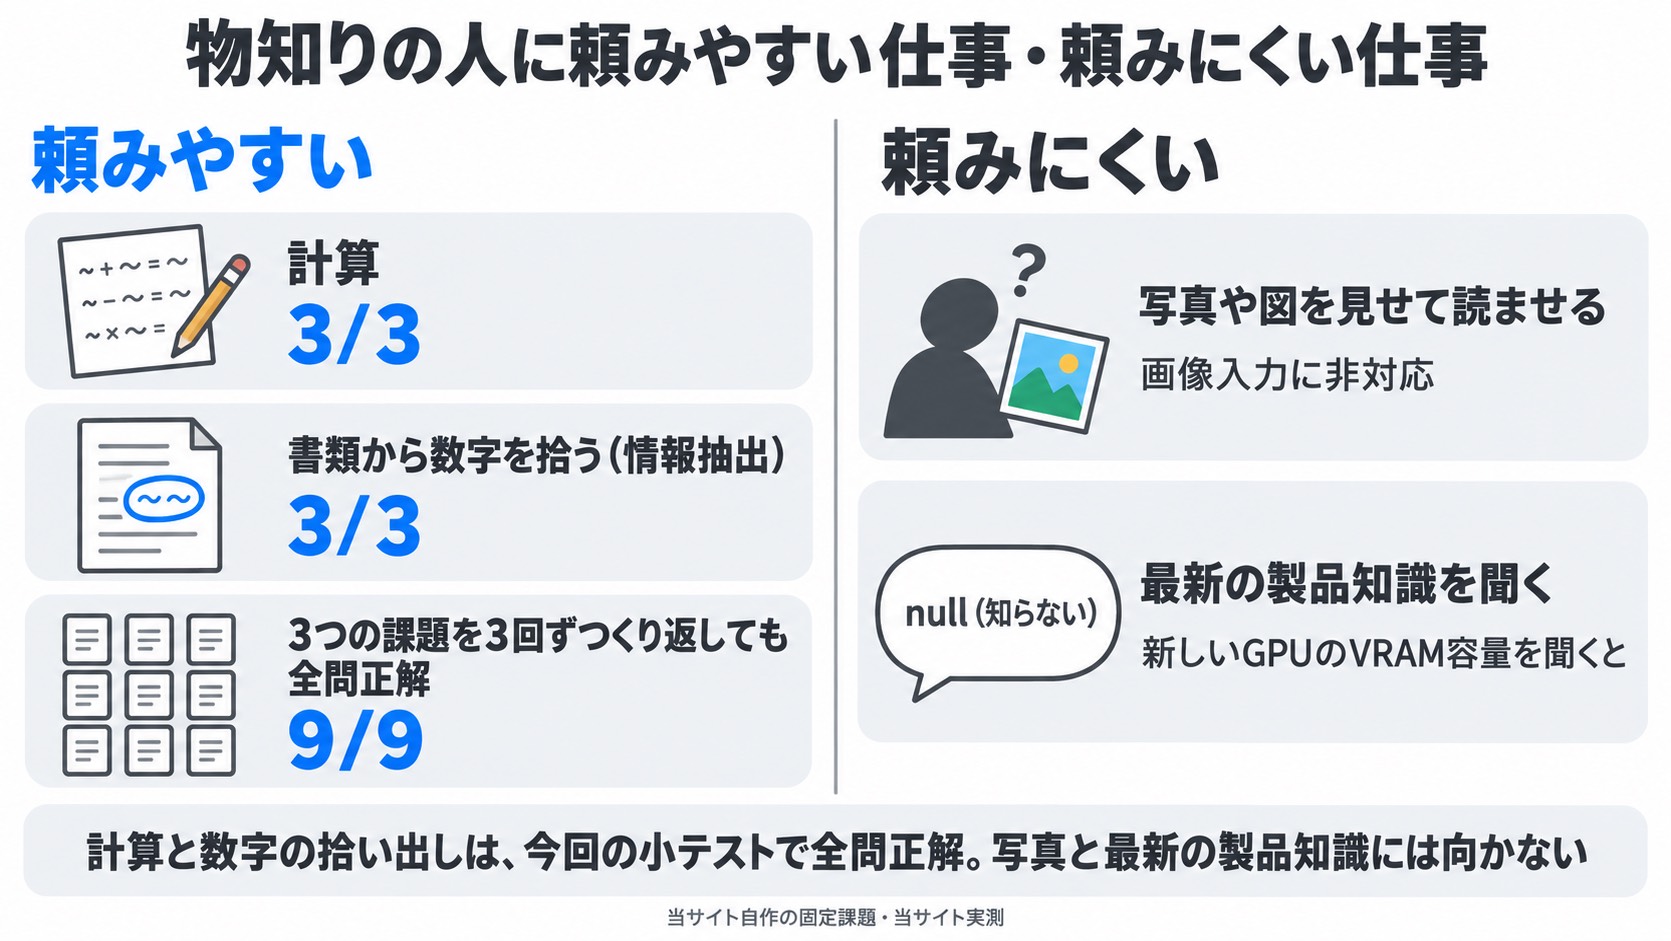
- 向かない:写真や図を見せて読ませる用途(画像入力に非対応)
- 向かない:最新の製品知識を聞く用途(RTX 5070 TiのVRAMもnull=知らないと回答)
物知りの人にも、頼みやすい仕事と頼みにくい仕事があります。
計算や、書類から数字を拾い出す仕事は、今回の小テストでは手早く正確にこなしました。
一方で、写真を見せても読めず、百科事典に載っていない新しい製品のことは答えられないことがあります。
実測結果から、次の用途に向いています。
- 短い事務作業
- 計算
- 資料からの数値の抜き出し
- 長文の要約
計算3問の満点や抽出3問の満点、繰り返し9回の満点という結果が、実務の入口として使える根拠です。
速度も10モデル中トップで、短いやり取りを何度も繰り返す用途に向いています。
たとえば、見積書の合計を確かめる、議事録から日付と金額だけ抜き出す、といった細かな頼みごとを続けて投げる使い方です。
画像を読ませる使い方や、最新の製品知識を聞く使い方には向きません。
画像入力には対応しておらず、表やグラフを読み取らせる課題は最初から選択肢にありません。
RTX 5070 TiのVRAM容量を尋ねると、gpt-oss-20bはnull(知らない)と正直に答えました。
GPU上で動くことと、そのGPUの仕様を知っていることは別で、最新情報が必要な質問には検索や資料を別に用意する前提で使います。
手元の百科事典に載っていない話題は、新聞の切り抜きを渡してから聞くイメージです。
27B級のモデルを16GBに入れたい場合は量子化の選び方が焦点になり、gpt-oss-20bとは別の判断基準が必要です。
27Bのより分厚い百科事典を、どこまで薄く縮小コピーして16GBの作業台に収めるかという考え方はQwen3.8-27Bの記事で扱っています。
⑧ このモデルを快適に動かすPC
- 計測機はFRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB・Core Ultra 7 265F・32GB・1TB・850W)
- 価格450,800円(2026年9月28日時点)
- PC選びの基準はローカルLLM用デスクトップPCの選び方(P0)にまとめている
作業台・机・本棚のたとえで言うと、今回のPCは作業台(VRAM)16GB、机(メモリ)32GB、本棚(ストレージ)1TBの組み合わせです。
gpt-oss-20bは作業台の中に全部広げられる大きさなので、答えを書く途中で机や本棚へ取りに行かずに済みます。
今回の実測に使ったFRONTIER FRGKB860M/CG3は、RTX 5070 Ti(16GB)にCore Ultra 7 265F、32GBメモリ、1TBストレージ、850W電源を組み合わせた構成です。
gpt-oss-20bを全層GPUで動かしたうえで、32Kの長文脈を積んでもVRAMに約3GBの余白が残るため、ほかのアプリやブラウザを同時に開いたままでも使える余裕があると見込んでいます(同時に使った状態は測っていません)。
価格は2026年9月28日時点で450,800円です。
16GBのPC選びの基準そのものは、ローカルLLM用デスクトップPCの選び方にまとめています。
推論・学習それぞれのVRAMの目安や、gpt-oss-20b以外の構成も親記事で確認できます。
ローカルLLMでそもそも何ができるか・できないか、LM Studio・Ollamaでの始め方はローカルLLMとは?できることと始め方にまとめています。
32GBのRTX 5090や128GBの統合メモリ機まで候補に入れるなら、RTX Spark・Mac M5 Max・RTX 5090の比較記事で、gpt-oss 20Bの第三者計測(RTX 5090で約325 tok/s)も含めて比べています。
作業台そのものがもっと広いPCや、作業台と机がひとつの大きな台になったPCを比べる記事です。
16GBのGPUのまま、もっと大きな125Bのモデルをメモリ32GBとSSDに分けて動かす方法もあります。
作業台に載りきらない分厚い百科事典を、机と本棚に分けて置くやり方です。
短い質問なら2回目から約70 tok/sで返る一方、本1冊分くらいの資料では返事まで約4分待った記録を、Qwen3.8-Flash-Nextの32GB実測に載せています。
⑨ まとめ
16GBのGPUなら、gpt-oss-20bは作業台にゆとりをもって載り、速く書けて、小テストの成績もよいモデルでした。
生成225.76 tok/s、32Kでも181.01 tok/sという速度が出て、VRAM峰は32Kでも12.92GBにとどまります。
基本20課題では内容正解17/20・要件達成17/20で、当サイトが測ったローカル10種の中で最も高い結果でした。
画像を読ませる用途と最新の製品知識を聞く用途を除けば、短い事務作業・計算・資料からの抜き出し・長文の要約を試す出発点にできるモデルです。
⑩ よくある質問
gpt-oss-20bに必要なVRAMはどれくらい?
16GBのVRAM(作業台)に、ゆとりをもって載る大きさです。
本体は11.28GiB(MXFP4)で、当サイトのRTX 5070 Ti(16GB)実測では、論文1本くらいの長文脈(32K)まで積んでもVRAM峰は12.92GBで、16GBの中に約3GBの余白が残りました。
16GBのGPUであれば、全部をGPUに載せて(全層GPU)無理なく動かせます。
VRAM 12GBでも動く?
12GB・8GBでの動作は当サイトでは測っていません。
本体11.28GiBに32Kの文脈を積んだ状態でVRAM峰が12.92GBになった実測からは、12GBだと読ませる資料(文脈)を短くしないと厳しい見込みまでしか言えず、動く・動かないの断定はできません。
日本語で使える?
日本語の自然さそのものは当サイトでは計測していません。
ただし、日本語で出した20問の小テスト(基本20課題)では内容正解17/20・要件達成17/20で、ローカル10種の中で最も高い結果でした。
計算・資料からの抜き出し・長文読解の範囲では、日本語の指示に沿って答えられています。
Thinkingをオフにできる?
答える前の下書き(Thinking)は、完全にはオフにできません。
いちばん短い設定はlowで、この状態でも同じ6課題のうち5/6に正答し、完了時間の中央値は0.85秒でした。
正答率を優先するならThinkingをhighに切り替え、完了時間は中央値5.17秒に伸びます。
画像を読める?
読めません。
gpt-oss-20bは写真や図を受け取る画像入力に対応しておらず、表やグラフを読み取らせる課題は当サイトの計測でも実施できませんでした。
画像を扱いたい場合は、画像対応の別モデルを選ぶ必要があります。
計測条件
- 速度:2026年9月3日、llama.cpp b10752、llama-bench -ngl 99 -fa on -p 512 -n 128 -r 3、3回の中央値。RTX 5070 Ti 16GB、ドライバ616.56
- 回答品質:2026年9月8日、LM Studio 0.4.23、context 8192、temperature 0、最大出力2048、System Prompt指定なし、各課題1回、GPUへの割当はモデルごとの自動設定。Thinkingはlow(比較のThinkingはhigh)。繰り返しのテストだけtemperature 0.7。比較したローカル10種のうちQwen3.5 9B Q8だけはllama.cpp b10752で実行
- LM Studioのチャット参考値:2026年9月1日、context 8192、Reasoning Low、1回