ローカルLLM用のGPU・PCの選び方 2026|VRAM 16GB・24GB・32GB・統合メモリ128GBで何ができるか
Qwen3.8-27Bを自分のPCで動かし、仕事に合う話し方まで覚えさせたい。
そんな計画を立てても、2026年8月にはRTX 5090が90万〜100万円を超えたという観測があり、購入画面の前で手が止まります。
同じ価格を見て、最初から32GBを選ぶより、16GBでできることを確かめるほうが現実的だと考えました。
ローカルLLM(自分のPCの中で動かすAI)用のPCは、AIに答えてもらう推論でも、AIに練習させる学習でも、まずVRAMの容量からスペックが決まります。
VRAMはGPU専用のメモリで、この記事では手元の作業台にたとえて説明します。
そもそもローカルLLMで何ができて何ができないか、LM Studio・Ollamaでの始め方から知りたい場合はローカルLLMとは?できることと始め方にまとめています。
- AI(LLM)=分厚い百科事典を持った物知りの人。27B・70Bなどの数字は百科事典の分厚さの目安。学習(LoRA・QLoRA)=その人に自分の文体や答え方を練習してもらうこと
- GPUのメモリ(VRAM)=手元の作業台。いちばん速いが小さい。メインメモリ(RAM)=机。SSD=本棚
- VRAMに全載せ=百科事典を全部作業台に広げられる状態。はみ出す=一部を机に置き、そのたびに取りに行くので遅くなる
- 量子化(Q3・Q4_K_Mなど)=百科事典を縮小コピーして薄くした版。薄いほど軽いが、細かい字が少しつぶれることがある
- tok/s=1秒に書ける文字のかたまり(トークン)の数。日本語ならおおよそ1かたまりが1〜2文字
- メモリ帯域=作業台へ本を運ぶ通路の幅。統合メモリ(Mac・DGX Sparkなど)=作業台と机が1つの大きな台になったつくり
- AIの返事の速さを分けるのは、縮小コピーした百科事典(量子化したモデル)を作業台(VRAM)に全部広げられるかどうか
- AIに練習させるQLoRA学習で要る作業台の広さは、約0.7〜1GB×パラメータ数(B)が概算
- 16GBの作業台なら、27BをQ3に縮小して答えてもらうことと、9B以下のLoRA・12〜14BのQLoRAの練習まで。27BのQLoRA学習は24GB以上
- 広い作業台を持つ大容量GPUが値上がりしている今は、16GBカードと、使った時間だけ料金を払うクラウドGPUを使い分けると初期費用を抑えやすい
- 当サイト実測(RTX 5070 Ti):Qwen3.8-27Bは作業台に収まるUD-Q3_K_XLなら53.15 tok/s。はみ出すQ4_K_Mは全層GPU指定だと7.09 tok/s、GPUに置く層数を62〜64に指定すると26.6〜33.0 tok/s
この記事は、Unsloth公式ドキュメント、OpenAI、NVIDIA、Spheron、国内実売レポートなど、2026年8月23日時点の公開資料をベースにしています。
当サイトはRTX 5070 Ti 16GB搭載のFRONTIER FRGKB860M/CG3で計測しています。
9月3日の推論速度、9月8日の回答品質、9月29日〜10月1日の追加計測(量子化・長い文脈・GPUに置く層数・アプリの違い)は、当サイトの実測として第⑧節にまとめました。
学習(QLoRA)は10月13日に試運転し、結果が出たらこの記事へ足します。
第⑧節の速度と点数をほかの節やFAQで引く箇所には「当サイト」と添えています。
残りの数値は公開資料の値です。
- ① 結論:PC選びは作業台の広さ(VRAM容量)でほぼ決まる
- ② 答えてもらうか練習させるかで、要る作業台の広さが変わる(推論と学習のVRAM)
- ③ 作業台の広さ別にできること(VRAM 8GB〜128GB)
- ④ どの百科事典を選ぶか(選ぶ価値があるオープンウェイトモデル)
- ⑤ 練習で変わるのは、知識より話し方や答え方(学習で変えられること)
- ⑥ 机・本棚・電源の基準(メモリ32GB・NVMe 1TB・電源750W)
- ⑦ 何をしたいかで選ぶ3つのPC構成(目的別)
- ⑧ 16GBの作業台で実際に測った結果(RTX 5070 Ti:推論速度・回答品質・追加計測)
- ⑨ 買う前に借りて試すと、自分に要る作業台の広さが見える
- ⑩ 2026年10月は、作業台の広さを決めてから買い時を考える
- ⑪ まとめ
- ⑫ よくある質問
① 結論:PC選びは作業台の広さ(VRAM容量)でほぼ決まる
物知りの人に百科事典を読んで答えてもらうだけなら、本を広げられる作業台があれば足ります。
同じ人に自分の文体まで練習させるとなると、練習ノートや下書きも並べるので、同じ本でもずっと広い台が要ります。
最初に決めるのはGPUの型番ではなく、動かしたいモデルと、答えてもらうだけか練習までさせるか(学習方式)です。
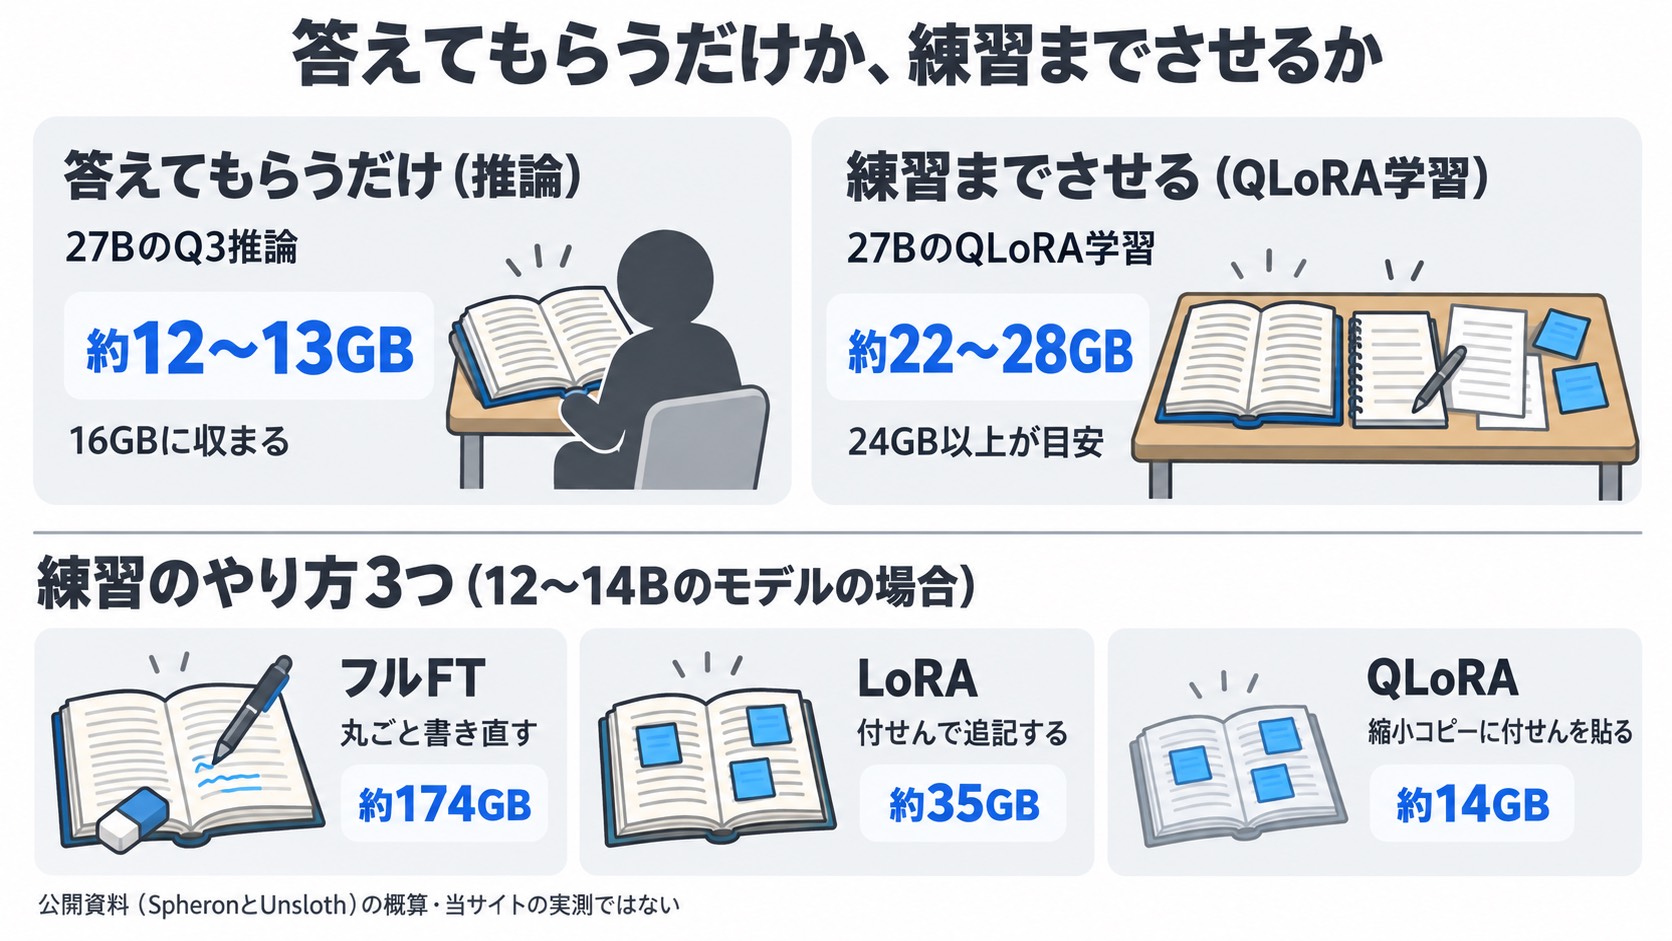
数字で見ると、同じ27Bでも、Q3推論は約12〜13GB、QLoRA学習は約22〜28GBが目安です。
Qwen3.8-27BのQ3(UD)推論は16GBカードに載りますが、QLoRA学習の入口は24GB以上です。
予算を組むなら、毎日使うモデルが収まる広さの作業台(VRAM帯)を手元に置き、月に数回しか使わない大きな学習だけをクラウドへ送ります。
小さな推論のために128GB機を買う必要はなく、70B学習を16GBへ押し込む必要もありません。
用途を分けるほど、GPU代と待ち時間の両方を見通しやすくなります。
以前、メモリ16GBのMacで音声合成用の声モデルを学習したときは、1回の学習に約12〜17時間かかりました。
学習中はメモリも処理能力も目いっぱいで、32GBあればどれほど速かったかと今も思います。
今回テストしたRTX 5070 Tiの処理能力は、そのMacよりずっと上です。
音声や画像の学習まで視野に入れるなら、メモリとGPUに予算を割く価値があると感じています。
第⑧節で試した10本のうちどれを常用するかはまだ決めておらず、回答品質で上位だったモデルを追加学習でどこまで使いやすくできるかを、次の計測で確かめます。
この表の見方:左の列が作業台の広さ(VRAM帯)で、右へ読むと、答えてもらえる百科事典の大きさ、練習させられる大きさ、値段の順に並びます。
たとえば16GBの行なら、27BをQ3に縮小コピーした版(約12〜13GB)で答えてもらえ、練習は12〜14BのQLoRA(約14GB)までと読みます。
| VRAM帯 | 推論できる最大クラスの目安 | 学習できる最大クラスの目安 | 価格目安 |
| 8GB | Qwen3.5 9B以下、Gemma 4 12B Q4は短文脈 | 7〜9B QLoRA 約8GB | RTX 5060 約6.8万円から(2026年9月時点) |
| 12GB | Qwen3.5 9B、Gemma 4 12B | 7〜9B QLoRA、4B級LoRA | RTX 5070 約14.6万円から(2026年9月時点) |
| 16GB | gpt-oss-20b、Qwen3.8-27B Q3 約12〜13GB | 9B以下LoRA、12〜14B QLoRA 約14GB | GPU単体 約12万〜35万円(RTX 5060 Ti 16GB〜RTX 5080) |
| 24GB | 27〜32B Q4を全載せしやすい | 27〜32B QLoRA 約22〜28GBの入口 | 中古RTX 3090 約18万〜24万円/RTX PRO 4000 Blackwell 約40万〜47万円 |
| 32GB | 27〜32BのQ5/Q6を扱いやすい | 27〜32B QLoRA。70B QLoRA 約52GBには不足 | RTX 5090 約100万〜145万円(7月は約70万円) |
| 48GB以上(GPU/統合) | ELYZA-JP-70B Q4 約40〜43GBなど | 27B QLoRAは余裕。70B QLoRAは約52GB以上 | Mac mini M5 Pro 48GB 約41万円から |
| 128GB統合 | 70〜120B級、gpt-oss-120b、200B級FP4 | DGX Spark公式は最大70BのFT | Strix Halo 約57万〜72万円/DGX Spark 約108万〜113万円 |
| クラウド | A100 80GB/H100で大型モデル | 27B LoRA bf16、70B QLoRA | A100 80GB $1.6〜5.1/h/H100 $2.9〜11/h |
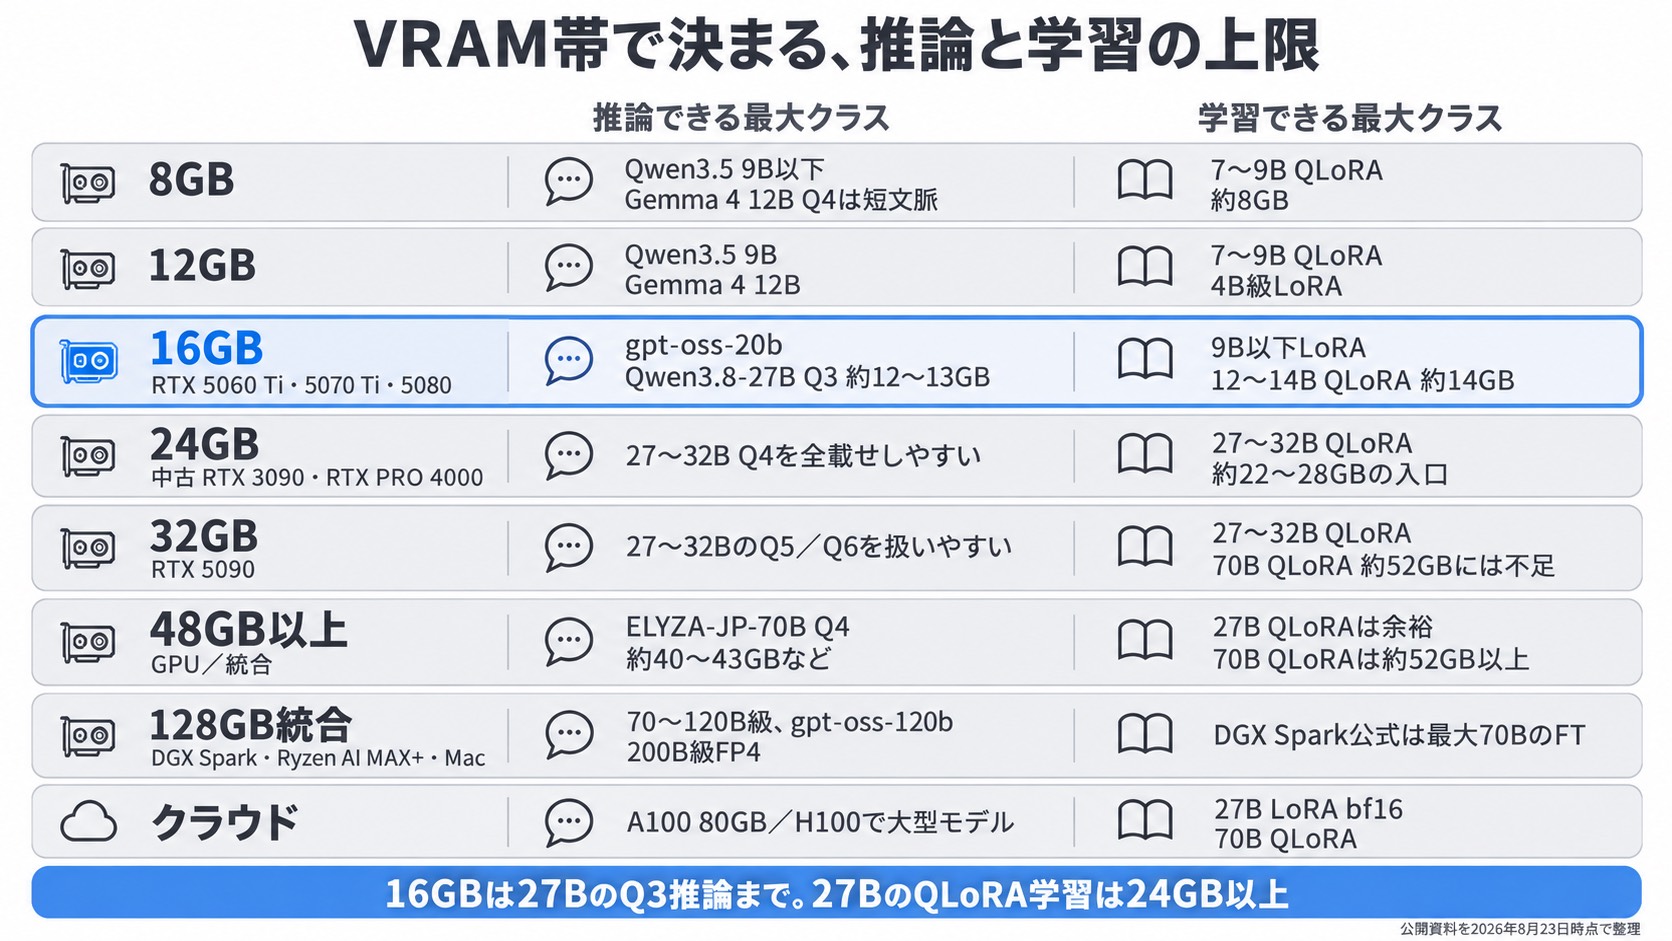
表の価格は2026年9月28日時点で確認した値です。
DRAM相場の影響で価格は週ごとに動くため、予算を組む際は注文画面の最新価格も確認してください。
GPU名が同じでも、BTO本体のメモリ、SSD、電源、冷却構成で総額は変わります。
② 答えてもらうか練習させるかで、要る作業台の広さが変わる(推論と学習のVRAM)
- 答えてもらうだけなら、本の厚み(重み)と会話メモ(KVキャッシュ)を足して見積もる
- 練習させるときは、練習のやり方(方式)と一度に読ませる長さ(文脈長)で要る広さが変わる
- 配布ページの必要メモリが、机(RAM)と作業台(VRAM)のどちらの話かを確かめる
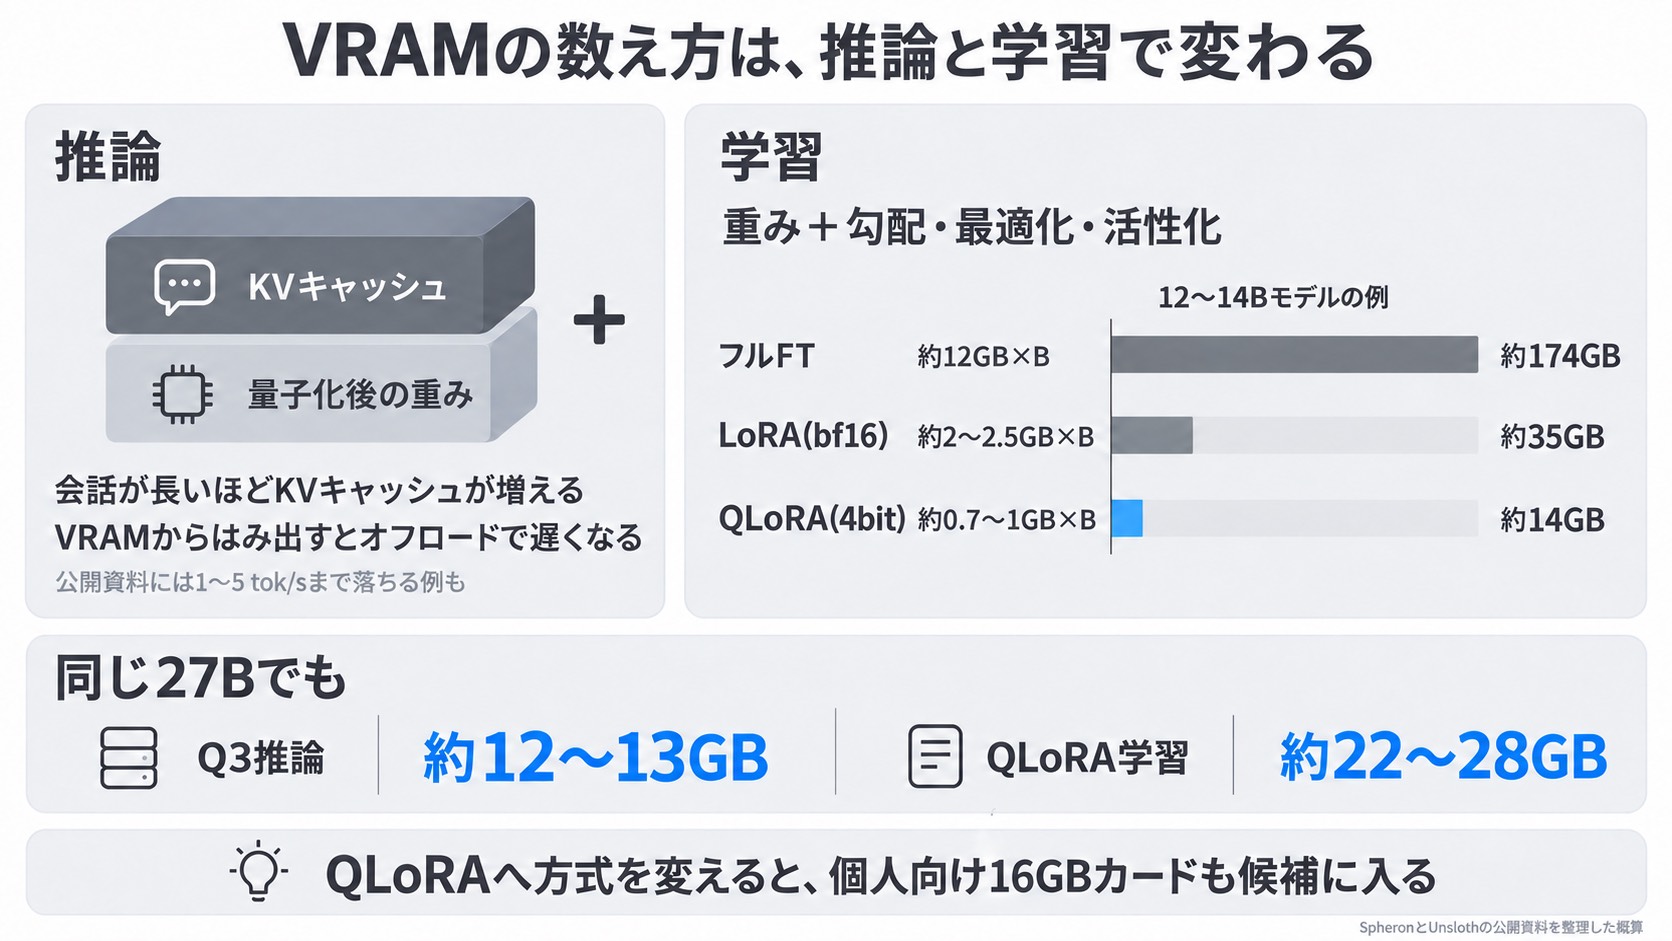
答えてもらうとき:縮小コピーした本の厚みに、会話メモの分を足す(重みとKVキャッシュ)
物知りの人に答えてもらうには、まず縮小コピーした百科事典を作業台に広げます。
推論用VRAMの土台は、作業台に広げる本の厚みにあたる、量子化したモデルの重みサイズです。
会話を続けると、過去のやりとりを書き留めたメモ(KVキャッシュ)も作業台に置くので、使う広さが加わります。
たとえばファイルが15GBなら、16GBの作業台に収まるように見えます。
ただ、長い会話を続けたり画像を渡したりするとメモが増え、VRAMの余白がなくなります。
作業台から本がはみ出すと、一部のページを机(メインメモリ)に置き、要るたびに取りに行くことになります。
CPUとGPUの間でデータを運ぶこの動きをオフロードと呼び、2026年8月時点の公開資料には、全載せできない構成で生成が1〜5 tok/sまで落ちる例があります。
当サイトのRTX 5070 Tiでも、Qwen3.8-27B Q4_K_Mを全層GPU指定で読み込むとエラーは出ないまま生成7.09 tok/s、32K文脈(論文1本くらいの長さ)では4.34 tok/sまで落ちました。
1秒に数語ずつ表示されるのを待つことになるため、モデルが起動するかだけではPCを選べません。
同じファイルでも、GPUに置く層を62〜64に決めて残りをCPUに回すと、生成は26.6〜33.0 tok/sまで戻りました(9月30日の追加計測)。
何巻もある百科事典のうち、作業台に並べる巻の数を先に決め、残りの巻は机に置いておく置き方です。
VRAMの境目にあるモデルでは、どこまでGPUに置くかで速度が大きく変わります。
同じQwen3.8-27Bでも、縮小コピーの度合い(量子化)によって本の厚みが変わります。
Q4_K_Mは本体15.66GiBで16GB VRAMからはみ出し、もう一段薄くしたUD-Q3_K_XLは12.24GiBで全載せできます(当サイトで使ったGGUF形式のモデルファイルの実容量)。
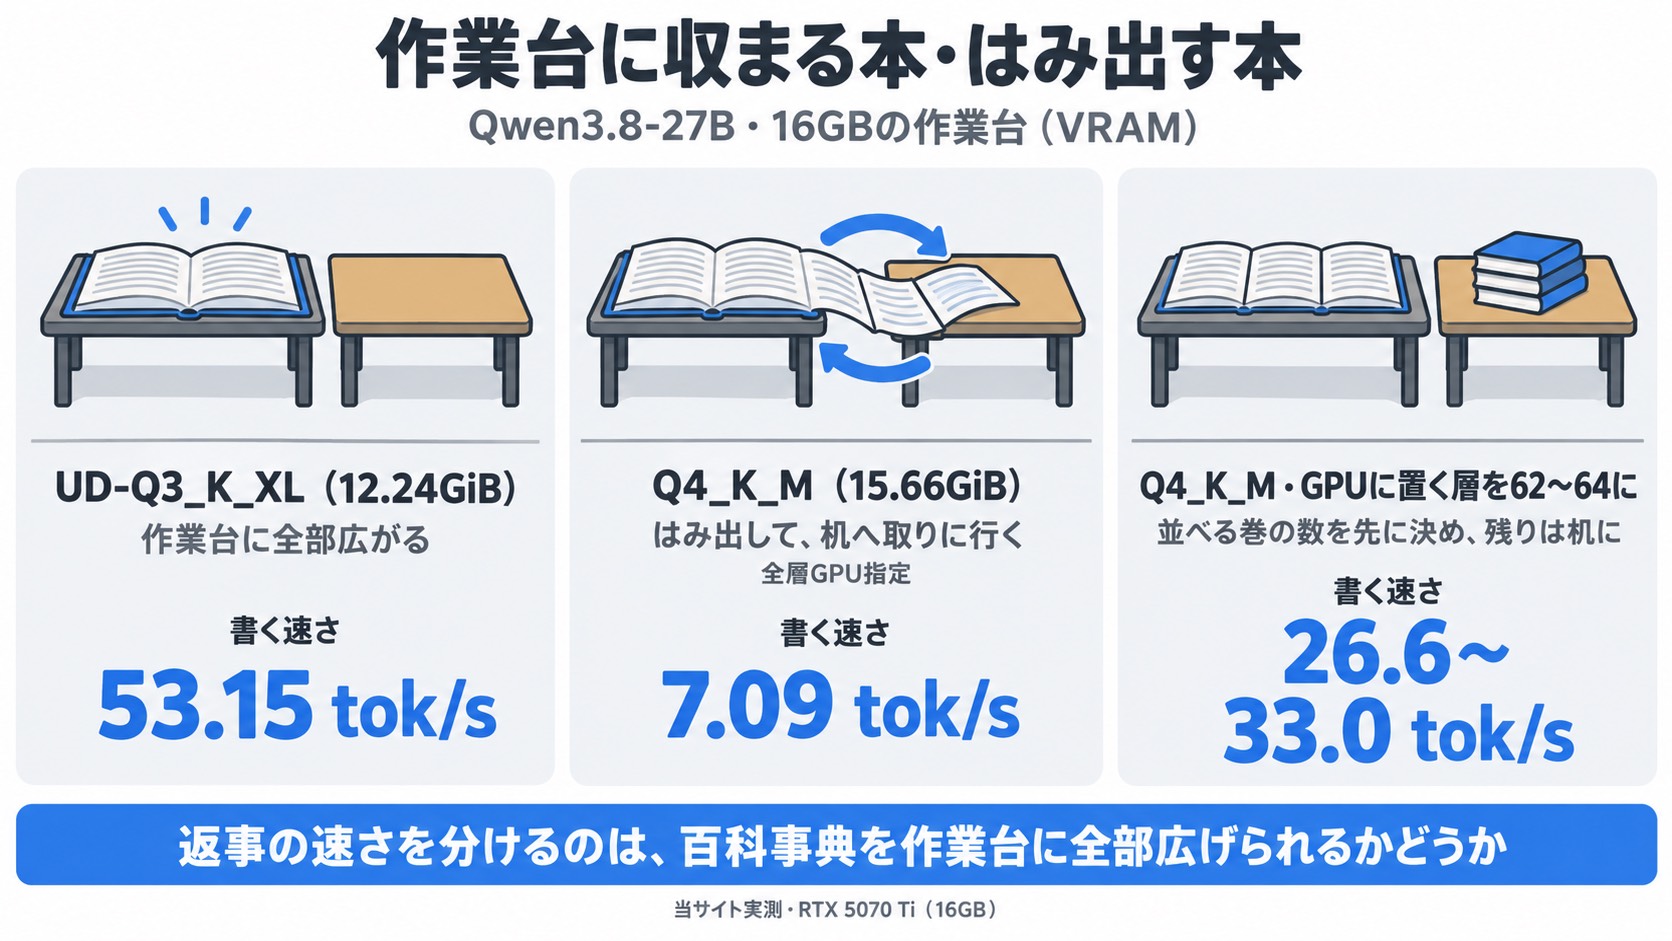
正直、同じ27Bという名前だけで選ぶと、購入後に速度差で戸惑いそうです。
日本語は縮小コピーで細かい字がつぶれたときの変化を感じやすいため、作業台に載せやすいQ3と、品質を取りやすいQ4_K_M以上を分けて考えます。
当サイトの実測では、16GBで常用するなら全層GPUに載るUD-Q3_K_XLが本命で、短い会話が中心ならIQ4_XSも候補でした(第⑧節)。
練習させるとき:本のほかに練習ノートや下書きも広げる(勾配・最適化・活性化)
物知りの人に自分の文体を練習してもらう場面では、百科事典のほかに、添削の跡(勾配)、練習の進め方のメモ(最適化)、途中の下書き(活性化)まで作業台に並びます。
練習のやり方しだいで、並べる量が大きく変わります。
SpheronとUnslothの公開資料を整理すると、方式別の概算は次の通りです。
同じ12〜14Bモデルで必要になる容量も併記します。
- フルFT(百科事典を丸ごと書き直す):約12GB×パラメータ数(B)、12〜14Bなら約174GB
- LoRA(bf16)(本は書き直さず、付せんで追記する):約2〜2.5GB×B、12〜14Bなら約35GB
- QLoRA(4bit)(縮小コピーした本に付せんを貼る):約0.7〜1GB×B、12〜14Bなら約14GB
縮小コピーした本に付せんを貼るQLoRAへ方式を変えると、個人向け16GBカードも候補に入ります。
学習時のVRAM使用量を大きく左右するのが、一度に読ませる文章の長さ(文脈長)を指定するmax_seq_lengthです。
たとえば長いメール数通くらいの短い教材のために256K文脈を確保すると、使わない活性化領域(下書き用の場所)まで作業台を占有します。
公開資料では、学習を軽くする道具のUnslothにより最大70%のVRAM削減、Qwen3.5では50%削減、gradient checkpointing(途中の下書きを一部捨てて、要るときに書き直す工夫)では活性化を40〜60%減らす目安が示されています。
モデル名だけでなく、文脈長、batch(一度にまとめて練習させる問題の数)、LoRA設定までそろえて比べる必要があります。
16GBは9B以下のLoRAと12〜14BのQLoRAを狙う帯ですが、LoRAの精度形式と実装条件で必要量は変わります。
Unsloth公式のQwen3.5 9B LoRA(bf16)目安は約22GBなので、9Bを16GBで扱う場合はQLoRA、短い文脈、gradient checkpointingも比較候補です。
16GBでLoRAを狙いやすい例は、公開値約10GBのQwen3.5 4B。
9Bが一律に載るとは断定しません。
当サイトの16GB機での学習は10月13日に試運転し、通った条件と止まった条件をあとで追記します。
「27B=17GB」は机と作業台の合計かもしれない(RAMとVRAM)
必要な広さが17GBと書かれていても、作業台だけで17GBなのか、机と作業台を合わせて17GBなのかで話が変わります。
配布ページの必要メモリ欄に17GBとあっても、17GB VRAMを意味するとは限りません。
メインメモリとVRAMの合計、またはMacやRyzen AI MAX+の統合メモリを示す表記があります。
購入前に見る項目は次の3点です。
- GGUFファイルの大きさ(本の厚み)
- KVキャッシュの余白(会話メモを置く場所)
- GPUへ何層載るか(作業台に置ける巻の数)
統合メモリは作業台と机が1つの大きな台になったつくりで、CPUとGPUが同じ領域を使うため、48GBや128GBをモデルへ回せます。
一方、Windowsデスクトップの32GB RAMと16GB VRAMは机と作業台が別々なので、48GBのVRAMカードと同じ動きにはなりません。
名称上の合計容量ではなく、GPUが直接読める領域を確認すると、1〜5 tok/sのオフロードを避けやすくなります。
③ 作業台の広さ別にできること(VRAM 8GB〜128GB)
- 薄い百科事典(小型モデル)なら、小さな作業台から試せる
- 答えてもらうのと練習させるのとでは、要る広さが違う
- 大きな練習は、クラウドの広い作業台を時間で借りる手もある
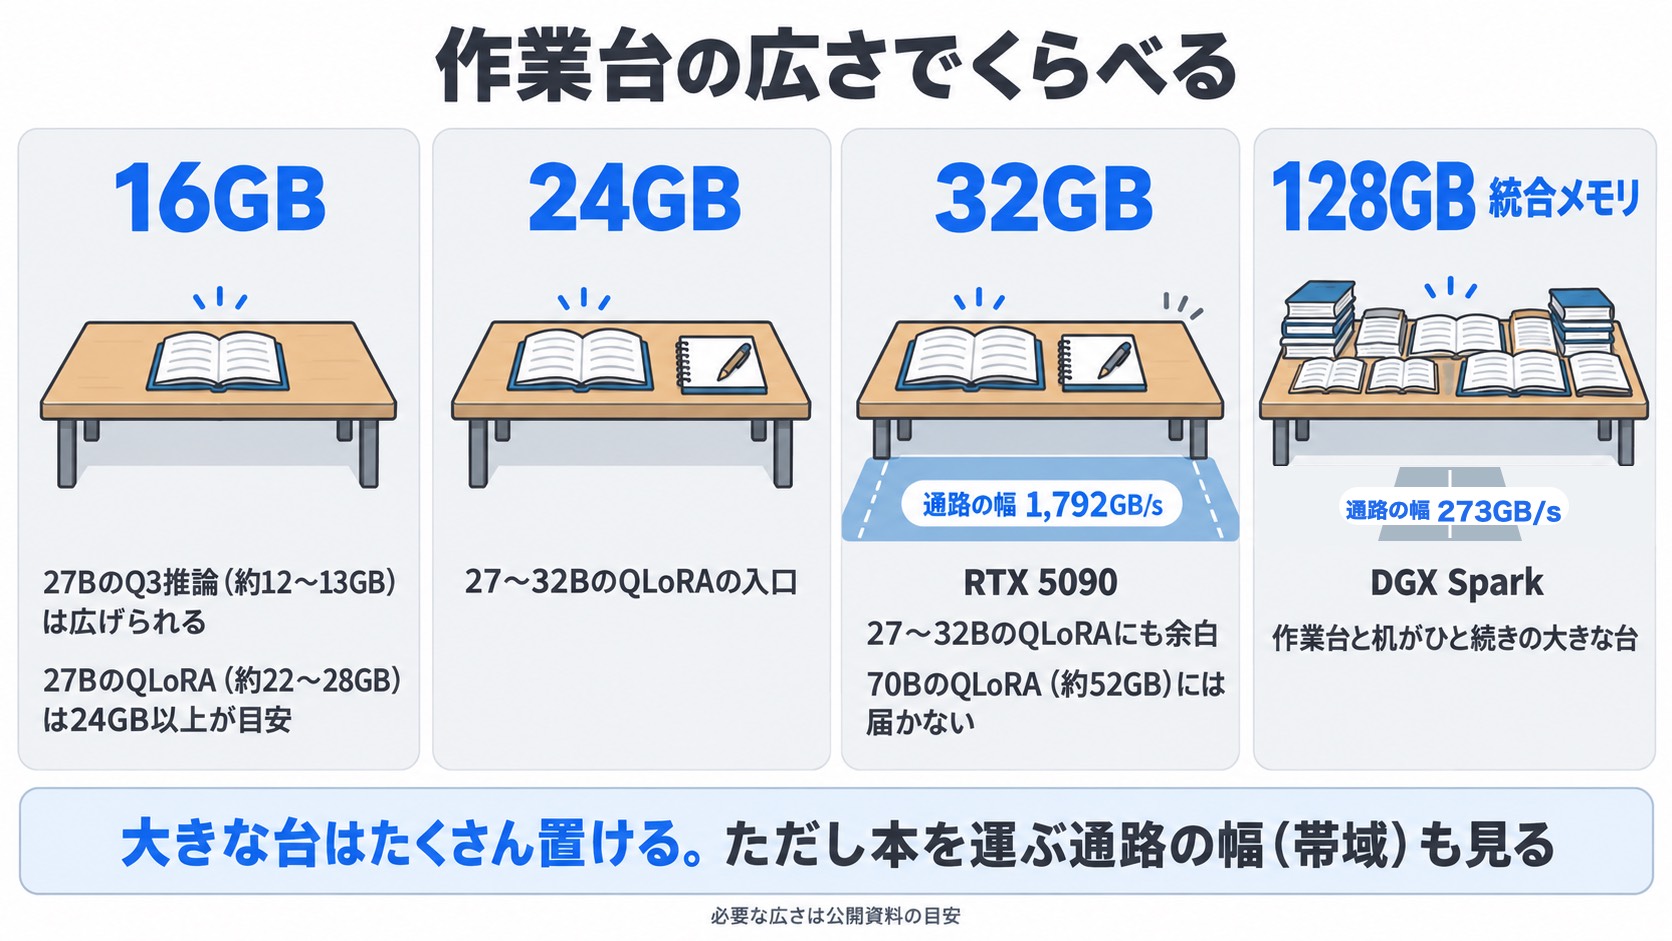
作業台の広さで並べると、8〜12GBは薄めの百科事典なら広げられる小さな台、16GBは27Bの縮小コピーまで広げられる台です。
24GBと32GBは、その本の横に練習ノートまで並べられる台にあたります。
128GBの統合メモリは作業台と机がひと続きになった大きな台で、たくさん置ける代わりに、本を運ぶ通路の幅(帯域)も見ておく必要があります。
8〜12GB:薄い百科事典(小型モデル)で、推論と学習の流れを覚える
8〜12GB帯は、次の小型モデルから始める構成です。
- Qwen3.5 4B
- Gemma 4 E4B
- Sarashina 2.2 3B
Sarashina 2.2 3BはQ4で約2GB、Qwen3.5 4BのLoRA(bf16)はUnsloth公式の目安で約10GB。
練習問題をJSONLという形式に整え、練習させ、付せんにあたるアダプタをGGUFへ書き出してOllama(ローカルLLMを動かすアプリ)で読み込む、という一連の流れを、PCを大きく買い替えずに試せます。
GPUを持っていない場合は、16GBの無料Colab T4も入口になります。
公開資料の目安ではQwen3.5 4BまでのLoRAや8B QLoRAが候補です。
毎晩回す用途には待ち時間や接続条件が残りますが、学習データの作り方を確かめる段階なら、GPU購入前の試走として使えます。
16GB(RTX 5060 Ti・5070 Ti・5080):27Bは縮小コピーで答えてもらい、練習は12〜14Bまで
2026年9月28日時点の価格.comでは、価格は次の通りです。
- RTX 5060 Ti 16GB:約12万〜16万円
- RTX 5070 Ti:約21万〜25万円
- RTX 5080:約27万〜35万円
RTX 4060 Ti 16GBは、新品の掲載が1製品だけでした。
作業台の広さは同じ16GBでも、本を運ぶ通路の幅(メモリ帯域)は次のように違います。
- 4060 Ti:288GB/s
- 5060 Ti:448GB/s
- 5070 Ti:896GB/s
VRAMへ同じモデルが収まる構成どうしなら、通路の広さ(帯域)も書く速さを左右します。
当サイトの5070 Ti実測は第⑧節にまとめました。
推論では、はじめから縮小コピー(MXFP4)を前提に作られたgpt-oss-20bが16GBに載り、Qwen3.8-27BはUD-Q3_K_XLの12.24GiBなら全載せできます。
Q4_K_Mの15.66GiBは作業台からはみ出します。
当サイトの実測では全層GPU指定で7.09 tok/s、GPUに置く層数を62〜64に指定して一部をCPUに回すと26.6〜33.0 tok/sでした。
27Bを動かせるという説明だけで16GBを選ぶと、縮小コピーの品質と速度のどちらを優先するかで迷います。
当サイトの実測では、16GBで27Bを毎日使うならUD-Q3_K_XLが本命で、短い会話が中心ならIQ4_XSも候補です。
16GBで27B級を使えるという話は、答えてもらう推論のことです。
練習させる学習は、9B以下のLoRAと12〜14BのQLoRA(公開目安 約14GB)が上限候補です。
27〜32BのQLoRAは約22〜28GBなので、24GB以上の帯で考えます。
今回の16GB機では27Bを学習できた前提にせず、10月13日の試運転で通るモデルの大きさを確かめます。
24GB(中古 RTX 3090・RTX PRO 4000):27〜32Bに練習させられる入口(QLoRA)
24GBへ上げる理由は、27〜32Bの百科事典を広げたまま練習ノートも並べられる、QLoRA学習です。
2026年8月公開資料の目安は約22〜28GBで、短い文脈や小さなbatchなら24GB、余白を取りたい運用なら32GB以上が候補になります。
Qwen3.8-27BはQLoRA 24GB最低、48GBで余裕を取りやすいという公開目安です。
2026年9月28日時点の候補は、中古RTX 3090 24GBが約18万〜24万円(販売店の在庫は少数)、RTX PRO 4000 Blackwell 24GBが約40万〜47万円。
RTX 3090は936GB/sの広い通路(帯域)を持ちますが、中古品は保証、電源、冷却、使用歴まで含めて判断します。
RTX PRO 4000 Blackwellは省電力を優先する小規模事業者に合う一方、GPU単体価格は16GB帯より上です。
32GB(RTX 5090):広い作業台でも、70Bの練習(QLoRA)には届かない
RTX 5090は32GB GDDR7の作業台と1,792GB/sの広い通路(帯域)を持ち、27〜32B QLoRAにも余白を作れます。
価格.comでいちばん安い価格は、7月の約70万円から2026年9月28日時点の約100万円へ上がり、高い製品は約145万円です。
推論と学習を毎日回し、時間短縮が売上へつながる人には検討理由がありますが、週末だけ触る個人には大きな初期費用です。
32GBの作業台でも、70Bの百科事典に練習ノートまで並べるには狭く、70B QLoRAの目安約52GBには届きません。
RTX 5090でも、ローカル学習のすべてをこなせるわけではありません。
RTX 5090は、27〜32Bの推論とQLoRAに使う構成です。
70Bの学習が月に数回なら、80GB GPUを時間で借りるほうが手元の設備を小さく保てます。
128GB統合メモリ(DGX Spark・Ryzen AI MAX+・Mac):大きな台に載るが、通路の幅(帯域)も見る
DGX Sparkは、作業台と机がひと続きになった128GB LPDDR5X統合メモリを持ちます。
帯域は273GB/sで、200B級FP4推論と公式最大70Bのファインチューニングを掲げます。
国内実売は約108万〜113万円(2026年9月28日時点)。
台は大きくても通路は狭めなので、分厚い本ほど書く速さが落ちます。
公開例のLlama 3.1 70B FP8はデコード2.7 tok/s、gpt-oss-20bは83 tok/sで、RTX 5090のgpt-oss-20b約325 tok/sとは役割が違います。
Ryzen AI MAX+ 395のミニPCは128GBのうち最大96GBをGPUへ割り当て、価格は約57万〜72万円(2026年9月28日時点)、帯域は256GB/sです。
70〜120B級を手元で動かす候補になりますが、CUDA(NVIDIAのGPU向けの道具一式)ではなく、AMDのGPUでも動くROCmやVulkanを使います。
Mac mini M5 Pro 48GBは約41万円から、307GB/sで、Mac向けの道具(MLXやPyTorch MPS)でLoRAへ進めますが、CUDA前提の手順をそのまま移せません。
クラウドGPU:広い作業台を、大型学習のときだけ時間で借りる
クラウドGPUは、使った時間だけ料金を払って借りる、レンタルの広い作業台です。
1時間あたりの料金は、2026年9月28日時点の各社公開価格でA100 80GBが$1.6〜5.1/h、H100が$2.9〜11/hです。
27B LoRA(bf16)や70B QLoRAのように、16GB・24GBカードでは届かない作業へ必要な時間だけ使えます。
データのアップロード、保管、停止忘れの管理は増えますが、100万円級のGPUを先に買わずに学習結果を確かめられます。
④ どの百科事典を選ぶか(選ぶ価値があるオープンウェイトモデル)
- 練習までさせたいなら、本の厚み(規模)で選ぶ
- 日本語の得意さと、使ってよい範囲(ライセンス)を確かめる
- 個人のPCの台に載らない巨大な本は、先に候補から外す
オープンウェイトモデルは、中身(重み)が公開され、自分のPCに持ち帰って使える百科事典のようなものです。
同じ百科事典でも、厚さ、得意な言語、使ってよい範囲が違うので、作業台の広さと用途に合わせて選びます。
ローカルで練習(学習)まで狙える4系統
Qwen3.8-27Bは2026年8月13日公開です。
27B dense(分冊に分かれていない1冊ものの百科事典)、Apache 2.0、視覚入力、256K文脈、思考モードの強弱に対応し、SWE-bench Pro 61.7、OSWorld 84.3という公開値があります。
16GBではUD-Q3_K_XLやIQ4_XSでの推論が候補です。
学習は24GB最低・48GBで余白を取るモデルです。
答えてもらうのと練習させるのとで、必要なGPU帯が変わります。
当サイトのRTX 5070 TiでQwen3.8-27BをUD-Q3_K_XL・IQ4_XS・Q4_K_Mの3つの量子化で動かし、速度・長い文章・回答品質を比べた結果はQwen3.8-27Bの16GB実測にまとめています。
小型モデルから学習工程を作るなら、Qwen3.5 Smallの0.8B/2B/4B/9Bがあります。
2026年3月2日公開、Apache 2.0、視覚入力、思考と非思考の切り替え、262K文脈、201言語に対応します。
Unsloth公式のLoRA(bf16)目安は0.8Bが3GB、2Bが5GB、4Bが10GB、9Bが22GB。
薄い版から厚い版まで同じシリーズなので、0.8Bから9Bまで同系統で教材と手順を試し、必要な段階でQLoRAへ移れます。
Gemma 4にはE2B/E4B/12B/26B-A4B/31Bがあります。
2026年4月2日公開でGemmaとして初のApache 2.0、全サイズが視覚入力に対応。
E2B・E4B・12Bは30秒の音声入力、思考モード(答える前に下書きして考える)、ネイティブ関数呼び出しも備え、12BはT4/16GBでLoRAを狙える公開目安です。
Gemma 4のうち26B-A4BをQAT Q4_0で動かした結果は、Gemma 4 26B-A4Bの16GB実測にあります。
32Kまで積んでも全層GPUに載り、VRAMの空きは約0.4GBで、作業台の端まで本で埋まった状態でした。
OpenAIが2025年8月5日に公開したgpt-oss-20bも16GB帯の候補です。
21B MoE(分野ごとの専門家の分冊に分かれた百科事典)で、1トークン書くたびに開くのは3.6B分にとどまり、MXFP4を前提に16GBで推論できます。
Unslothの公称では約14GBでLoRA可能ですが、実装条件で成否が変わり、当サイトの16GB機ではまだ学習を試していません。
推論で載ることと、学習が最後まで完走することは分けて考えます。
gpt-oss-20bの深さ別の速度、LM Studioでの使い心地、Thinkingの段階ごとの正答数はgpt-oss-20bの16GB実測で扱っています。
VRAM 16GBの作業台に収まらない総125BのQwen3.8-Flash-Nextを、Strataという道具で机(メモリ32GB)と本棚(SSD)に分けて置いて動かした結果はQwen3.8-Flash-Nextの32GB実測にあります。
出力は2回目から約70 tok/s出ましたが、本1冊分くらいの資料(128K)では最初の文字まで約4分かかり、メモリの余白もわずかでした。
日本語で選ぶなら、使ってよい範囲(ライセンス)まで一緒に見る
日本語特化モデルの候補は次の通りです。
- 東京科学大のGPT-OSS-Swallow v0.1/Qwen3-Swallow v0.2
- NIIのLLM-jp-4
- SB IntuitionsのSarashina 2.2
- PFNのPLaMo 2 8B
- ELYZAのLlama-3系
口調や社内フォーマットを学ばせる用途では、練習前のそのままの日本語の答えを比べてから教材を作ると、直したい癖が見えます。
たとえば敬語が硬すぎる、何でも箇条書きにする、といった癖です。
仕事やサービスで使う商用利用では、モデル名だけでなく、次のライセンスと条件を読みます。
- Qwen、Gemma 4、gpt-oss、Swallow:Apache 2.0
- DeepSeek:MIT
- Llama 4 Community:7億MAU(月間利用者数)条項
- PLaMo Community LicenseとNVIDIA Open Model License:個別条件あり
自社サービスへ組み込む場合は、学習開始前に配布条件と表示義務を確認すると設計を戻さずに済みます。
個人のPCの台に載らない巨大な本を、先に候補から外す
個人PCでは収まらないモデルの目安は次の通りです。
- Kimi K3:2.8T MoE、重み約1.56TB、B200×16推奨
- DeepSeek V4-Flash:4bitで約150GB
- GLM-5.2:2bitでも約245GB
- Qwen3.8-2.4T-A95B:1bitでも397GB、RAM 450GB以上が目安
32GBのRTX 5090や128GB統合メモリ機を買っても、すべてのモデルを個人PCで動かせるわけではありません。
巨大モデルを候補から外すと、予算は小型モデルの学習品質、RAG(必要な資料をその場で手渡す仕組み)、評価データへ回せます。
公開スコアが高いモデルを無理に縮めるより、9B・12B・27Bの中から業務に合うサイズを選びます。
自分の作業で待ち時間と出力品質を確かめられる規模なら、ローカル環境を長く使いやすくなります。
⑤ 練習で変わるのは、知識より話し方や答え方(学習で変えられること)
- 練習(学習)は、口調や答えの形をそろえるのに向く
- 新しい情報は練習させず、資料として手渡す(RAG・検索)
- お客さまの実データは使わず、架空のデータ(合成データ)で練習させる
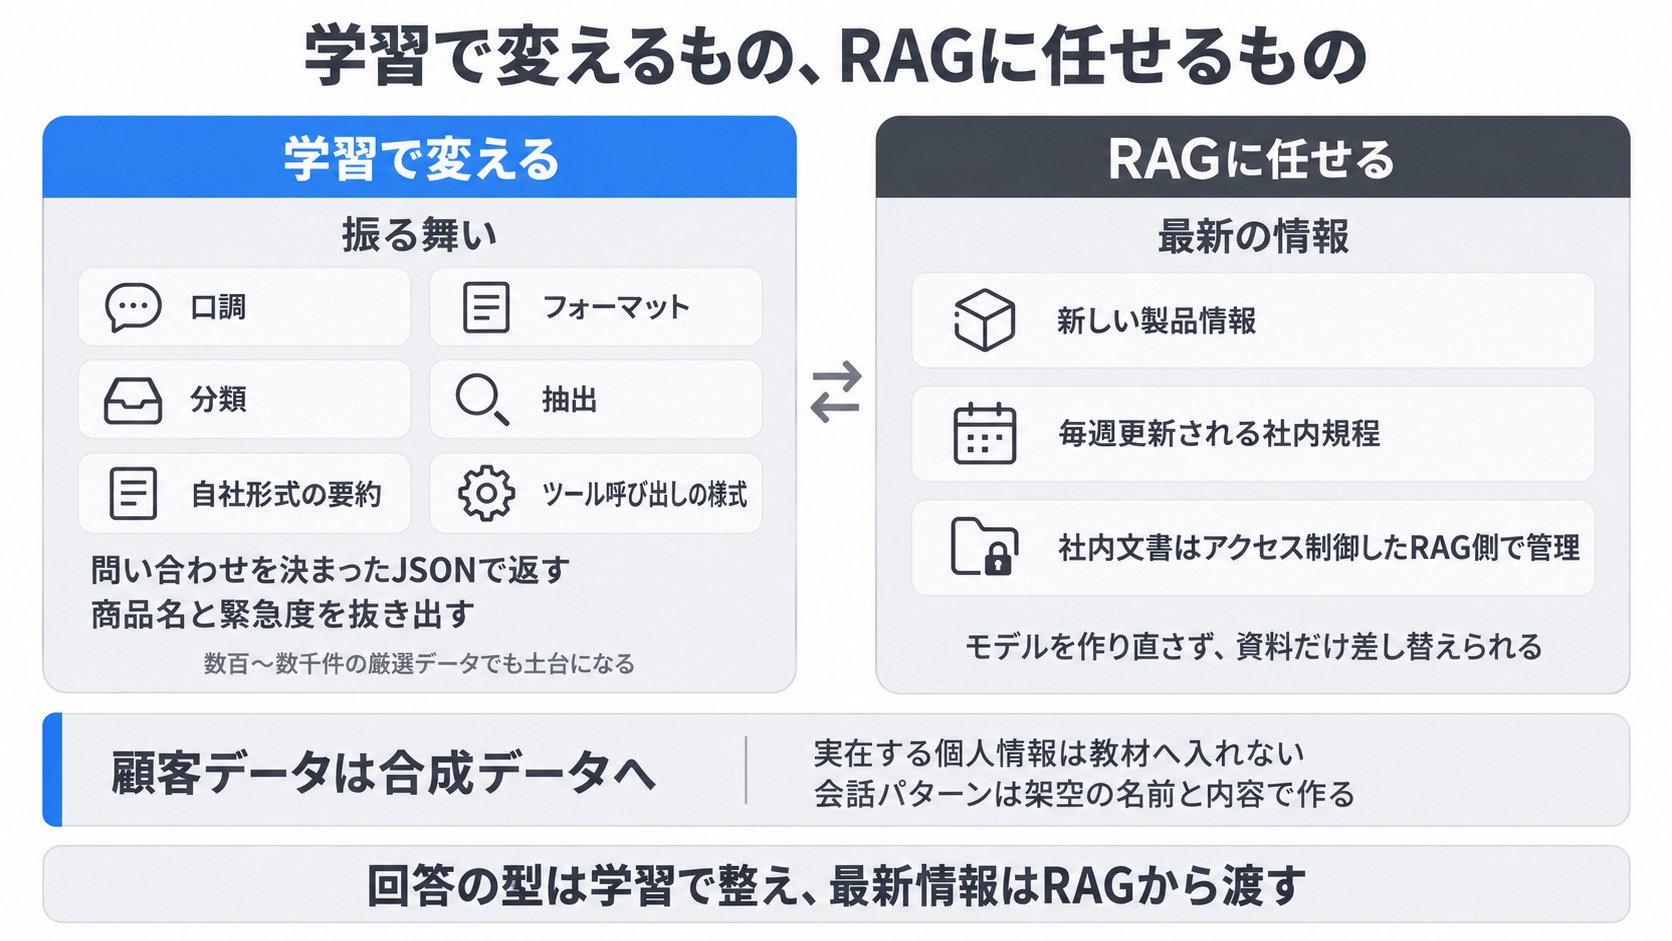
口調・答えの形・仕分けは、練習(ファインチューニング)で身につきやすい
物知りの人に、自分の文体で書く練習をしてもらう場面を思い浮かべてください。
何度か練習すると話し方や書式は身につきますが、来週変わる社内ルールを覚えさせても、変わるたびに練習のやり直しになります。
ファインチューニング(追加の学習)で整えやすい項目は次の通りです。
- 回答の口調
- フォーマット
- 分類と抽出
- 自社形式の要約
- ツール呼び出しの様式
公開資料の整理では、数百〜数千件の厳選データでも振る舞いを変える土台になります。
具体的な用途は次の通りです。
- 問い合わせを決まったJSONで返す
- レビューを同じ段落リズムで書く
- 商品名と緊急度を抜き出す
新しい製品情報や、毎週更新される社内規程を覚えさせる用途はRAGや検索へ分けます。
学習済みモデルへ事実を固定すると、情報が変わるたびに教材の更新と再学習が必要です。
回答の型は学習で整え、回答に使う最新情報はRAGから渡します。
役割を分けると、モデルを作り直さずに資料だけ差し替えられます。
実は10月13日に試運転する学習で、モデルに覚えさせたいのは当サイトの記事の書き方です。
合成した問い合わせ形式の学習は、書き方の学習の結果を見てから判断します。
「知識を詰め込んだ専用AI」ではなく、「必要な資料を受け取り、決めた型で返すAI」を目標にします。
小規模事業者が更新を続けるなら、学習回数を増やすより運用を分けるほうが扱いやすい設計です。
お客さまのデータは、架空のデータ(合成データ)に置き換える
練習に使った文章は物知りの人の記憶に残り、別の質問をされたときにふと口に出ることがあります。
PCの中だけで学習しても、次の情報をモデルが記憶し、別の入力で出力する可能性は残ります。
- 顧客名
- 住所
- 問い合わせ本文
ローカルで動かすと通信先は減らせますが、学習データの安全性まで自動で確保できるわけではありません。
実在する個人情報は教材へ入れず、必要な会話パターンを架空の名前と内容で作ります。
社内文書を検索したい場合も、文書そのものはアクセス制御したRAG側で管理します。
学習データには「問い合わせを分類し、引用元を示し、担当者へ渡す」という振る舞いだけを置く分担です。
合成データなら学習用ファイルをレビューしやすく、削除や再生成の範囲も見えます。
正直、精度を求めて急いで実データを混ぜるより、漏えい時の影響を小さくする設計を先に決めたいと考えています。
⑥ 机・本棚・電源の基準(メモリ32GB・NVMe 1TB・電源750W)
- 机(RAM)を広げても、作業台(VRAM)は広がらない
- 本棚(SSD)には、百科事典と練習の成果をしまう
- 長い練習を支えるのは、電源と冷却
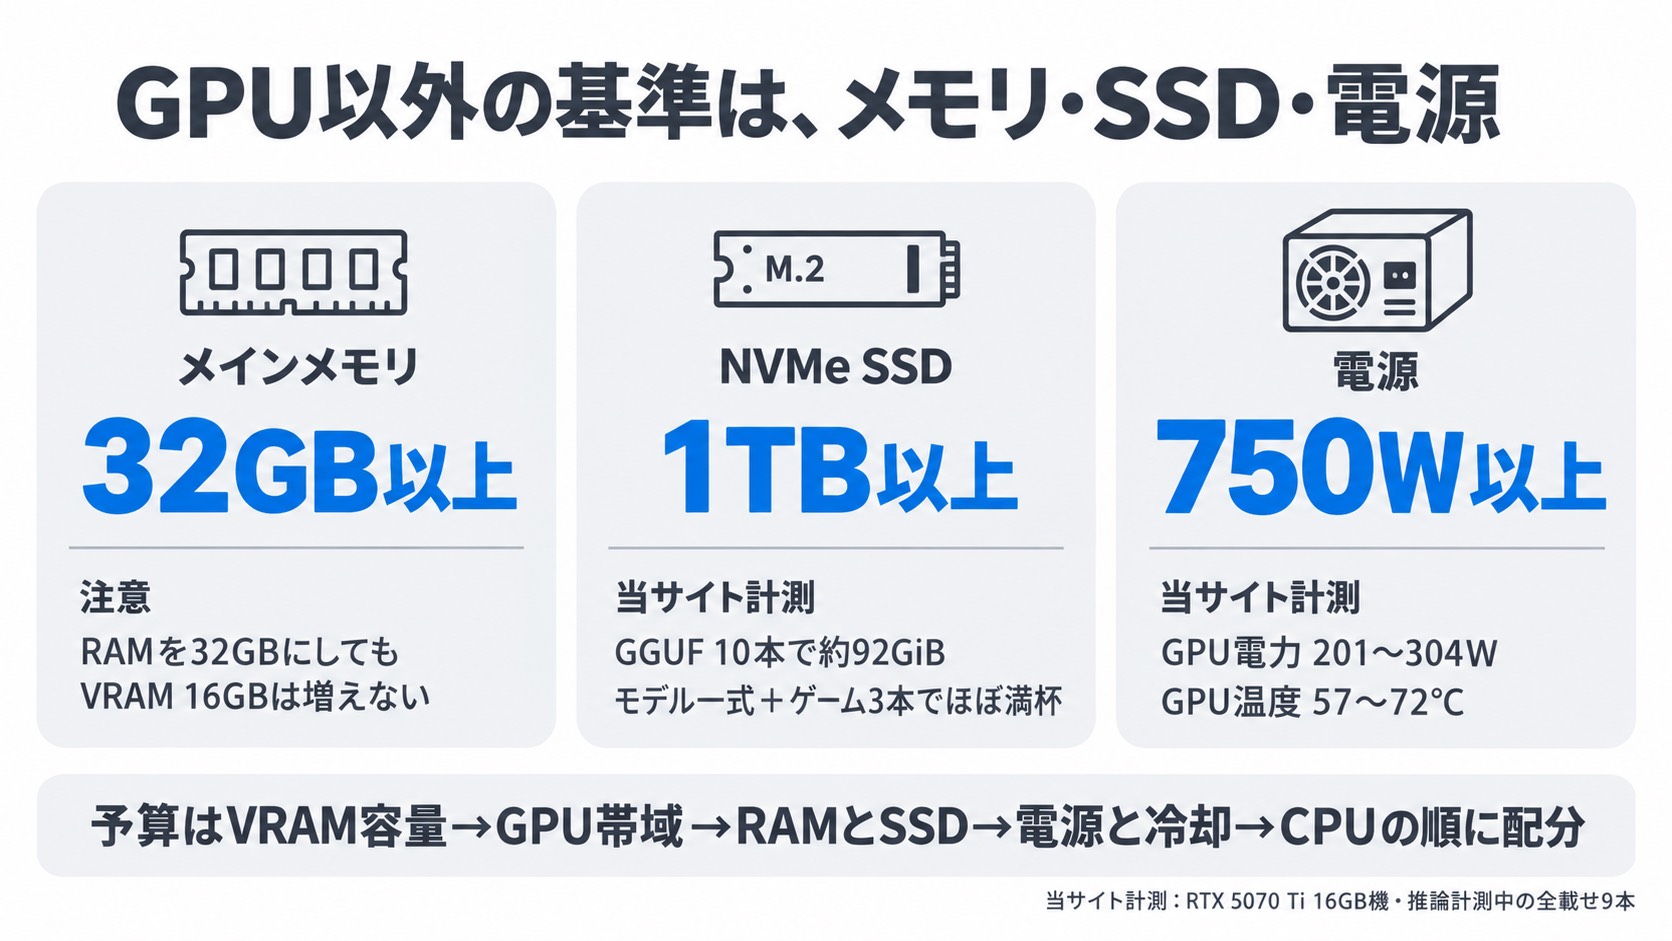
作業台(GPU)にお金をかけても、本をしまう本棚(SSD)や、作業の途中で物を置く机(メモリ)が足りなければ、作業は止まります。
ローカルLLM用PCは次の条件を出発点にします。
- メインメモリ32GB以上
- NVMe SSD 1TB以上
- 電源750W以上
- GPUに合う冷却
机を32GBに広げても16GBの作業台が32GBに増えるわけではなく、RAMとVRAMの役割は別です。
RAMは、作業台に載らないページの一時置き場や、ブラウザなどほかのアプリの場所として働きます。
本棚にあたるNVMe SSDには次のデータを置きます。
- 配布モデルと量子化違いのGGUF
- 学習データとアダプタ
- 16bitマージと評価結果
Qwen3.8-27BだけでもQ4_K_M 15.66GiBとUD-Q3_K_XL 12.24GiBを比較し、9月3日時点で10本のGGUFを並べました。
1TBを基準にすると、検証のたびに別のドライブへモデルを移す回数を減らせます。
ただ、当サイトの計測機の1TB構成は、GGUF 10本(本体だけで合計約92GiB)を含むモデル一式とゲーム3本を入れた段階で、ほぼ満杯になりました。
ゲームと兼用するなら、1TBの本棚では足りなくなると考えておくほうが安全です。
電源750W以上と冷却は、GPUを長時間動かす土台です。
学習では短いベンチマークより負荷が続くため、電源容量だけでなくケースの吸排気やGPU周辺の温度も見ます。
当サイトの計測機FRONTIER FRGKB860M/CG3は、公開された計測計画によると850W 80PLUS PLATINUM電源、32GB DDR5-5600、1TB NVMeを搭載する構成です。
第⑧節の推論計測中、全載せできた9本のGPU電力は201〜304W、GPU温度は57〜72℃でした(当サイト計測)。
FRGKB860M/CG3は、よほど負荷の高い処理でない限りファンの音がほとんど聞こえず、とても静かです。
学習のように負荷が長く続く場面で音と温度がどう変わるかは、10月13日からの学習で確かめます。
モデルをGPUへ全載せした推論では、CPUよりVRAM容量とメモリ帯域を先に見ます。
オフロードが始まるとCPUとRAMも処理へ入るため、CPUは関係ないと切り捨てられません。
予算は次の順で配分し、GPU交換後の追加費用まで一つの見積もりへ入れます。
- VRAM容量
- GPU帯域
- RAMとSSD
- 電源と冷却
- CPU
⑦ 何をしたいかで選ぶ3つのPC構成(目的別)
- 答えてもらうのが目的なら、本を作業台に全部広げられるかで選ぶ
- 練習までさせるなら、練習させたい本の厚みから構成を決める
- 大きな本で練習させるなら、作業台の広いGPUを検討する
ゲーム用のPCは予算から選びがちですが、ローカルLLM用のPCは、広げたい百科事典の厚さと、練習までさせたいかで決まります。
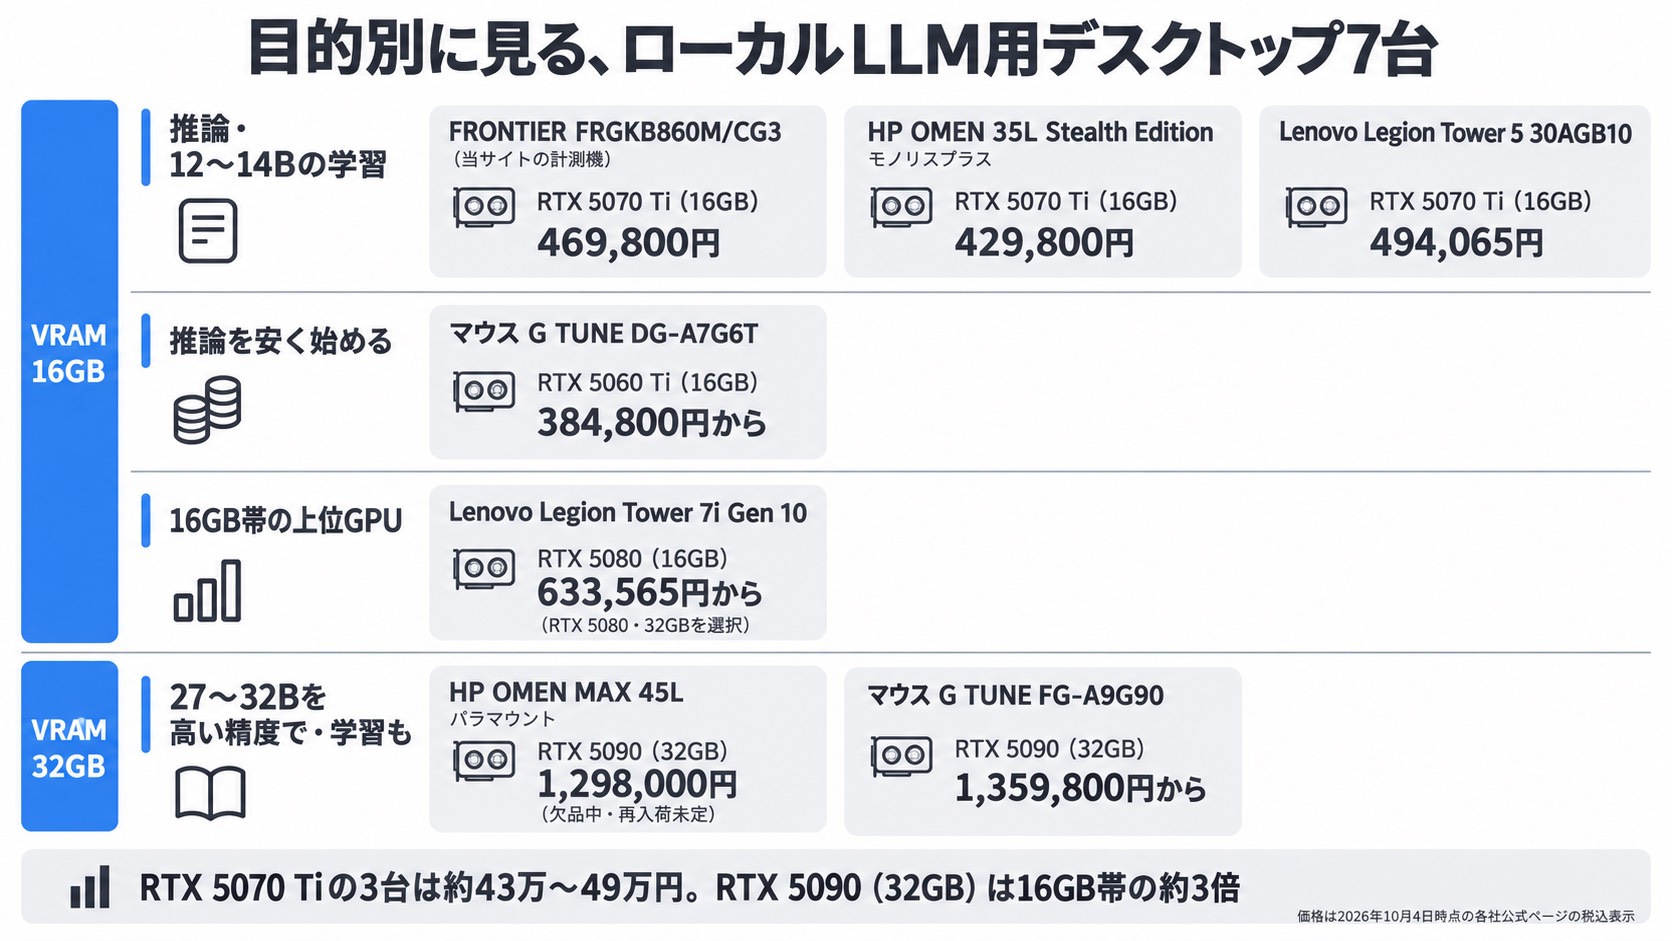
下の表に、VRAM 16GB以上のデスクトップを4社から7台並べました。
ノートPCは、同じGPU名でもデスクトップ版よりVRAMが少ない構成があるため外しています。
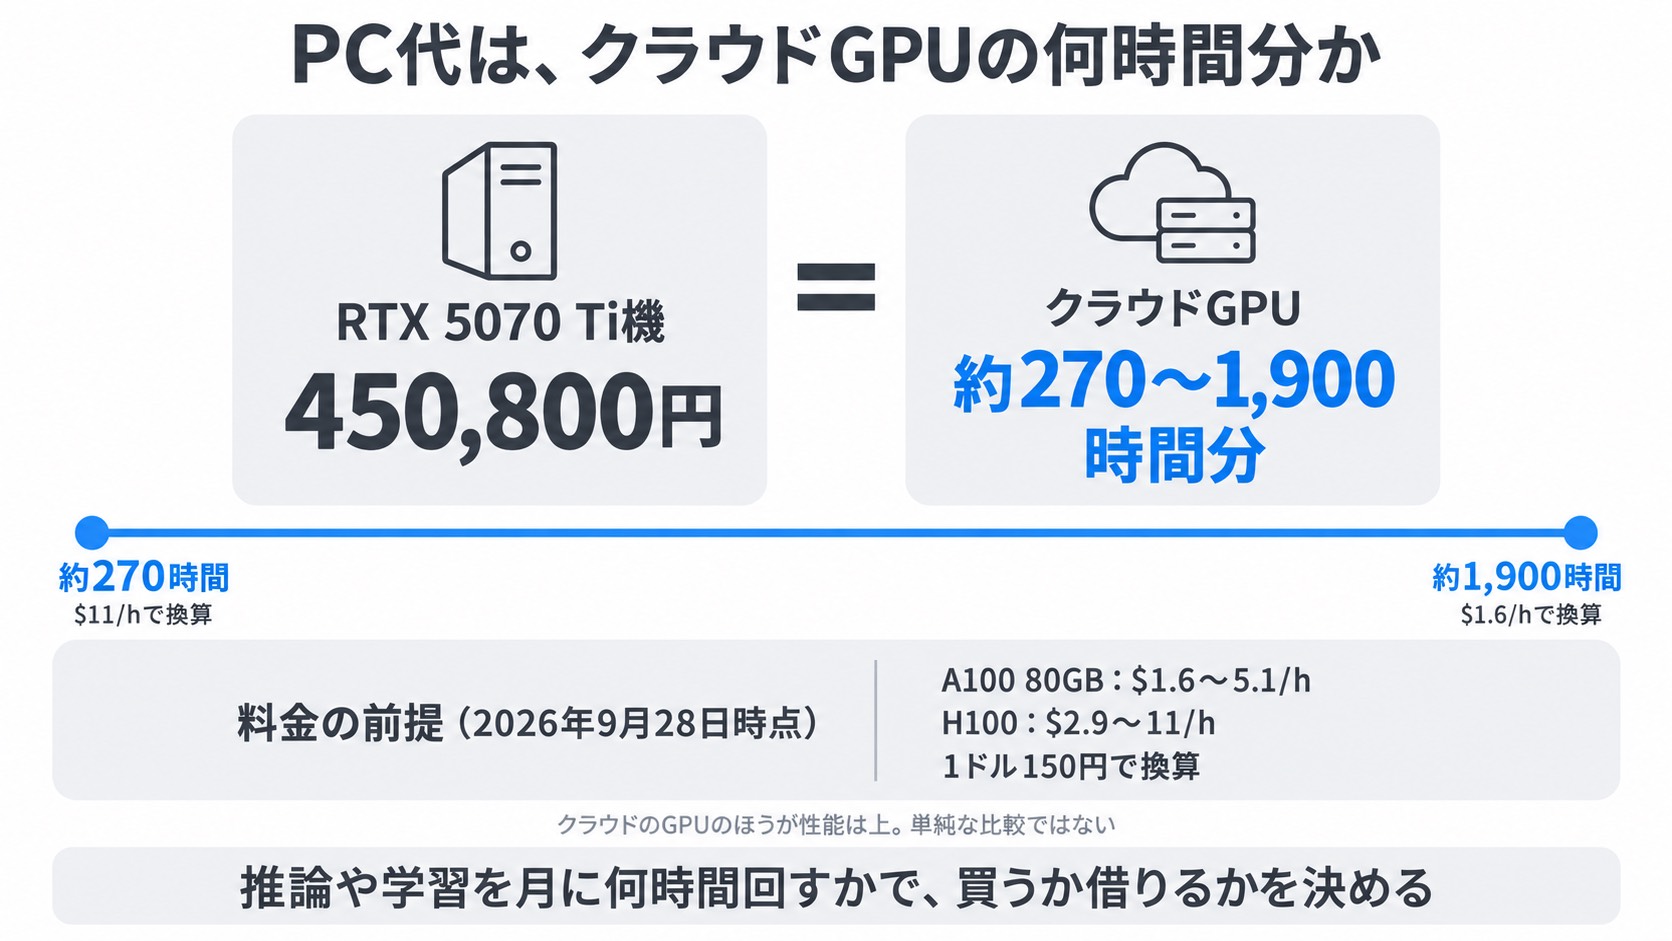
PC代を回収できるかは、クラウドGPUの料金と比べると見積もれます。
第③節のA100 80GB/H100の1時間あたりの料金$1.6〜11/hを1ドル150円で換算すると、2026年9月28日時点で450,800円だったRTX 5070 Ti機は約270〜1,900時間分の利用料に当たります。
クラウドのGPUのほうが性能は上なので単純な比較にはなりませんが、推論や学習を月に何時間回すかを見積もると、買うか借りるかを決めやすくなります。
この表の見方:いちばん左の「目的」で、自分に近い行を探します。
たとえば、まず答えてもらうだけを安く試したいなら「推論を安く始める」の行、27〜32Bを縮小しすぎない版で動かして練習もさせたいなら下の2行です。
| 目的 | 機種 | GPU(VRAM) | 主な構成 | 価格(2026年10月4日時点) | 購入 |
| 推論・12〜14Bの学習 | FRONTIER FRGKB860M/CG3 (当サイトの計測機)  | RTX 5070 Ti(16GB) | Core Ultra 7 265F/32GB/1TB/850W | 469,800円 | 公式ページを見る |
| 推論・12〜14Bの学習 | HP OMEN 35L Stealth Edition モノリスプラス  | RTX 5070 Ti(16GB) | Core i7-14700F/32GB/2TB/850W | 429,800円 | HP公式を見る |
| 推論・12〜14Bの学習 | Lenovo Legion Tower 5 30AGB10 | RTX 5070 Ti(16GB) | Ryzen 7 7700X/32GB/1TB/850W | 494,065円 | 公式ページを見る |
| 推論を安く始める | マウス G TUNE DG-A7G6T | RTX 5060 Ti(16GB) | Ryzen 7 5700X/32GB/1TB/750W | 384,800円から | 公式ページを見る |
| 16GB帯の上位GPU | Lenovo Legion Tower 7i Gen 10 | RTX 5080(16GB) | Core Ultra 7 265K/32GB/1TB/850W | 633,565円から(RTX 5080・32GBを選択) | 公式ページを見る |
| 27〜32Bを高い精度で・学習も | HP OMEN MAX 45L パラマウント  | RTX 5090(32GB) | Ryzen 9 9950X3D/32GB/2TB/1200W | 1,298,000円(欠品中・再入荷未定) | HP公式を見る |
| 27〜32Bを高い精度で・学習も | マウス G TUNE FG-A9G90 | RTX 5090(32GB) | Ryzen 9 9900X/64GB/2TB/1200W | 1,359,800円から | 公式ページを見る |
手元で答えてもらう:16GBならgpt-oss-20bと27BのQ3まで(推論)
目的がローカルでの推論なら、基準は動かしたいモデルを16GBの作業台に全部広げられるかです。
当サイトのRTX 5070 Tiでは、gpt-oss-20bが225.76 tok/s、Qwen3.8-27BのUD-Q3_K_XLが53.15 tok/sでした(第⑧節)。
RTX 5060 Tiは同じ16GBでも通路の幅(帯域)が約半分なので、生成速度は下がる見込みですが、同じモデルを全載せできます。
既存PCへRTX 5060 Ti 16GBを約12万円から追加するなら、次の条件を確認します。
- 750W以上の電源
- GPUが入るケース
- 32GB RAM
- 1TB NVMe
学習は9B以下のLoRAと12〜14B QLoRAを中心にし、推論では次の3つを試す構成です。
- Gemma 4 12B
- gpt-oss-20b
- Qwen3.8-27BのQ3
交換前に確認する項目は次の通りです。
- 補助電源
- カード長
- スロット幅
- ケース内の風の通り道
不足する部品も買い足すと、BTOとの価格差が縮まります。
電源やケースまで含めた総額で比べます。
元のPCを残せる人には、環境を小さく始めやすい方法です。
グラフィックボードとメモリの現在価格は、Amazonなどで確認できます。
PCごと買うなら、7選でいちばん安いのはマウスのG TUNE DG-A7G6Tです。
GPUはRTX 5060 Ti 16GB、CPUはRyzen 7 5700Xです。
メモリ32GB・SSD 1TB・750W電源の構成で、価格は384,800円からです(2026年10月4日時点)。
この記事で基準にした机・本棚・電源をそのまま満たすので、部品を足さずに推論を試し、そのあと学習へ進むかを決められます。
自分用に練習させる:12〜14Bまでは16GBの作業台で足りる(追加学習)
目的が追加学習なら、基準は練習させたい百科事典の厚さ(モデルの規模)です。
公開資料の目安では12〜14BのQLoRAが約14GBで、16GBの枠に収まります。
当サイトの16GB機での学習は10月13日に試運転して可否を確かめ、結果を第⑧節へ追記します。
初めてデスクトップを用意するなら、16GB GPU、RAM 32GB、NVMe 1TB、750W以上の電源を一式で選べるBTOが候補です。
7選の1〜3番目はどれもRTX 5070 Ti・32GB・850W電源で、2026年10月4日時点の価格は約43万〜49万円に並びます。
同じGPUなら、SSD容量(HPは2TB)や、この記事の計測に使った機種(FRONTIER)かどうかで選ぶと迷いにくくなります。
Legion Tower 5 30AGB10は、CPUがAMDのRyzen 7 7700Xである点がほかの2台と違います。
価格・在庫は購入画面で確認
組み立て時間を減らし、保証窓口を一つにしたい人に合う買い方です。
16GBという作業台の広さは同じでも、RTX 5060 Tiの448GB/sとRTX 5070 Tiの896GB/sでは通路の幅(帯域)が違います。
7選の5番目のLegion Tower 7i Gen 10(RTX 5080)もVRAMは16GBで、学習できるモデルの規模の目安はRTX 5070 Tiと変わりません。
価格・在庫は購入画面で確認
FRGKB860M/CG3では、届いてから生成AIに手順を聞きながら推論環境を整え、約3時間で最初のモデルが動きました。
配布されているモデルは量子化違いのファイルまで含めると種類が多く、どれを選ぶかで間違えそうになる場面もありました。
完成品のBTOなら部品の相性を気にせずに済むため、準備の時間はソフトとモデル選びだけに使えます。
27〜32Bを縮小しすぎない版で動かし、練習もさせる:RTX 5090の32GB
厚い百科事典に練習までさせるには、本と練習ノートを並べるだけの広い作業台が要ります。
Qwen3.8-27Bや27〜32B denseモデルをQLoRAで学習するなら、約22〜28GBを目安に、24GB以上の構成を検討します。
24GBは設定を調整する入口、32GBは同じ規模で余白を取りやすい帯、48GBはQwen3.8-27Bの公開目安で余裕を持たせる構成です。
今回調べたHP・マウス・レノボのデスクトップで24GB以上を選ぶと、2026年10月4日時点ではRTX 5090(32GB)の構成になります。
HP OMEN MAX 45Lが1,298,000円、マウスのG TUNE FG-A9G90が1,359,800円からで、16GB帯の約3倍の価格です。
HP OMEN MAX 45Lは、10月4日時点で公式ページに「欠品中(再入荷未定)」と表示されています。
レノボの公式サイトでは、RTX 5090を選べるデスクトップは見当たりませんでした。
中古RTX 3090は約18万〜24万円で売られていますが、在庫が少ないため購入リンクは置きません。
保証や電源を含む完成品を選ぶ人は、販売中の24GB以上構成を比較します。
27Bの学習を毎日行わないなら、16GB BTOと、使った時間だけ料金を払うクラウドGPUを組み合わせる案も残ります。
⑧ 16GBの作業台で実際に測った結果(RTX 5070 Ti:推論速度・回答品質・追加計測)
- 本が作業台に全部載るかどうかで、書く速さが大きく変わる
- 答えの正しさは、計算・条件の読み取り・決められた形で返す課題で差が出た
- はみ出すQ4_K_Mも、GPUに置く層数を決めると26.6〜33.0 tok/sまで戻る
- 練習(学習)は10月13日に試運転して、できるかどうかを判断する
この節は、16GBの作業台にいろいろな百科事典を広げ、書く速さと答えの正しさを実際に測った記録です。
計測機はFRONTIER FRGKB860M/CG3で、GPUはRTX 5070 Ti 16GB、帯域896GB/s。
9月3日にllama-benchで推論速度を、9月8日に固定課題で回答品質を測り、9月29日〜10月1日にはQwen3.8-27Bの量子化・長い文脈・GPUに置く層数・アプリの違いを追加で測りました。
学習(QLoRA)は10月13日に試運転する予定で、何を測るかを末尾にまとめています。
書く速さ:10本のGGUFを、渡す資料の長さ(深さ)0/8K/32Kで測った(推論速度)
- llama-bench b10752(CUDA)、pp512/tg128、各3回の中央値
- 文脈の深さ 0/8192/32768トークン、全層GPU指定(-ngl 99)、Flash Attention有効
- VRAM峰・電力はnvidia-smiの1秒サンプルの最大値。VRAMはデスクトップ表示を含むGPU全体の使用量
- ドライバ616.56、コンテキストは深さ+生成分、モデルはLM Studioで配布されたGGUF
この表の見方:「生成 tok/s」は1秒に書ける文字のかたまりの数、「処理 pp512」は渡した文章を読む速さで、どちらも大きいほど待ち時間が短くなります。
「深さ0」は短い質問だけ、「32K」は論文1本くらいの資料を読ませたあとの値で、たとえばgpt-oss-20bなら225.76から181.01へ下がった、と読みます。
| モデル | 量子化 | 本体 (GiB) | 生成 tok/s 深さ0 | 生成 tok/s 32K | 処理 pp512 深さ0 | VRAM峰 32K |
| Qwen3.5 4B | Q4_K_M | 2.52 | 197.37 | 155.82 | 8,809.66 | 5.02GB |
| Qwen3.5 4B | Q8_0 | 4.17 | 144.50 | 119.73 | 9,302.80 | 6.70GB |
| Qwen3.5 9B | Q4_K_M | 5.24 | 128.78 | 110.43 | 5,608.63 | 7.19GB |
| Qwen3.5 9B | Q8_0 | 8.87 | 86.23 | 77.13 | 6,158.17 | 10.38GB |
| Gemma 4 12B | QAT Q4_0 | 6.50 | 95.85 | 87.05 | 5,053.62 | 8.91GB |
| Gemma 4 12B | Q8_0 | 11.80 | 58.25 | 54.63 | 4,776.96 | 14.23GB |
| gpt-oss-20b | MXFP4 | 11.28 | 225.76 | 181.01 | 10,375.60 | 12.92GB |
| Gemma 4 26B-A4B | QAT Q4_0 | 13.45 | 193.83 | 158.39 | 7,061.17 | 15.50GB |
| Qwen3.8-27B | UD-Q3_K_XL | 12.24 | 53.15 | 47.07 | 1,873.78 | 15.05GB |
| Qwen3.8-27B(全層GPU指定・はみ出し) | Q4_K_M | 15.66 | 7.09 | 4.34 | 75.66 | 15.47GB |
| Qwen3.8-27B(自動fit・部分オフロード) | Q4_K_M | 15.66 | 21.86 | 6.80 | 1,168.02 | 別計測なし |
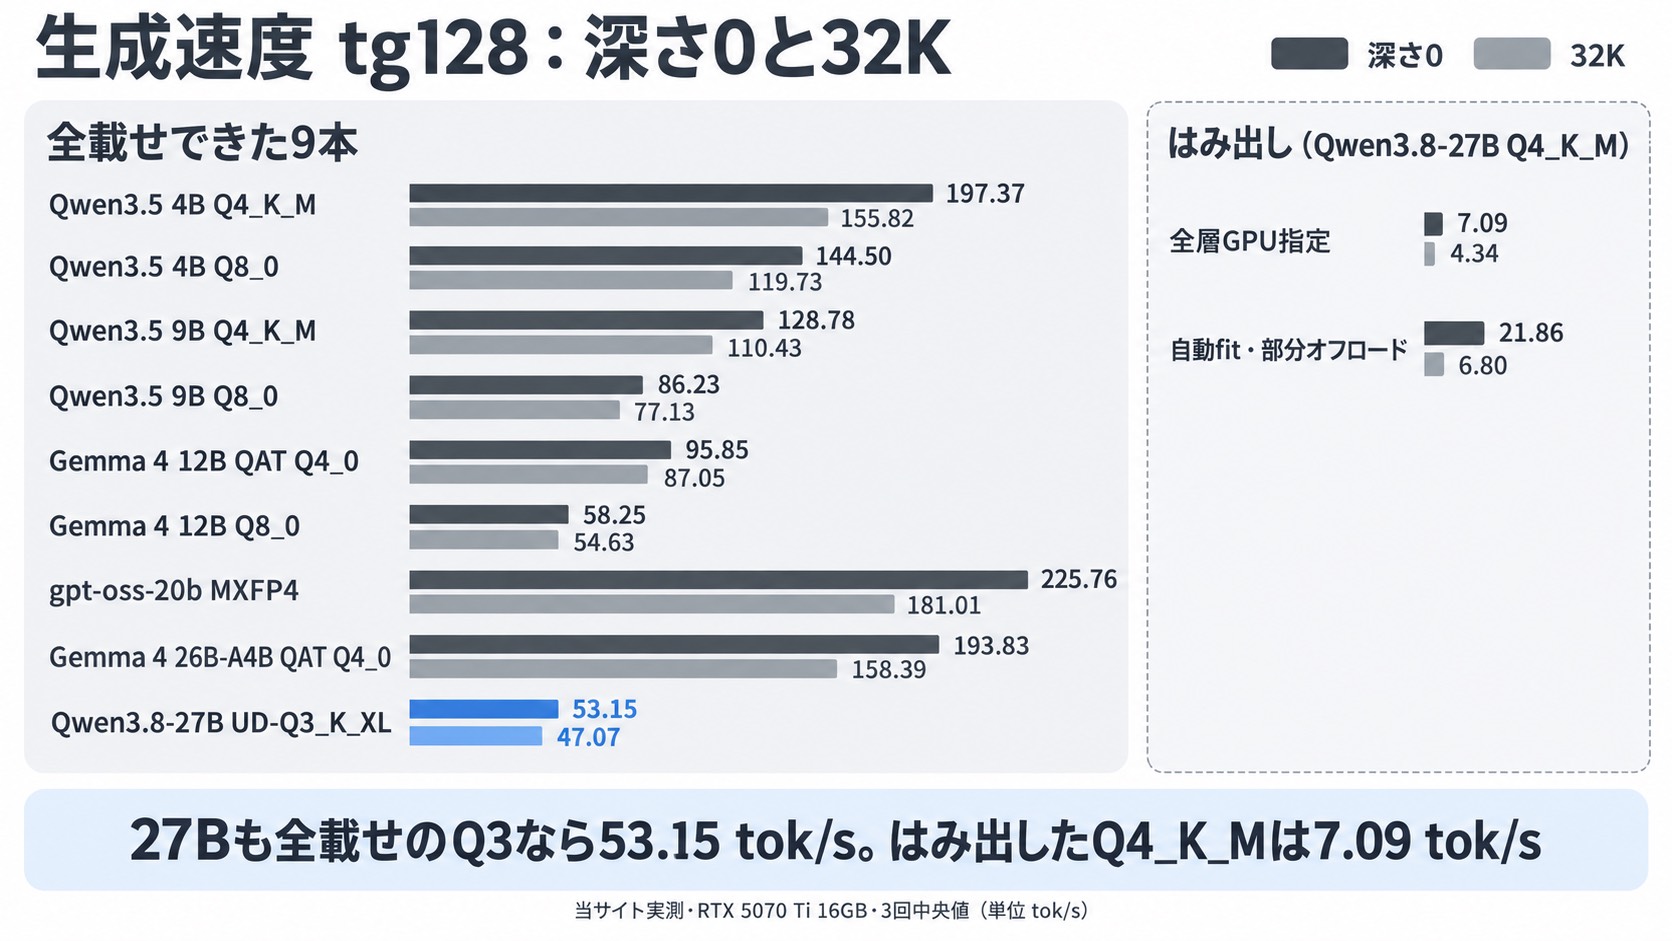
この表で最初に見てほしいのは、Qwen3.8-27B Q4_K_Mの2行です。
全層GPU指定では読み込みエラーが出ないまま生成7.09 tok/s、32Kでは4.34 tok/sまで落ち、GPU電力は85〜101Wにとどまりました(全載せできた9本は201〜304W)。
VRAMから溢れた分がメインメモリへ退避し、作業台に載らないページを机まで取りに行くあいだ、GPUが待つ時間が増えた状態です。
最初、exit codeが0だったので成功と見なしかけましたが、電力とtok/sの急落で溢れていると気づきました。
同じQ4_K_Mを自動fit(作業台に置けるだけ置き、残りを机に回す部分オフロード)で読み込み直すと、深さ0で21.86 tok/s、8Kで16.01 tok/s、32Kで6.80 tok/sでした。
全66層のうちGPUに載ったのは深さ0で59層、32Kでは50層。
短い文章なら動きますが、長文脈になるほど会話メモが作業台を取り、CPU側へ回る層が増えて、UD-Q3_K_XLの全載せとは別物の速度になります。
UD-Q3_K_XLは12.24GiBの本体が全層GPUに載り、深さ0で53.15 tok/s、32Kでも47.07 tok/sを保ちました。
VRAM峰は深さ0の13.23GBから32Kの15.05GBまで、会話メモの分として1.82GB増えましたが、16GBの作業台の中に収まっています。
MoE(分野ごとの専門家の分冊に分かれた百科事典)は、1トークン書くたびに必要な分冊だけを開くので、全体が大きくても速く書けます。
MoEの速さも数字で確かめられました。
gpt-oss-20b(21B MoE・3.6B活性)は225.76 tok/sで、密モデルのQwen3.5 4B Q4_K_M 197.37 tok/sより速い結果です。
Gemma 4 26B-A4Bも193.83 tok/sで4B並みに動きますが、32KではVRAM峰15.50GBで空きが約0.4GBしかなく、画像入力や別アプリを足す余白は残っていません。
論文1本くらいの32Kの深さでは、全載せできた9本すべてで速度が下がり、生成は6〜21%、処理(pp512)は33〜49%の低下でした。
Gemma 4 12B Q8_0は58.25から54.63 tok/sで6%減、Gemma 4 26B-A4Bの処理は7,061から3,576で49%減。
長文を貼って要約させる用途では、生成より処理側の落ち込みが待ち時間に効きます。
10月1日の追加計測で分かったこと(Qwen3.8-27B)
9月29日〜10月1日に、Qwen3.8-27Bだけを対象に量子化・KVキャッシュ・GPUに置く層数・アプリを変えて測り直しました。
UD-Q3_K_XLを9月3日と同じ条件で測り直した値は、差が3%以内に収まりました。
推論速度の表は、元の計測値を残しています。
PC選びに関わる結果は次の4点です。
- IQ4_XSとUD-Q3_K_XLの生成速度はほぼ同じ(深さ0で50.07対52.50 tok/s)。VRAMはIQ4_XSが約1.1GB多い
- KVキャッシュ(会話メモ)をq4_0に量子化して短く書くと、UD-Q3_K_XLは128K(本1冊分くらい)の深さでも全層GPUのまま29.28 tok/s
- Q4_K_MはGPUに置く層数を62に指定すると26.6 tok/s、64に指定すると33.0 tok/s(全層指定は6.85 tok/s)。64層ではVRAMの余裕が約0.4GBしかないため、安定させるなら62層を選ぶ
- LM Studioは既定のGPU割り当てで13.8 tok/s(一部の層がCPU側)。GPUの割り当てを最大にすると、llama.cpp・LM Studio・Ollamaとも49〜52 tok/s
16GBで27Bを常用するなら、全層GPUのまま長い文脈まで扱えるUD-Q3_K_XLが本命です。
短い会話が中心ならIQ4_XSも候補で、自作20課題の厳密正答はIQ4_XSが16/20、UD-Q3_K_XLが13/20でした。
1課題1回の小さなテストで、IQ4_XSだけ課題の送り方も違います。
回答品質の優劣までは断定しません。
KVキャッシュの型ごとに全層GPUで測れた深さ、層数と速度の関係、MTP(次に言う数語を先に用意しておく先読み)やThinkingの段階まで含めた詳しい結果はQwen3.8-27Bの16GB実測にまとめています。
答えの正しさ:ローカル10本と参考のクラウドに同じ課題を出した(回答品質)
- 基本20課題(計算3・条件判断3・情報抽出3・不明/矛盾2・引用内の命令2・長文読解2・要約1・文章修正1・文章作成1・コード2)を各1回
- LM Studio 0.4.23、コンテキスト8192、temperature 0、最大出力2048、System Prompt指定なし、Thinkingはoff(gpt-ossはlow)
- Thinkingの効果は同じ6課題をon(gpt-ossはhigh)で再測定。初回は最大出力2048、回答が出なければ4096で追試
- ※Qwen3.5 9B Q8はLM Studioの量子化指定が失敗したためllama.cpp b10752で実行
- †クラウドはCodex CLI経由のGPT-6 Astra(基本はreasoning low、Thinkingはhigh)。同じ問題文でもシステム指示・生成上限・温度の設定方法が違う参考値
この表の見方:「内容正解」は答えの中身が合っていた数、「要件達成」は「JSONだけ返す」のような形の指定まで守れた数で、どちらも20問中の数です。
右の2列はThinking(答える前に下書きして考えるモード)をオンにしたときの変化で、たとえばgpt-oss-20bは同じ6問で5/6から6/6に上がりました。
| モデル | 内容正解 /20 | 要件達成 /20 | 同じ6問 基本→Thinking | Thinking完了時間の中央値 |
| Qwen3.5 4B Q4 | 14 | 13 | 3/6→4/6 | 9.51秒 |
| Qwen3.5 4B Q8 | 13 | 13 | 2/6→4/6 | 15.65秒 |
| Qwen3.5 9B Q4 | 15 | 15 | 3/6→4/6 | 13.99秒 |
| Qwen3.5 9B Q8 ※ | 15 | 15 | 3/6→3/6 | 18.14秒 |
| Gemma 4 12B QAT Q4 | 15 | 11 | 2/6→5/6 | 7.25秒 |
| Gemma 4 12B Q8 | 15 | 12 | 2/6→5/6 | 35.99秒 |
| gpt-oss-20b | 17 | 17 | 5/6→6/6 | 5.17秒 |
| Gemma 4 26B-A4B QAT Q4 | 15 | 13 | 3/6→4/6 | 38.05秒 |
| Qwen3.8-27B UD-Q3 | 16 | 13 | 2/6→6/6 | 26.49秒 |
| Qwen3.8-27B Q4_K_M | 16 | 15 | 3/6→6/6 | 26.66秒 |
| 参考:クラウド GPT-6 Astra † | 20 | 20 | 6/6→6/6 | 6.51秒 |
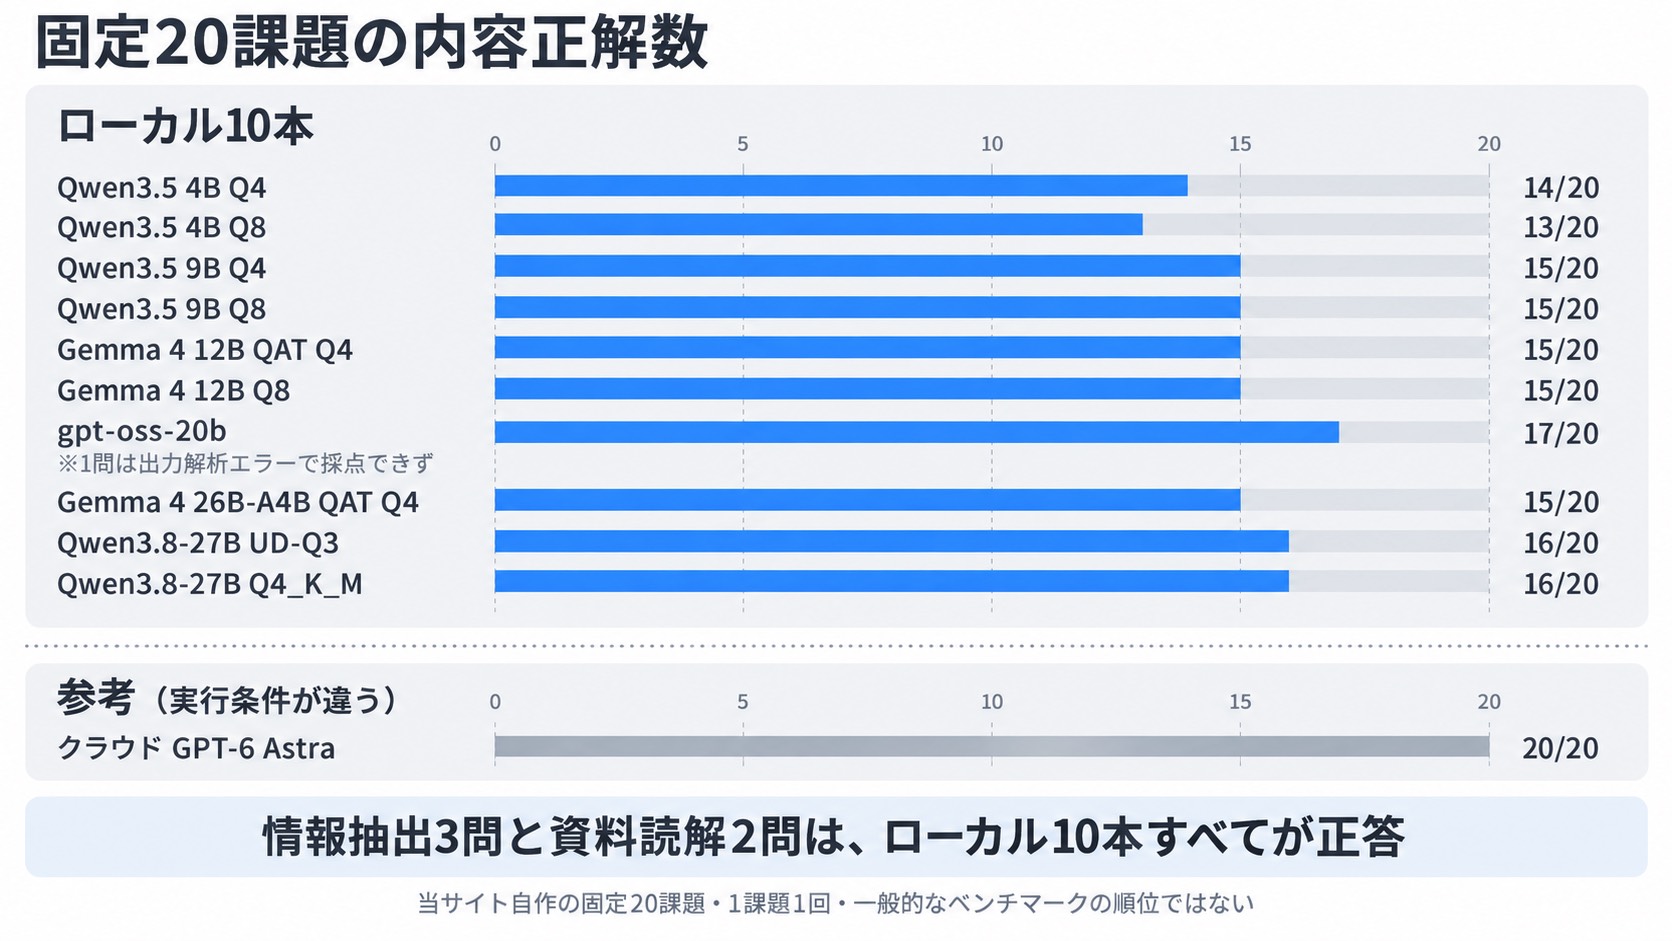
ローカル10本すべてが、情報抽出3問と資料読解2問の内容に正答しました。
資料から値を取り出す、社内文書を読んで答えるという用途なら、4Bでも実務の入口に立てます。
差が出たのは計算、条件判断、そして「JSONだけ返す」「100字以内」といった形式指定です。
Gemma 4の3本は抽出した値が正しくてもMarkdownのコード囲みを付け、要件達成の点数を落としました。
Thinkingを有効にすると、Qwen3.8-27Bの2本は同じ6問で6/6に届きました。
代わりに完了時間の中央値は約2秒から約26秒へ伸び、下書きに時間を使う分だけ返事が遅れます。
小型モデルでは考える文章だけで出力上限に達し、最終回答が出ない試行もありました。
16GB機で27Bを使うなら、事務作業は基本設定、計算や条件判断はThinkingと使い分けます。
基本設定で最も点を取ったのはgpt-oss-20bの17/20で、速度でも最速だったモデルです。
ただし20問中1問は実行系の出力解析エラーで採点できず、未達成分をすべて誤答とは数えていません。
クラウドの20/20は参考値で、実行条件が違うためモデル自体の性能差だけとは断定しません。
小さな発見もありました。
「RTX 5070 TiのVRAM容量を、知らないならnullで答えて」という課題で、16GBと答えたのはQwen3.8-27B Q4_K_Mとクラウドだけ。
ほかの9本は正直にnullを返しました。
GPUの上で動くことと、そのGPUの仕様を知っていることは別だと、5070 Tiの上のAIに教えられた形です。
回答品質のテストからは「どの仕事で正解し、どこで手直しが要るか」を回答例つきで言えますが、全分野の優劣や長期的な成功率は言えません。
課題・採点基準・応答全文は当サイト側で保存し、追加学習やRAGはまだ入れていない素の性能です。
練習(QLoRA学習)は10月13日に試運転する
- Unsloth+QLoRA、r=16/lr=2e-4/seed=3407
- 教材は当サイトの記事(書き方を覚えさせる文体の学習)
- 必要VRAM、完走時間、OOMが出た設定と変更点、学習前後の文章の違いを記録
学習はUnslothとQLoRAで、設定(r=16、学習率2e-4、seed 3407)を固定し、当サイトの記事の書き方を覚えさせる学習だけに絞りました。
物知りの人に、当サイトの文体で書く練習をしてもらうイメージです。
10月13日の試運転で、16GB機で学習を完走できるか判定します。
完走できなければ、その時点で学習の計測はやめます。
完走できた場合は10月中旬に本番の学習を回し、必要VRAM、完走時間、学習前後の文章の違いをこの節に追記します。
OOM(メモリ不足のエラー)が起きた設定も結果に含め、文脈やbatchをどう変えたかまで記録します。
推論の速度表と回答品質の表は、公開資料の値とは分けて載せました。
この記事の第⑧節以外にある1〜5 tok/sや325 tok/sは外部公開資料の値で、当サイトの機材で得た数字ではありません。
⑨ 買う前に借りて試すと、自分に要る作業台の広さが見える
- 高いPCほど、買う前に試す価値がある
- 自分の使うモデルと教材で、どこまでできるかを確かめる
- 借りるなら、返す日や条件まで先に確かめておく
家を買う前に内見するように、30万円を超えるPCほど、購入前に自分のモデルと教材を動かす価値があります。
PCのレンタルなら、推論に加えて電源、冷却、保存容量まで、買う前に確かめられます。
使った時間だけ払うクラウドGPUでも、自分のモデルが動くかや練習が通るかは試せます。
借りて試せば、16GBで足りる人は購入候補を固め、24GBが必要な人は16GB機を買う前に方向を変えられます。
学習(QLoRA)まで考えているなら、推論だけで決めず、練習が最後まで通るかも試しておくと安心です。
PCを借りて試すなら、試す時間を減らさないために、次の条件を先に確認します。
- 到着日
- 返却日
- 延長条件
- 初期化方法
⑩ 2026年10月は、作業台の広さを決めてから買い時を考える
- 値段の動きより先に、要る作業台の広さを決める
- 使う回数に合わせて、買うかクラウドで借りるかを選ぶ
- 大きな台の機種は、通路の幅(帯域)と使えるソフトも確かめる
2026年9月28日に価格を確認した時点では、メモリの部品(DRAM)の高騰と、広い作業台を持つ大容量GPUの値上がりが重なっていました。
RTX 5090は価格.comでいちばん安い価格が7月の約70万円から9月28日時点で約100万円まで上がり、中古RTX 3090も約18万〜24万円です。
価格だけを見ると待ちたくなりますが、必要なVRAMが16GBで足りる人と70Bを扱う人では待つ理由が違います。
16GBで9B・12B級の学習と20B/27B級の推論を始めたい人は、現在の16GBカードとクラウドの二段構えが候補です。
27B QLoRAを毎日回す人は24GB以上の在庫と価格を比べます。
70B〜120B級をローカルで動かしたい人は、128GB統合メモリ機の通路の幅(帯域)と実行環境まで確認し、購入を待つか決めます。
Mac Studioは2026年9月28日時点でM5 MaxとM5 Ultraが選べ、M5 Ultraは最大512GBの統合メモリを積めます。
NVIDIAのRTX SparkはCUDAと128GB統合メモリを持つ薄型ノートとして2026年秋を予定しています。
大容量を持ち歩く用途なら秋の選択肢を見てからでも遅くなく、16GBデスクトップで始める用途なら第⑧節の実測を見て構成を絞れます。
買い時を日付だけで決めず、次の順に整理します。
- 推論モデル
- 学習方式
- 必要VRAM
- 利用頻度
急いで32GBを買うより、16GBの作業台で足りない処理が何時間あるかを見積もるほうが判断材料になります。
128GB統合メモリ機を比べたい人は、RTX Spark・Mac M5 Max・RTX 5090の比較記事で帯域と価格の違いを整理しています。
RTX 5090機の130万円やRTX 5070 Ti機の45万円を分割にすると月いくらか、メーカー別の手数料0%回数と合わせて試算しています。
パソコンの分割払いはどこが得?メーカー別の手数料0%回数と月々の支払い早見表
⑪ まとめ
まず、どの百科事典を広げたいか、練習までさせたいかを決め、その広さの作業台を選ぶのが近道です。
推論は量子化後の重みとKVキャッシュ、学習は方式とモデル規模から必要VRAMを出します。
16GBは27BのQ3推論と9B以下のLoRA・12〜14BのQLoRA、27B QLoRAは24GB以上です。
16GBで27Bを動かすならUD-Q3_K_XLが本命で、Q4_K_MはGPUに置く層数を指定して使います。
手元の作業台を超える処理だけクラウドへ分けると、初期費用を抑えられます。
⑫ よくある質問
ローカルLLMに必要なVRAMは最低どれくらい?
最低8GBが入口です。
小さな作業台でも、Qwen3.5 4BやSarashina 2.2 3Bのような薄い百科事典なら推論でき、7〜9BのQLoRA約8GBも候補になります。
12B級や長い文脈まで扱うなら余白が小さいため、16GBへ上げるとモデルと量子化の選択肢を増やせます。
初めて触るなら、小型モデルで手順を確かめてから容量を広げます。
GPUなし(CPUだけ)でもローカルLLMは動く?
動かせるソフトはありますが、速さは期待しにくい構成です。
作業台を使わず机の上だけで作業するようなもので、書く手(CPU)もGPUほど速くありません。
公開資料には、モデルの重みがVRAMに収まらずメインメモリ側へ回る構成で、生成が1〜5 tok/sまで落ちる例があります。
当サイトのRTX 5070 Tiでも、全層GPU指定でVRAMからはみ出したQwen3.8-27B Q4_K_Mは7.09 tok/sでした。
専用のGPUを持っていないなら、16GBの無料Colab T4で手順を試すか、CPUとGPUが同じメモリを使うMacやRyzen AI MAX+の統合メモリ機を候補にします。
当サイトはGPUなしの構成を計測していません。
VRAM 16GBでQwen3.8-27Bは動く?
答えてもらう推論なら動かせます。
Q4_K_Mは本体15.66GiBで16GB VRAMからはみ出し、もう一段薄く縮小したUD-Q3_K_XLは12.24GiBで全載せできます。
当サイトのRTX 5070 Ti実測では、UD-Q3_K_XLが深さ0で53.15 tok/s、32Kでも47.07 tok/sでした。
Q4_K_Mは全層GPU指定だと7.09 tok/sに落ちますが、GPUに置く層数を62〜64に指定して一部をCPUに回すと26.6〜33.0 tok/sで動きます。
16GBで常用するならUD-Q3_K_XLが本命で、短い会話が中心ならIQ4_XSも候補です。
Q3推論と27B QLoRA学習は別で、練習させる学習には約22〜28GB、24GB以上が目安です。
量子化ごとの詳しい比較はQwen3.8-27Bの16GB実測にあります。
ファインチューニングは16GBのGPUでもできる?
できます。
16GBの作業台なら、9B以下のLoRAと12〜14BのQLoRA約14GBが候補ですが、モデル固有値と文脈長で変わります。
Qwen3.5 9BのLoRA(bf16)は公開目安22GBなので、縮小コピーに付せんを貼るQLoRAも比較し、27B QLoRAは24GB以上へ分けます。
グラフィックボード2枚挿しでVRAMは合算できる?
自動では一つのVRAMになりません。
作業台を2台並べても、本を2台にまたがって広げる段取りがなければ、1台分の広さのままです。
llama.cpp、vLLM、SGLangなど、モデルや処理を複数GPUへ分割できるソフトと設定が必要です。
同じモデルを各GPUへ複製する処理では容量は増えないため、対応方式とGPU間通信を確認して構成を決めます。
MacやRyzen AI MAX+の統合メモリ機はどうか?
大きなモデルを載せる用途に合います。
作業台と机が1つの大きな台になったつくりで、Ryzen AI MAX+ 395は128GB中96GBまでGPUへ割り当て可能、Mac mini M5 Pro 48GBは通路の幅(帯域)が307GB/sです。
MacはMLX/MPS、AMDはROCm/Vulkanが中心で、CUDA向けの学習手順を同じまま使えない点も比較します。
Radeon(AMDのGPU)でも使える?
ROCmやVulkanに対応したソフトなら使えますが、手順はNVIDIAのGPUと同じにはなりません。
AMDのGPUではCUDAではなくROCmやVulkanを使い、Ryzen AI MAX+ 395のミニPCも同じくROCmやVulkanが中心です。
CUDA向けに書かれた学習手順は、そのまま移せない場合があります。
必要なVRAMを見積もる考え方はRadeonでも同じですが、当サイトはRadeonを計測していないため、速度の比較はできていません。
メインメモリ(RAM)は何GB必要?
32GB以上を基準にします。
机にあたるメインメモリでは、モデル管理、学習データ作成、ブラウザ、WSL2、オフロード時の作業領域を同時に使うためです。
RAMを増やしてもVRAM自体は増えませんが、16GB GPUと1TB NVMeを組み合わせるPC全体の余白になります。
長文脈や複数モデルを並べる場合は、さらに余白を取ります。
量子化はどれを選べばいい?
量子化は百科事典の縮小コピーで、薄いほど作業台に載せやすく、厚いほど細かい字がつぶれにくくなります。
VRAMに余裕があるなら、日本語の品質を取りやすいQ4_K_M以上、さらに余裕があればQ5/Q6が候補です。
16GBでQwen3.8-27Bを使う場合、当サイトの実測ではUD-Q3_K_XLが本命で、短い会話が中心ならIQ4_XSも候補でした。
Q4_K_Mは16GBだと全層GPU指定で7.09 tok/s、GPUに置く層数を62〜64に指定すると26.6〜33.0 tok/sです。
当サイトの固定20課題では、27BのQ3とQ4_K_Mは内容正解が16/20で並びました。
同じ質問を量子化違いで出力し、速度だけでなく敬語、固有名詞、長文の崩れも見て決めます。
社内文書や顧客データを学習させてもいい?
実在する顧客情報の学習利用は避けます。
モデルが内容を記憶し、意図しない入力で出力するリスクがあるためです。
物知りの人が、練習で読んだ文章を別の質問のときにうっかり話してしまうようなものです。
口調、分類、出力形式は個人情報を含まない合成データで学習し、更新される社内文書はアクセス制御したRAGから回答時に渡します。
原文を再学習せず差し替えられる点も、RAGへ分ける利点です。