ローカルLLMのファインチューニングは16GBでできる?RTX 5070 Tiで9Bに当サイトの文体を覚えさせた【QLoRA実測】
ローカルLLMに、自分たちのサイトで積み重ねてきた文章の書き方を覚えさせたいと考えたとき、最初に引っかかるのがGPUの大きさです。
ファインチューニング(AIに追加で練習させること)には大きなGPUが要るという話も多く、手元のゲーミングPCで足りるのか判断がつきません。
VRAM 16GBのRTX 5070 Tiで、9B(90億パラメーター)のQwen3.5に当サイトの記事の段落1,000件を練習させてみました。
結果は、練習が3分31秒で1周し、GPUのメモリは約13.9GBに収まっています。
答えを伏せた読み比べでは5本中4本で学習後のほうが当サイトらしいと判定され、話し方は寄った傾向が見えました。
ただし、学習後の文章には渡していない数字や数字の意味の取り違えが混ざったので、公開する前には人の確認が要ります。
- 作業台(VRAM)16GBのRTX 5070 Tiで、9BのQLoRA学習が1周(1,000件・125ステップ)。学習時間は3分31秒(211.3秒)
- 使ったVRAMはピーク13,868 MiB(約13.9GB)。教材の1問は平均178.7トークン・最大463トークンと短い
- 答えを伏せた読み比べ(5本・1人)で、4本は学習後のほうを当サイトらしいと選んだ
- 渡していない数字は学習前0件→学習後2件(自動チェック)。数字の意味の取り違えも2本で見つかった
- AI(LLM)=分厚い百科事典を持った物知りの人。9Bは百科事典の分厚さの目安
- VRAM(GPUのメモリ)=手元の作業台。今回は16GB
- 学習(ファインチューニング)=物知りの人に、当サイトの書き方で書く練習をしてもらうこと
- QLoRA=縮小コピーした百科事典(4bit)には手を入れず、付せん(アダプター・約58MB)に書き方のクセを書き足すやり方
- RAG=答えるたびに、最新の資料を手渡すやり方
- 損失(loss)=お手本の段落との食い違いの大きさ。確認用50件は、練習に使っていない小テスト
この記事は、FRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB・Core Ultra 7 265F・メモリ32GB)で、2026年10月4日に試運転、10月5日に本番の学習を当サイトが実測した記録をベースにしています。
学習はWindows 11 Pro上のWSL2(Windowsの中にLinux用の小部屋を用意する仕組み)に入れたUbuntu 24.04で行い、学習を軽くする道具のUnsloth 2026.8.22、transformers 5.5.0、torch 2.11.0+cu130を使いました。
GPUドライバは616.64で、細かい版と設定は記事の最後の計測条件にまとめています。
結論:16GBで9Bの練習は3分31秒で1周。話し方は寄ったが、数字は人が確かめる
- 9BのQLoRA学習は、VRAMピーク約13.9GBで再開なしに1周した
- 読み比べ(5本・1人)では4本で学習後を選び、話し方は当サイトに寄った傾向
- 学習後の文章に渡していない数字が2件。Gemma 4 12Bは読み込みで止まり未測定
物知りの人に、当サイトの記事の段落を1,000問ぶんお手本にして、書く練習をしてもらったと想像してください。
練習は数分で1周し、話し方は当サイトに近づいた一方、練習前は0件だった「渡していない数字」が2件出てきました。
結果を先に表でまとめます。
表の見方は、左の列が項目、まん中が当サイトの実測、右が条件と補足です。
| 項目 | 当サイト実測 | 条件・補足 |
| 学習時間 | 3分31秒(211.3秒) | 9B・QLoRA・1周(125ステップ)。読み込みの29.6秒は別 |
| VRAM | ピーク13,868 MiB(約13.9GB) | nvidia-smiの値。カードの容量は16,303 MiB |
| 教材 | 学習用1,000件・確認用50件 | 当サイトの公開記事の段落。1問は平均178.7トークン |
| 読み比べ | 5本中4本で学習後を選択 | どちらが学習後かを伏せ、当サイトの運営者1人で判定 |
| 渡していない数字 | 学習前0件→学習後2件 | 自動チェックの件数。見逃しあり |
| Gemma 4 12B | 未測定 | 学習用ライブラリが未対応で、読み込みの段階で停止 |
16GBで9Bの練習が通ったこと、話し方が寄った傾向が見えたこと、数字の正しさは別問題だったことの3点が、この記事の結論です。
続く節では、練習のしくみ、教材の作り方、VRAMと時間、読み比べ、学習後に出た誤りの順に見ていきます。
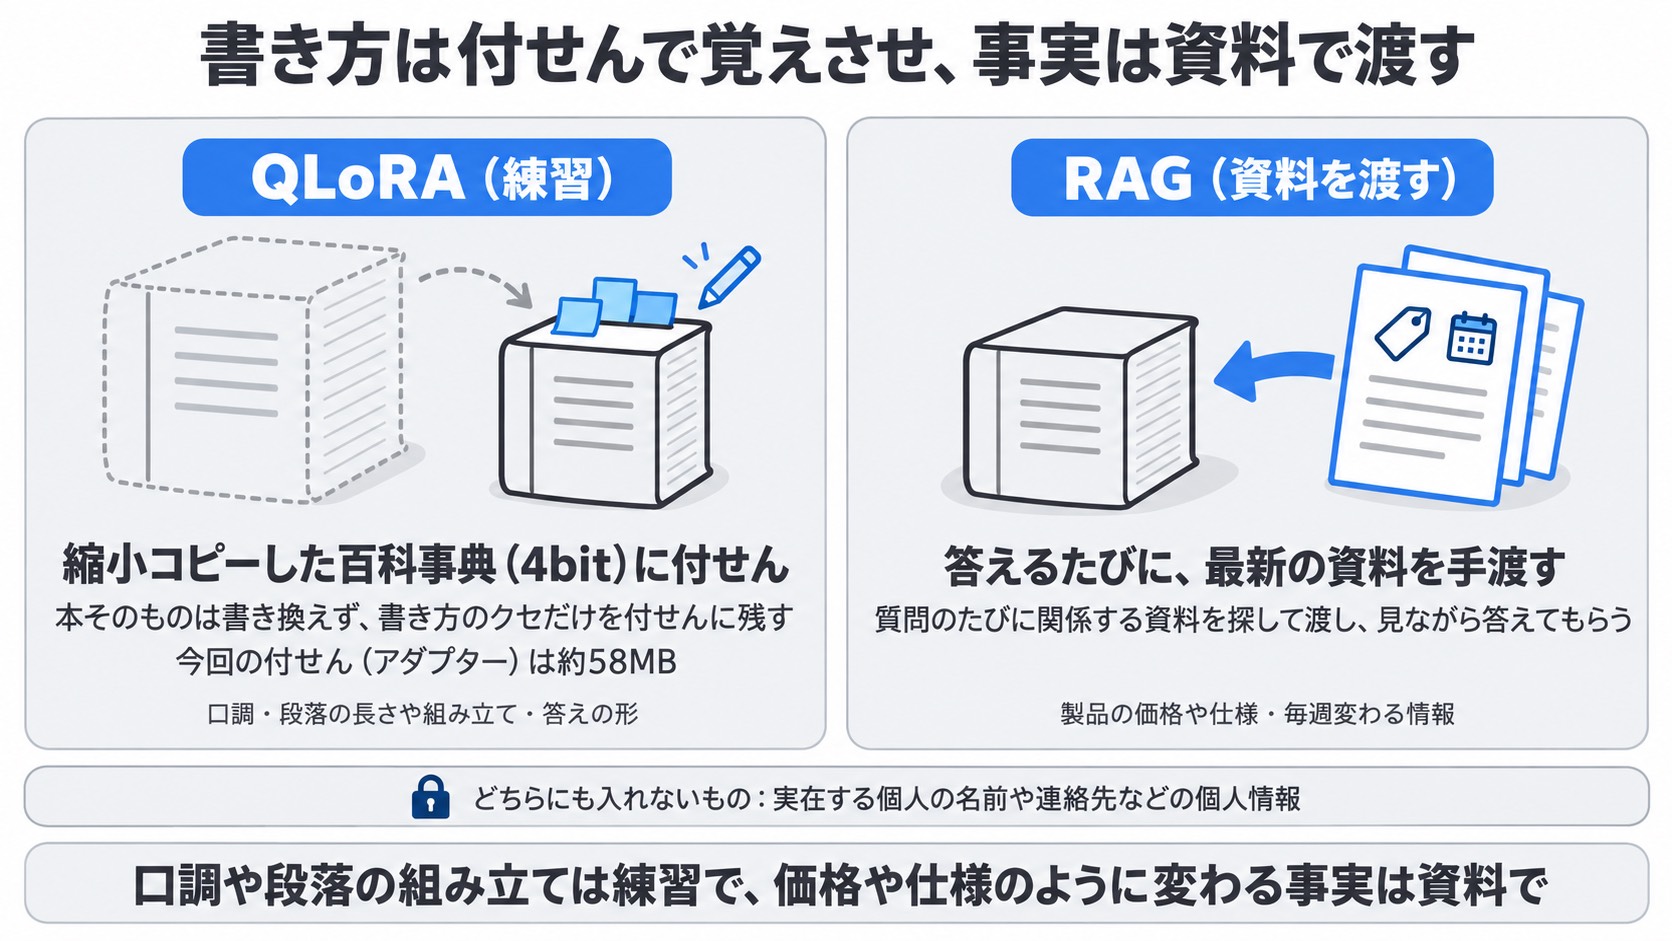
練習(学習)で変えられるのは話し方、知識は資料で渡す(RAGとの違い)
- 練習(ファインチューニング)で身につけさせたのは、当サイトの書き方という振る舞い
- 製品の数字のように変わる事実は、答えるたびに資料として渡す(RAG)ほうが向く
- QLoRAは、縮小コピーした本に付せんを貼る方式。今回の付せんは約58MB
新しく入った人に仕事を覚えてもらう場面を思い浮かべてください。
報告書の書き方は何度か練習すれば身につきますが、毎週変わる価格表は暗記してもらうより、必要なときに最新の表を手渡すほうが確実です。
ローカルLLMでも、書き方を覚えさせる方法と、資料を渡す方法を分けて考えます。
ファインチューニングとRAGの分担
ファインチューニングは、物知りの人に追加で練習してもらい、話し方や答えの形をそろえる方法です。
RAG(検索拡張生成)は、質問のたびに関係する資料を探して手渡し、その資料を見ながら答えてもらう方法です。
口調や段落の組み立ては練習で、価格や仕様のように変わる事実は資料で、という分け方は、ローカルLLMを動かすPCのスペックガイドの第⑤節で整理した考え方と同じです。
2つの方法に向くものを並べると、次のようになります。
- 練習(ファインチューニング)に向くもの:口調、段落の長さや組み立て、答えの形
- 資料(RAG)で渡すもの:製品の価格や仕様、毎週変わる情報、社内の最新の決まり
- どちらにも入れないもの:実在する個人の名前や連絡先などの個人情報
今回の教材でも、事実を覚えさせることは狙っていません。
1問ごとに「使う数字」を指示の中で渡し、モデルにはその数字を使って当サイトの書き方で段落を組み立てる練習をさせました。
学習後のモデルが製品の事実を覚えたかどうかは、今回の計測では確かめていません。
QLoRAとは:縮小コピーした本に付せんを貼る練習
練習のさせ方には、本そのものを書き直すやり方と、本に付せんを貼って書き足すやり方があります。
百科事典を丸ごと書き直すのがフルファインチューニング(フルFT)、本はそのままに付せん(アダプター)だけを書き足すのがLoRA、縮小コピーした本(4bit)に付せんを貼るのがQLoRAです。
付せんだけを書けばよいぶん作業台に広げる物が減り、16GBのカードでも練習を回せる見込みが立ちます。
ローカルLLMを動かすPCのスペックガイドで整理した公開資料の目安を、パラメーター数(B)あたりで並べます。
表の見方は、左から方式、たとえ、作業台(VRAM)の目安の順です。
| 方式 | たとえ | VRAMの目安(公開資料) |
| フルFT | 百科事典を丸ごと書き直す | 約12GB×B |
| LoRA(bf16) | 縮小しない本に付せん | 約2〜2.5GB×B |
| QLoRA(4bit) | 縮小コピーした本に付せん | 約0.7〜1GB×B |
スペックガイドで引いたUnsloth公式の目安では、9BのLoRA(bf16)は約22GBで、16GBのカードには収まりません。
今回はQLoRAを選び、練習の結果として残った付せん(アダプター)は約58MB(58,233,888 bytes)のファイルでした。
百科事典そのものは書き換えず、書き方のクセだけを薄い付せんに残した形です。
教材は当サイトの記事1,000段落
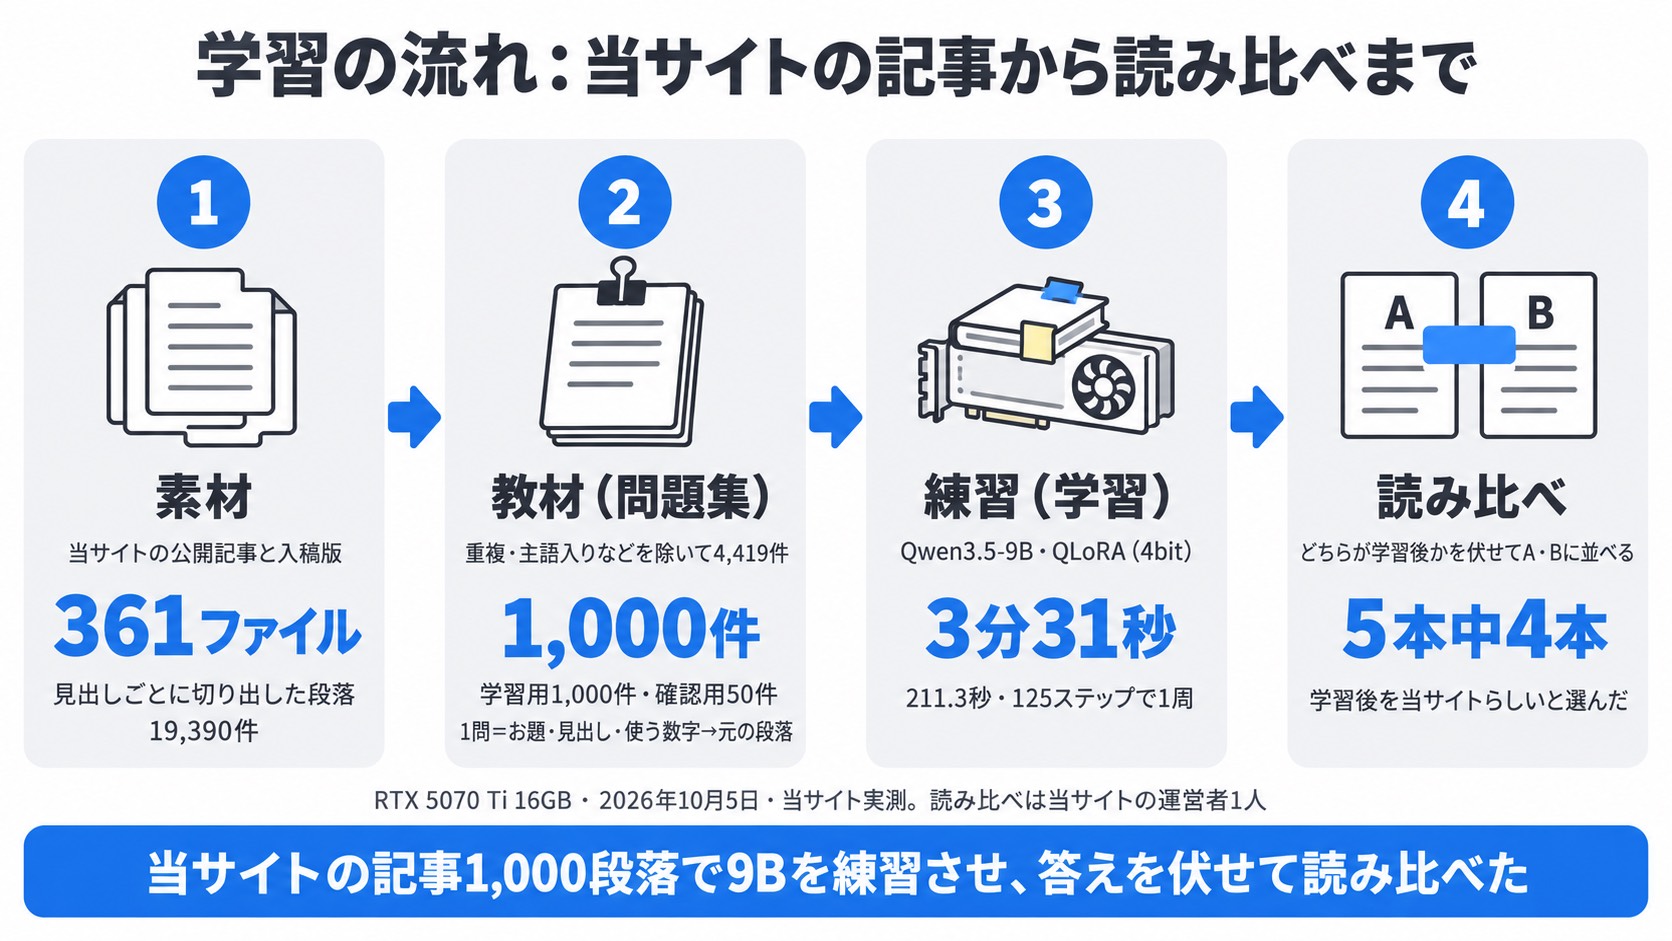
- 当サイトの公開記事・入稿版361ファイルから、見出しごとに段落を切り出した
- 1問は「お題・見出し・使う数字・目標字数」→「元の段落」の形
- 一人称の主語入り・セールの期限・クーポン案内・個人情報らしき文字列は外した
練習の質は、問題集の作り方で決まります。
今回の問題集は、当サイトで公開した記事の段落を答えにして、その段落を書くための指示を問題文にした1問1答です。
素材にしたのは、当サイトの公開記事と入稿版の本文361ファイルです。
見出しごとに切り出した段落19,390件から、重複を除いて4,825件、数字の漏れを除いて4,822件、一人称の主語が入った段落を除いて4,419件まで絞りました。
最後に、学習用1,000件と、練習に使わない確認用(小テスト)50件を抜き出しています。
1問の形:お題・見出し・使う数字 → 元の段落
1問は、問題文にあたる指示と、答えにあたる元の段落の組です。
実際の教材から1問を引くと、問題文は次の形をしています。
お題:Dell 14S(DS14260)
見出し:どの構成を選ぶべきか > プロセッサーは3つから選べる
使う数字:1/32GB
129字前後で、この見出しの本文を書いてください。
数字は与えられたものだけを使い、無い数字は書かないこと。
答えにあたるのは、「CPUを1段上げるだけのつもりでも、実際にはGPUとメモリまで動く構成変更になります。」で始まる当サイトの元の段落です。
段落に入っている数字はすべて「使う数字」に書き出し、無い数字は書かないよう指示しました。
数字を作らない振る舞いまで身につけてほしい、という狙いの設計です。
トークンは、AIが文章を読むときの文字のかたまりの単位です。
教材の1問は平均178.7トークン、最大でも463トークンで、学習用1,000件の合計は178,709トークンでした。
設定した上限の1,024トークンを超える問題は0件です。
外したもの:主語入り・期限・クーポン・個人情報らしき文字列
問題集に入れると困る段落は、先に取り除きました。
外した段落と件数は次のとおりです。
- 一人称の主語が入った段落:403件
- セールの期限が書かれた段落:223件
- 版違い・重複:14,157件
- 埋め残しの仮の文字(プレースホルダ):28件
- 当サイトのクーポン案内:135件
- 絵文字や記号の飾り:22件
PR表記、アフィリエイトリンク、表、箇条書き、構造化データ(JSON-LD)は、最初から素材に使っていません。
メールアドレスや電話番号らしき文字列を含む段落も除き、初稿や推敲の途中など、公開前の文章も入れていません。
素材は公開済みの記事なので、実在の個人情報は教材に入っていません。
教材にしたのは、当サイトが確認して公開してきた文章です。
一人の書き手のクセというより、サイトとして通してきた書き方を練習させたので、この記事では「当サイトの文体」と呼んでいます。
16GBで足りたか:VRAM約13.9GB・学習3分31秒
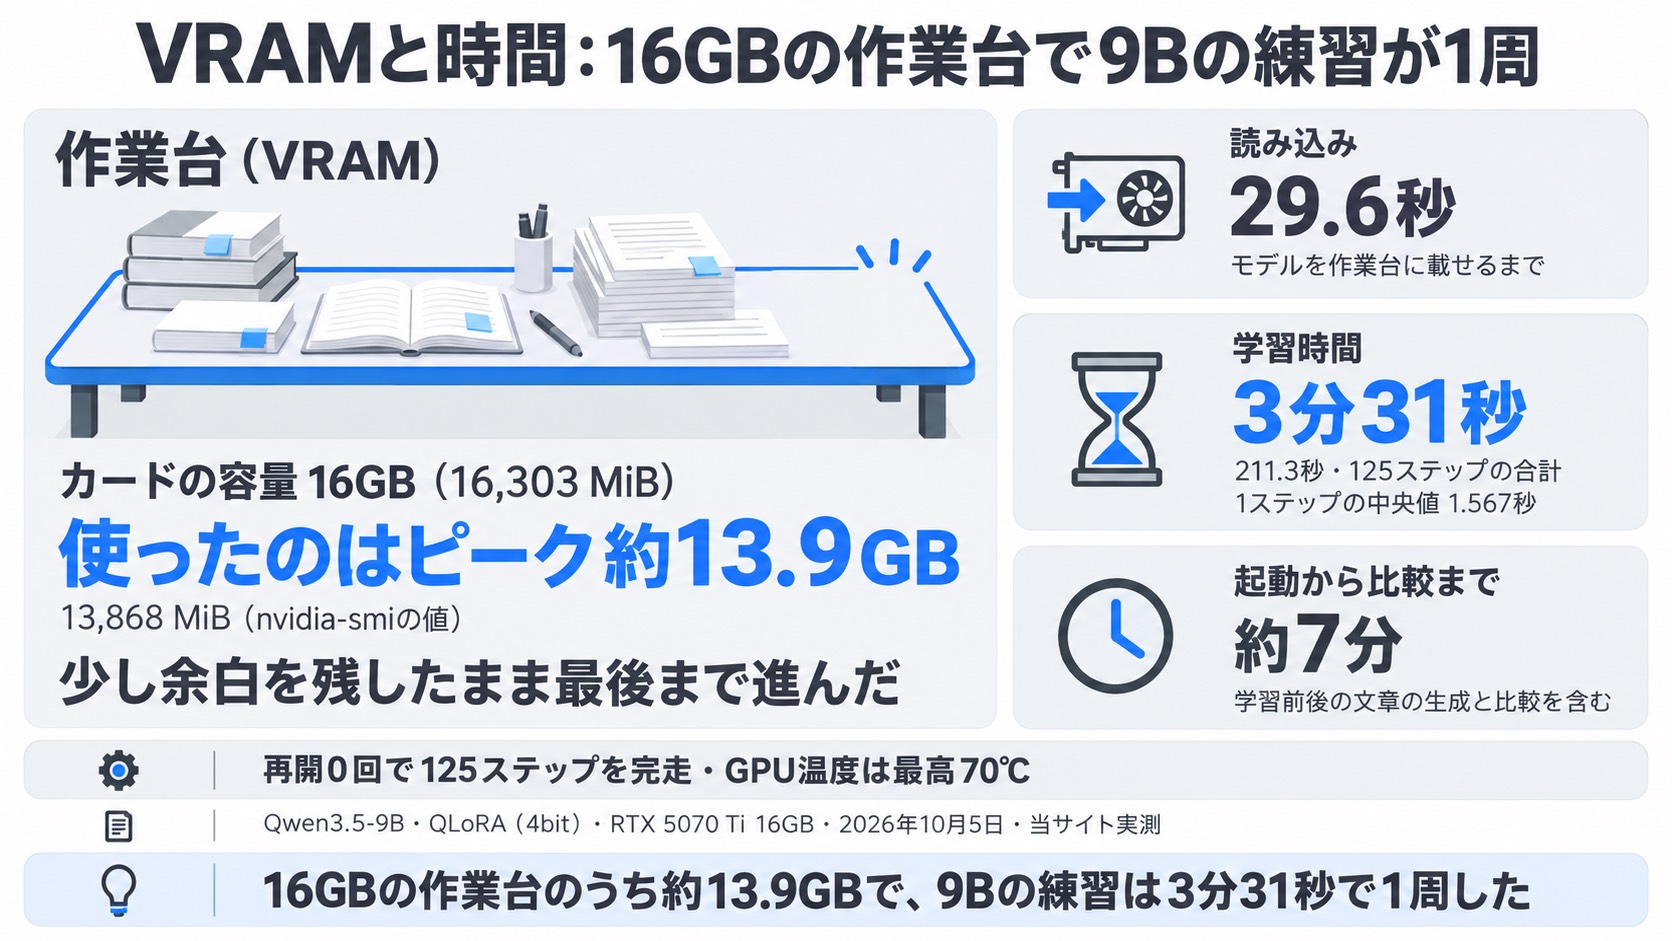
- VRAMのピークは13,868 MiB(約13.9GB)で、16GBの作業台に収まった
- 学習は211.3秒(3分31秒)。1ステップの中央値は1.567秒
- 再開0回で125ステップを完走。GPU温度は最高70℃
作業台の広さが足りるかどうかは、練習中にいちばん物を広げた瞬間で決まります。
今回の練習では、16GBの作業台のうち約13.9GBまで使い、少し余白を残したまま最後まで進みました。
1周(1 epoch)は、問題集の1,000問を1回ずつ解き終えることです。
今回は2問ずつ4回分をまとめて1ステップとしたので、1周は125ステップになります。
本番の数値は次の表のとおりです。
| 項目 | 当サイト実測 | 補足 |
| 方式 | QLoRA(4bit) | r16・alpha16・学習率2e-4・応答部分だけで損失を計算 |
| 教材 | 学習用1,000件・確認用50件 | 合計178,709トークン・最大463 |
| ステップ数 | 125ステップ(1周) | batch 2×累積4・max_seq 1024 |
| 読み込み | 29.6秒 | モデルを作業台に載せるまで |
| 学習時間 | 211.3秒(3分31秒) | 125ステップの合計 |
| 1ステップ | 中央値1.567秒・最大2.111秒 | 途中で極端に遅くなった区間なし |
| VRAM | ピーク13,868 MiB(約13.9GB) | nvidia-smiの値。torchの確保最大は13,034 MiB |
| GPUの電力 | 中央値 約270W・最大 約289W | 学習中 |
| GPU温度 | 最高70℃ | 学習ランの開始から終了まで(準備・確認用テスト・保存を含む) |
| 付せん(アダプター) | 約58MB | 58,233,888 bytes |
練習は途中で止まらず、再開0回で125ステップを走り切りました。
GPUの温度は最高70℃で、ファンの音や室温は記録していないため、この記事では扱いません。
夜間のつもりが、昼の約7分で終わった
実は、練習は夜につけっぱなしで回すつもりで計画していました。
10月3日の計画では10月14〜20日の夜間に2〜3回回す予定で、10月4日夜の試運転のあとも、本番1回で約33分と見込んでいました。
実際の本番は10月5日の昼に始まり、起動から学習前後の文章の生成と比較まで含めて約7分(11時24分16秒〜11時31分16秒)で終わりました。
試運転では9Bを10ステップだけ回し、VRAMのピークは12,119 MiB、1ステップの中央値は1.683秒でした。
9Bの最初の読み込みには1,414秒かかりましたが、初回のダウンロードを含んだ時間です。
小さい4Bも試運転で通し、VRAMのピークは7,787 MiBでした。
短い教材で1周させるだけなら、夜に回す前提で予定を組む必要は薄いと見ています。
最初のダウンロードだけは時間がかかるので、本番の前日までに済ませておくと当日の待ち時間を見積もりやすくなります。
教材が短いから軽く済んだ(最大463トークン)
練習が軽く済んだ理由のひとつは、1問の短さです。
1問は平均178.7トークン、最大463トークンで、設定上の上限(max_seq 1024)の半分にも届いていません。
作業台に広げる下書きの量は1問の長さで変わるため、長い記事を丸ごと1問にするような教材のVRAMと時間は、今回の値からは言えません。
練習の成績(損失)は下がったが、文章の良さの証明ではない
- 損失は、お手本の段落との食い違いの大きさ。練習用では2.5043→1.8011
- 練習に使っていない確認用50件でも2.645→1.752に下がった
- 下がったのはお手本の言い回しに近づいた目安で、良さと正しさは別に確かめた
損失(loss)は、書いた答えとお手本の段落がどれだけ食い違っているかを表す数字です。
テストでいえば減点の大きさに近く、数字が小さいほどお手本の言い回しに近づいたことを示します。
| 損失 | 練習の始め | 練習の終わり |
| 練習用(train) | 2.5043(最初5ステップの平均) | 1.8011(最後5ステップの平均) |
| 確認用50件(eval) | 2.645(学習前) | 1.752(学習後) |
確認用の50件は、練習に一度も使っていない小テストです。
小テストでも損失が下がり、練習に使っていない問題でもお手本の言い回しに近づいたと読める結果でした。
ただし、損失が下がったことは、文章が良くなった証拠にはなりません。
お手本の言い回しに近い形のまま、間違った数字を書くこともあるからです。
当サイトらしいかどうかは次の読み比べで、正しいかどうかはその次の節の数字の照合で確かめました。
答えを伏せた読み比べ:5本中4本で学習後を選んだ
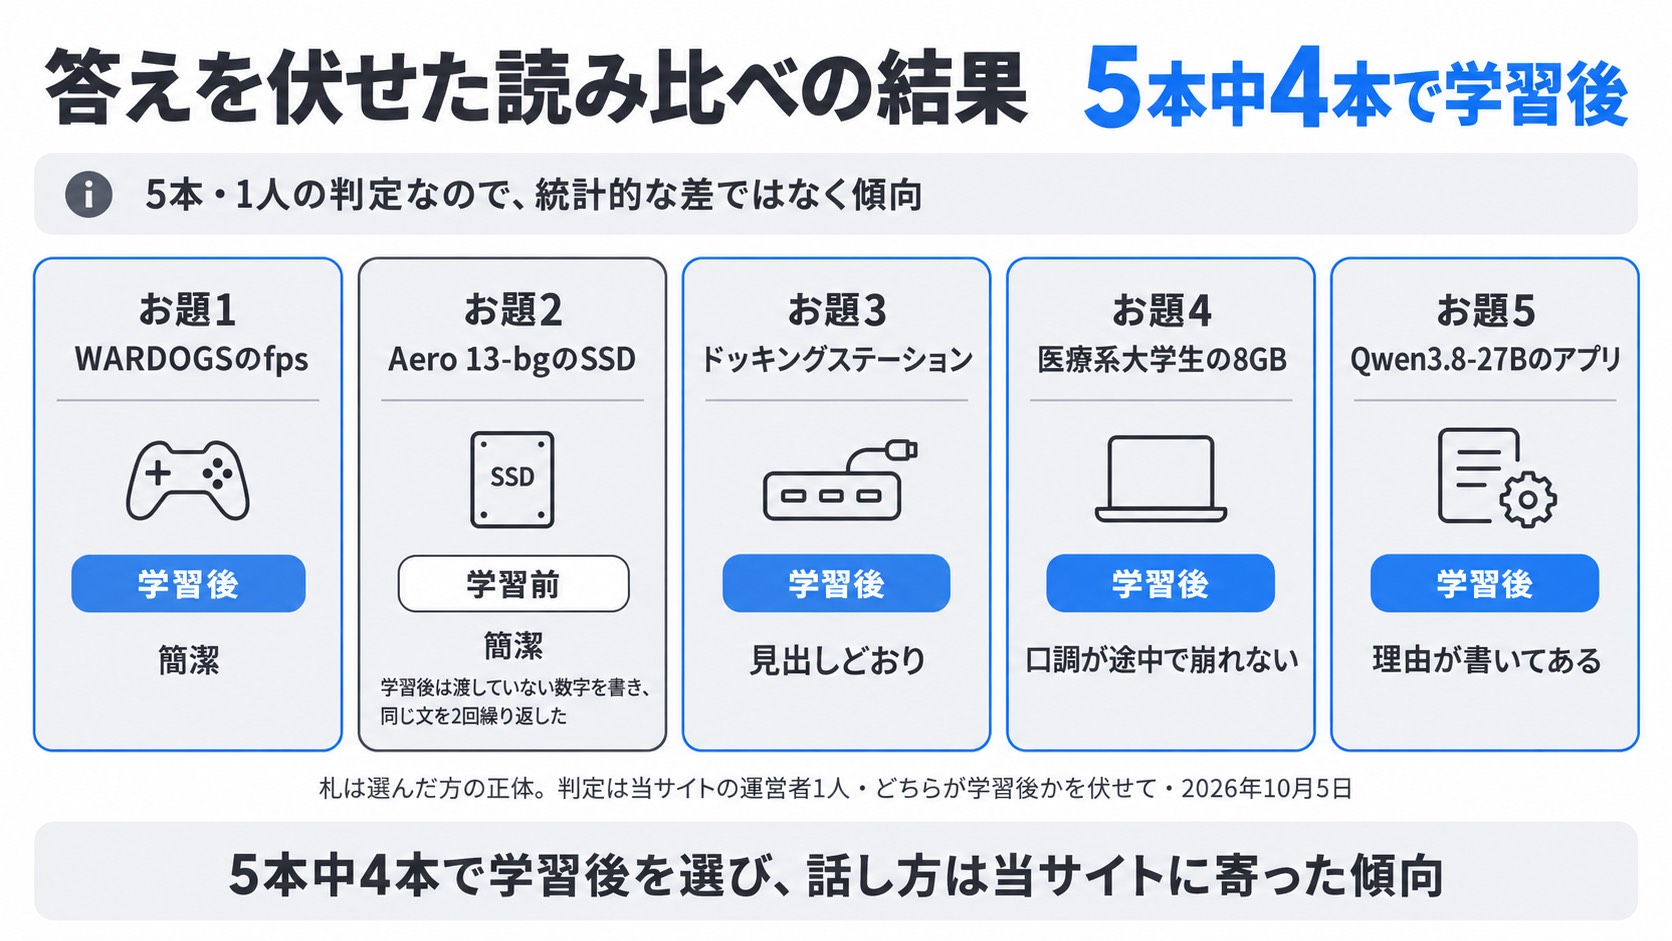
- 学習前後の文章を、どちらが学習後かを伏せて当サイトの運営者1人が5本読み比べた
- 4本で学習後を当サイトらしいと選び、外れた1本は学習後が数字を作った題
- 5本・1人の判定なので、話し方が寄った傾向として扱う
料理の味比べでも、どちらが新しいレシピか知っていると、つい新しいほうをひいきしたくなります。
読み比べでは、同じお題で書かせた学習前と学習後の文章をA・Bに並べ、どちらが学習後かを伏せたまま、当サイトの運営者が当サイトらしいほうを選びました。
5本のお題は、当サイトの既存記事の見出しから取っています。
学習前と学習後は同じ設定(4bit・考える過程を出さないThinkingオフ・temperature 0.7・seed 3407など)で、各題1回ずつ書かせました。
| お題 | 選んだ方 | 選んだ方の正体 | 選んだ理由(当サイトの運営者・要約) |
| お題1 WARDOGSのfps | A | 学習後 | 簡潔。もう一方の「〜は当たっているか。」と見出しを投げかける書き方は生成AIっぽい |
| お題2 Aero 13-bgのSSD | A | 学習前 | 簡潔。もう一方(学習後)は数字を並べすぎ |
| お題3 ドッキングステーション | A | 学習後 | 見出し(つなぐ順番と画面の設定)どおり。もう一方は関係ない使い方が入っている |
| お題4 医療系大学生の8GB | B | 学習後 | もう一方は口調が急にカジュアル |
| お題5 Qwen3.8-27Bのアプリ | A | 学習後 | 理由が書いてある。読者は疑問を解消したい |
5本中4本で、学習後の文章が当サイトらしいと選ばれました。
理由を見ると、簡潔さ、見出しに沿っているか、口調が途中で崩れないか、読者の疑問に理由まで答えているかが判断の軸になっています。
どの軸も当サイトの記事づくりで重視している点と重なり、練習で話し方がその方向へ寄った傾向が見えました。
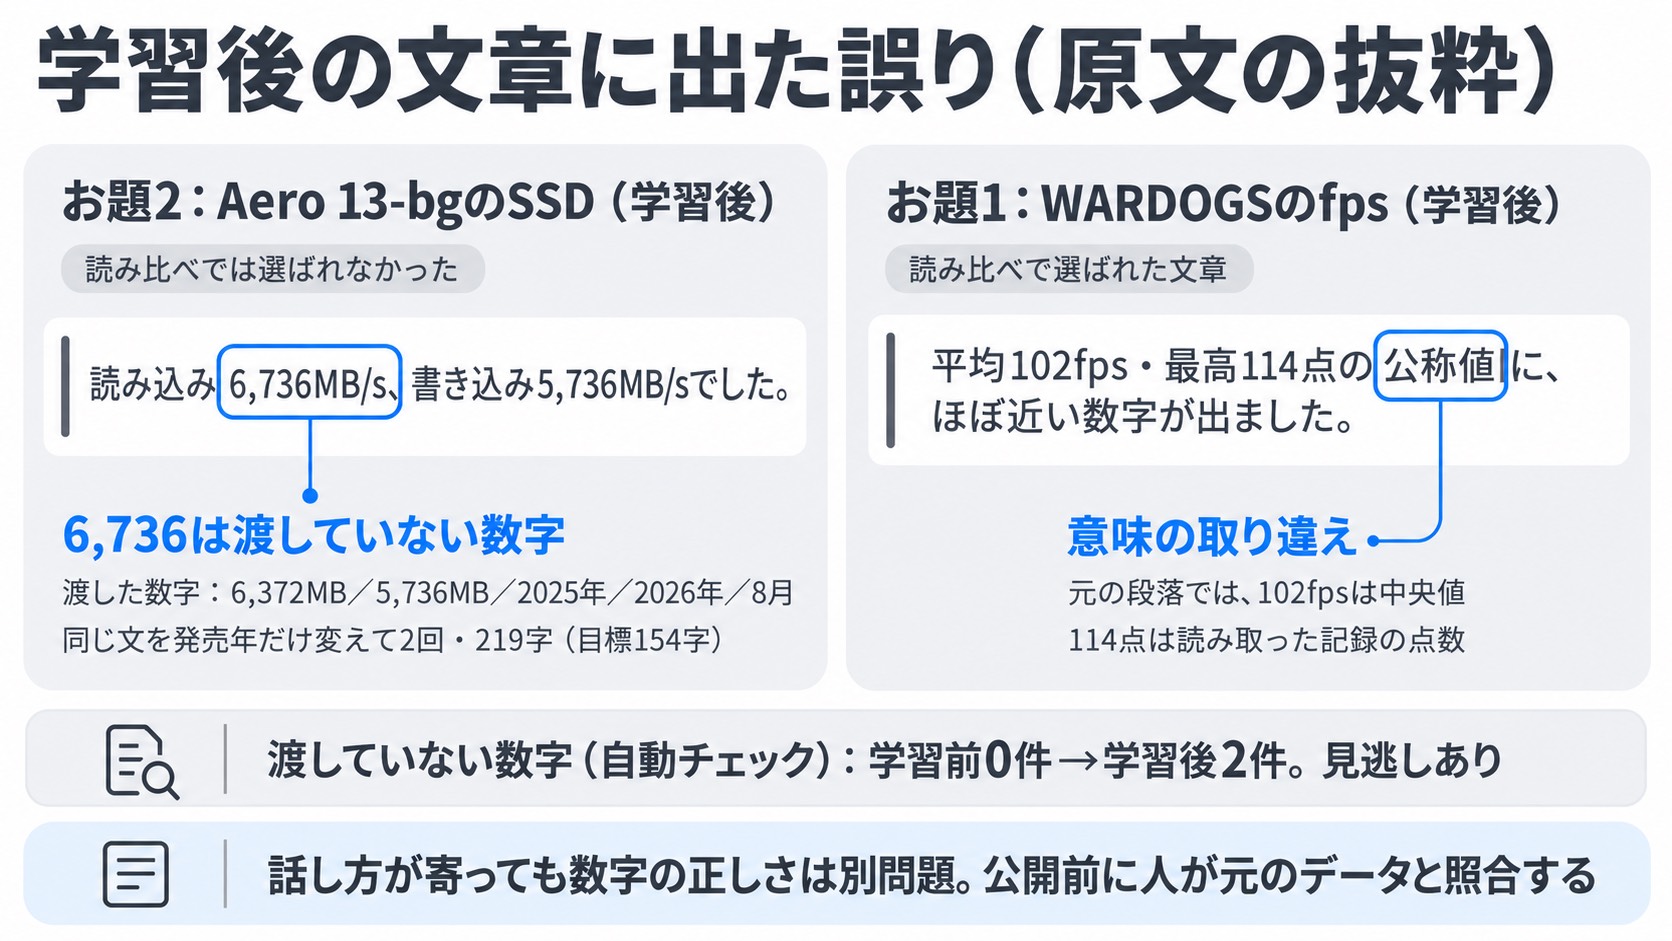
外れた1本(お題2)は、学習後の文章が渡していない数字を書き、同じ文を2回繰り返した題です。
5本・1人の判定なので統計的な差とは言えず、文体が寄った傾向として受け取ってください。
選ばれた学習後の文章にも数字の誤りがあったことは、次の節で原文を引いて見ていきます。
学習後の文章に出た誤り:渡していない数字と意味の取り違え
- 渡していない数字は、自動チェックで学習前0件→学習後2件(6,736と「3年生」の3)
- 読み比べで選ばれた学習後の文章にも、中央値を「公称値」と書くなどの取り違えがあった
- 自動チェックには見逃しがあり、公開前に人が元の数字と照合する
書き方の練習を積んだ新人が、言い回しは上手になったのに、資料にない数字をもっともらしく書き足してしまうことがあります。
学習後の9Bにも、同じ種類の誤りが出ました。
自動チェックの結果を、題ごとに並べます。
渡していない数字とは、出力にあって指示文に無い数字のことです。
| 題 | 目標字数 | 学習前の字数 | 学習後の字数 | 学習前・渡していない数字 | 学習後・渡していない数字 |
| お題1 WARDOGSのfps | 99 | 120 | 100 | なし | なし |
| お題2 Aero 13-bgのSSD | 154 | 153 | 219 | なし | 6,736(SSDの速度) |
| お題3 ドッキングステーション | 109 | 76 | 115 | なし | なし |
| お題4 医療系8GB | 82 | 71 | 82 | なし | 3(3年生) |
| お題5 Qwen3.8-27Bのアプリ | 145 | 159 | 197 | なし | なし |
合計は学習前0件、学習後2件ですが、網羅した件数ではありません。
チェックのスクリプトは指示文に含まれる数字を除外するため、お題4の学習後の「2年生」は目標字数「82」の2と一致して見逃されました。
一人称の主語(私・筆者など)は、学習前後とも5題すべてで0件でした。
次の3題は、学習前と学習後の文章をモデルの出力のまま引用します。
誤字や不自然な言い回しも直さず、誤りの箇所だけを太字にしました。
お題2:渡していない6,736と、繰り返した文
お題2はHP OmniBook 7 Aero 13-bgのSSDの速さで、渡した数字は「6,372MB/5,736MB/2025年/2026年/8月」です。
学習後の文章は、お題に無い別の製品名(HP OmniBook X Flip)を持ち出し、渡していない6,736という読み込み速度を書いたうえで、同じ文を発売年だけ変えて2回書きました。
字数も219字と、目標の154字を大きく超えています。
読み込み速度は6,372MB/s、書き込み速度は5,736MB/sで、SSDの性能は問題なく見えます。
2025年8月に発売したHP OmniBook X Flipは、同じくSamsungのNVMe SSDで読み込み6,736MB/s、書き込み5,736MB/sでした。
2026年8月に発売したHP OmniBook X Flipは、同じくSamsungのNVMe SSDで読み込み6,736MB/s、書き込み5,736MB/sでした。
2025 年 8 月に公開された HP OmniBook 7 Aero 13-bg は、CrystalDiskMark で 6,372MB/5,736MB の高速読み書きを達成しました。この圧倒的なパフォーマンスは、2026 年以降もビジネス現場で信頼できる基盤となり、次世代のワークフローを可能にします。
学習前の文章は渡した数字だけを使っていますが、「圧倒的なパフォーマンス」のように、煽る言い回しを避ける当サイトの書き方とは違う表現が入っています。
当サイトの運営者が選んだのは学習前のほうで、理由は簡潔さでした。
学習後は1文ずつ改行する形こそ元の段落に近い一方、数字を作って文を繰り返したぶん、読み比べでも選ばれていません。
お題1:中央値を「公称値」と読み替えた
お題1はWARDOGSを遊んだときのfps(1秒間に描く画面の枚数)で、元の記事の段落では、102fpsは中央値、114点は読み取った記録の点数です。
学習後の文章は渡した数字だけを使っていますが、中央値の102fpsを「平均」の「公称値」と書き、114点を「最高」と読み替えました。
57分間の実測で、平均は100.5fpsでした。
平均102fps・最高114点の公称値に、ほぼ近い数字が出ました。
70fps台の10%は85fpsで、ゲームの動きが止まるような場面は出ていません。
RTX 4070で57分遊んだ実測:公式の推奨は当たっているか。100.5fpsの安定した102fpsを維持し、114点の高スコアを記録。低負荷時でも70fps以上、負荷増で10%低下し85fpsまで落ちるが、快適に遊べるPCとして十分だ。
元の段落は、下位10%の目安が85fpsで公式推奨の70fpsを上回る、という内容で、学習後の「70fps台の10%は85fps」も意味が変わっています。
学習前の文章は見出しをそのまま問いかけに使い、当サイトの運営者には生成AIっぽいと受け取られました。
学習後は短く言い切る形で選ばれましたが、読み比べで選ばれた文章でも、数字の意味までは保証されないことがわかります。
お題5:速さの数字をGPUの名前のように書いた
お題5は、Qwen3.8-27Bを動かす3つのアプリ(llama.cpp・LM Studio・Ollama)の速さを比べる段落です。
元の段落では、18.13がllama.cpp、18.28がOllama、7.94がLM Studioの速さ(tok/s)でした。
学習後の文章は18.13と18.28を「NVIDIA 18.13 GPU」のようにGPUの名前として書き、アプリと速さの組み合わせも崩れています。
llama.cppは、CPU・GPU・量子化を細かく制御できるため、VRAMが足りないときに特に有効です。
Qwen3.8-27B Q4_K_Mは、NVIDIA 18.13 GPUで7.94 tok/s、18.28 GPUで7.94 tok/sでした。
OllamaはQwen3.8-27B Q3_K_Mで1.28 tok/s、Qwen3.8-27B Q4_K_Mで7.06 tok/sでした。
llama.cpp・LM Studio・Ollama のどれで動かすか。Qwen3.8-27B を 16GB VRAM で動かす場合、 llama.cpp は 4/18.13/18.28/7.94tok/s/3/1.28/7.06tok/s となり、 LM Studio は 3/1.28/7.06tok/s となる。
学習前は渡された数字を並べただけで、読者には何の速さかが伝わりません。
学習後は理由から書き始める形が選ばれた一方、数字の対応は元の段落と食い違っています。
話し方が寄っても数字の正しさは別問題で、公開する前に人が元のデータと照合する工程は外せないと考えています。
Gemma 4 12Bは読み込みの段階で止まった
- 9Bのほかに、挑戦枠としてGemma 4 12Bの練習も予定した
- 学習用ライブラリ(transformers 5.5.0)が未対応で、読み込みの段階で停止
- メモリ不足で止まったのではない。16GBで載るかは測れていない
一回り分厚い百科事典でも試そうとしたところ、本を開く前の段階で止まりました。
Gemma 4 12Bは、学習用ライブラリ(transformers 5.5.0)がまだこのモデルに対応しておらず、モデルを読み込む段階で止まりました。
メモリ不足で止まったのではなく、16GBで載るかは測れていません。
計測の途中で道具の版を変えない決まりにしていたため、ライブラリの更新も再挑戦もしていません。
12Bの練習が16GBで通るかどうかは、今回の記録からは判断がつきません。
自分で試すときに気をつけること
- 教材に実在の個人情報を入れない。変わる事実はRAGで渡す
- 数字を指示で渡しても作ることがあるので、公開前に人が照合する
- 教材の長さでVRAMが変わる。マージやGGUF化は今回していない
自宅のPCで練習させる前に、今回の結果から気をつけたい点を5つにまとめました。
- 教材に実在の個人情報を入れない:練習で読んだ文章が、別の質問の答えに混ざって出てくることがあります。お客さまの名前や連絡先は教材に入れず、公開済みの文章や架空の内容で作ります
- 数字を指示で渡しても、モデルは数字を作ることがある:今回も学習後に2件出ました。公開する前に、人が元のデータと数字を1つずつ照合します
- 教材の長さでVRAMが変わる:今回は1問が最大463トークンの短い教材でした。長い文章を教材にするなら、作業台の使い方は改めて測る必要があります
- マージとGGUF化は今回していない:付せんを本に書き込んで1冊にまとめること(マージ)も、LM StudioやOllamaで読める形式(GGUF)に変えることも試していません。学習後のモデルは、学習に使った道具の上で文章を書かせただけです
- 事実はRAGで渡す:価格や仕様のように変わる情報は練習させず、答えるたびに資料として渡します
学習に使ったPC:FRONTIER FRGKB860M/CG3
- RTX 5070 Ti(16GB)・Core Ultra 7 265F・メモリ32GBの構成
- 9BのQLoRA学習は、16GBの作業台のうち約13.9GBを使って1周した
- AIに答えてもらう速さ(推論)は、モデル別の実測記事で確かめられる
練習に使ったのは、FRONTIERのデスクトップPC FRGKB860M/CG3です。
GPUはVRAM 16GBのRTX 5070 Ti、CPUはCore Ultra 7 265F、メモリは32GBで、9BのQLoRA学習は16GBの作業台のうち約13.9GBを使って最後まで進みました。
同じPCでAIに答えてもらう速さは、モデルごとの記事にまとめています。
Qwen3.8-27BはQwen3.8-27Bを16GB VRAMで動かした実測、gpt-oss-20bはgpt-oss-20bの16GB VRAM実測、Gemma 4 26B-A4BはGemma 4 26B-A4Bの16GB VRAM実測で読めます。
RTX Sparkのような大きなメモリを積んだ機種と比べたいときは、ローカルAI向けPCの比較記事が参考になります。
ローカルLLMを動かすのが初めてなら、ローカルLLMとは?できることと始め方で、LM StudioやOllamaで答えてもらうところから試すと順番がつかみやすくなります。
まとめ
16GBのゲーミングPCでも、9Bに当サイトの書き方を練習させる学習は3分31秒で1周し、VRAMは約13.9GBに収まりました。
答えを伏せた読み比べでは5本中4本で学習後が選ばれ、話し方は当サイトに寄った傾向が見えています。
正直なところ、今回確かめられたのは書き方が寄る傾向までで、数字まで任せられる段階には届いていないと見ています。
一方で、学習後の文章は渡していない数字を書き、読み比べで選ばれた文章でも数字の意味を取り違えました。
書き方は練習で、事実は資料(RAG)で渡し、公開する前には人が数字を確かめるという分担で使うのが現実的だと考えています。
Gemma 4 12Bは学習用ライブラリが未対応で読み込みの段階で止まり、16GBで載るかはまだ測れていません。
よくある質問
16GBのGPUでローカルLLMのファインチューニングはできる?
9BのQLoRAなら通りました。
当サイトの実測(RTX 5070 Ti 16GB)で、Qwen3.5-9Bに教材1,000件を1周練習させる学習が3分31秒で終わり、VRAMのピークは約13.9GB(13,868 MiB)でした。
教材の1問が最大463トークンと短い条件の結果で、長い教材やほかのモデルで同じように収まるかはこの結果から言えません。
QLoRAとLoRAの違いは?
LoRAは、AIの本体はそのままにして、付せん(アダプター)だけを書き足して練習させる方法です。
QLoRAは本体を4bitに縮小コピーしたうえで付せんを貼るので、作業台(VRAM)の使用量が小さく済みます。
ローカルLLMを動かすPCのスペックガイドで整理した公開資料の目安では、LoRA(bf16)が約2〜2.5GB×パラメーター数(B)、QLoRA(4bit)が約0.7〜1GB×Bです。
ファインチューニングとRAGの違いは?
ファインチューニングは練習で話し方や答えの形を身につけさせる方法で、RAGは答えるたびに資料を手渡す方法です。
価格や仕様のように変わる事実はRAGで渡し、口調や段落の組み立ては練習で整える分担が向いています。
今回の学習も書き方を練習させたもので、製品の事実を覚えさせたものではありません。
学習にどのくらい時間がかかった?
学習そのものは211.3秒(3分31秒)でした。
モデルの読み込みに29.6秒かかり、起動から学習前後の文章の生成と比較まで含めると約7分です。
9Bの最初の読み込みは、初回のダウンロードを含めて1,414秒かかりました。
学習させれば数字や事実も正確に書けるようになる?
今回の学習では、数字の正確さは上がりませんでした。
数字を指示で渡して「無い数字は書かない」と教えた教材でも、学習後の文章には渡していない数字が自動チェックで2件(SSDの速度6,736と「3年生」)出て、中央値を「公称値」と書くような意味の取り違えもありました。
公開する前には人の確認が要り、事実はRAGで渡すのが前提です。
Gemma 4 12Bは学習できた?
今回は学習まで進んでいません。
Gemma 4 12Bは、学習用ライブラリ(transformers 5.5.0)がまだこのモデルに対応しておらず、モデルを読み込む段階で止まりました。
メモリ不足で止まったのではなく、16GBで載るかは測れていません。
計測条件の一覧
- 計測日:2026年10月4日(試運転)・10月5日(本番)
- PC:FRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB〔16,303 MiB〕・Core Ultra 7 265F・メモリ32GB)
- OS:Windows 11 Pro(26100)・WSL2(Ubuntu 24.04)
- GPUドライバ:616.64
- ライブラリ:Unsloth 2026.8.22・transformers 5.5.0・torch 2.11.0+cu130・Python 3.12.3
- モデル:unsloth/Qwen3.5-9B(挑戦枠のunsloth/gemma-4-12b-itは読み込みで停止)
- 方式と設定:QLoRA(4bit)・r16・alpha16・1周(1 epoch)・125ステップ・max_seq 1024・batch 2×累積4・学習率2e-4・seed 3407・応答部分だけで損失を計算
- 教材:学習用1,000件・確認用50件(合計178,709トークン・平均178.7・最大463・1,024超は0件)
- 生成の設定:4bit・Thinkingオフ・temperature 0.7・top_p 0.8・top_k 20・最大512トークン・seed 3407・各題1回
- 読み比べ:当サイトの運営者1人・5本・どちらが学習後かを伏せて判定
- 生成の速さ(tok/s)は各題1回で長さもそろわないため、学習前後の比較はしていない