Qwen3.8-27Bは16GB VRAMで動く?おすすめの量子化と設定を実測で解説(RTX 5070 Ti)
Qwen3.8-27Bを手元のPCで動かそうとHugging Faceを開くと、Q3、IQ4、Q4と似た名前のGGUF(モデルを保存するファイル形式)がずらりと並びます。
中身は同じ百科事典で、縮小コピーの度合いだけが違う版が何通りも置いてある状態です。
GPUの専用メモリであるVRAMが16GBの場合、どの版が収まるのか、収まったとして長い資料をどこまで渡せるのかは、ファイル名だけでは見当がつきません。
1本12〜16GiBあるファイルを順にダウンロードして試すのは、通信量も待ち時間もかさみます。
先に答えを言うと、VRAM 16GBのグラフィックボードならUD-Q3_K_XLが本命です。
答えを書く速さはIQ4_XSとほぼ同じで、読んだ資料のメモ(KVキャッシュ)を短く書く設定にすると、本1冊分くらいの資料(128Kの深さ)を渡しても、百科事典を全部作業台(VRAM)に広げたまま回りました。
短い会話が中心ならIQ4_XSも選べ、いちばん厚いQ4_K_Mは作業台に置く巻(層)の数を手で決めると26.56 tok/sまで戻ります。
- AI(Qwen3.8-27B)=分厚い百科事典を持った物知りの人。27Bは百科事典の分厚さの目安で、中身は66巻(層)に分かれている
- VRAM(GPUのメモリ)=手元の作業台。いちばん速く使えるが、今回は16GBと小さい。メインメモリ=そばの机。66巻を全部作業台に広げられた状態を、この記事では全層GPUと呼ぶ
- 量子化(UD-Q3_K_XL・IQ4_XS・Q4_K_M)=百科事典を縮小コピーして薄くした版。薄いほど作業台に収まりやすいが、細かい字が少しつぶれることがある
- KVキャッシュ=読んだ資料や会話を書き留めて作業台に置くメモ。資料が長いほどメモが増える。KVキャッシュの量子化(q8_0・q4_0)=そのメモを略字で短く書くこと
- tok/s=1秒あたりに書き進められる文字のかたまり(トークン)の数。日本語では、おおよそ1かたまりで1〜2文字ほど
- 深さ(渡した資料の長さ)=8Kは長いメール数通くらい、32Kは論文1本くらい、128Kは本1冊分くらい
- UD-Q3_K_XL(12.24GiB)とIQ4_XS(13.27GiB)は、答えを書く速さ(生成)が52.50対50.07 tok/sでほぼ同じ
- メモ(KVキャッシュ)をq4_0で短く書くと、UD-Q3_K_XLは本1冊分くらい(128K)の資料を渡しても全層GPUのまま29.28 tok/s
- Q4_K_M(15.66GiB)は66巻すべてを作業台に指定すると6.85 tok/s、作業台に置く巻(層)を62にすると26.56 tok/s
- 短い決まった形の課題なら、MTP(次の数語を先に用意する仕組み)で書く速さが2倍超(UD-Q3_K_XLのコード課題で50.74→114.92 tok/s)
RTX 5070 Ti 16GB搭載のFRONTIER FRGKB860M/CG3で測った値をベースにしています。
最初の速度計測は2026年9月3日、回答品質は9月8日で、量子化とKVキャッシュの比較・長い文脈・層数・MTP・Thinking・アプリの違い・IQ4_XSの回答品質は9月29日〜10月1日に実測しました。
記事中の数値はすべて当サイトの計測で、llama-benchで測った速度は3回測ったまん中の値(中央値)です。
アプリ比較の全層指定、Thinkingの比較、回答品質の基本課題は1回ずつの計測なので、回数と条件は節ごとに添えています。
細かな条件は記事の最後に一覧でまとめています。
- 結論:16GBの作業台にはUD-Q3_K_XLが本命、短い会話が中心ならIQ4_XSも
- 必要スペック:16GBの作業台に3つの縮小版を置くと、どれだけ空くか
- 書く速さ:UD-Q3_K_XLとIQ4_XSはほぼ同じ速さで答える(tok/s)
- 長い資料を渡すと、どこまで作業台に収まるか(全層GPUの限界)
- Q4_K_Mを使うなら、作業台に置く巻の数(層)を手で決める
- 答えの正しさ:3つの縮小版に同じ20課題を出した
- 答える前に下書きさせるか(Thinkingの段階)
- 次の数語を先に用意して速く書く(MTP)
- どのアプリで動かすか:llama.cpp・LM Studio・Ollama
- 使い方別のおすすめ設定
- このモデルを動かすPC
- まとめ
- よくある質問
- 計測条件
結論:16GBの作業台にはUD-Q3_K_XLが本命、短い会話が中心ならIQ4_XSも
- 速さはUD-Q3_K_XLとIQ4_XSでほぼ同じ
- 長い資料を渡すと、UD-Q3_K_XLのほうが長くまで百科事典を作業台に広げたまま(全層GPU)扱える
- Q4_K_Mは作業台に置く巻(層)の数を手で決めて使う
3つのファイルは、同じ百科事典を縮小コピーの度合いを変えて作った3つの版です。
いちばん薄いUD-Q3_K_XLは作業台に広げても端に余白が残り、いちばん厚いQ4_K_Mは作業台をほぼ埋めてしまいます。
空いた端に読んだ資料のメモを置けるかどうかが、16GBでの選び方を分けました。
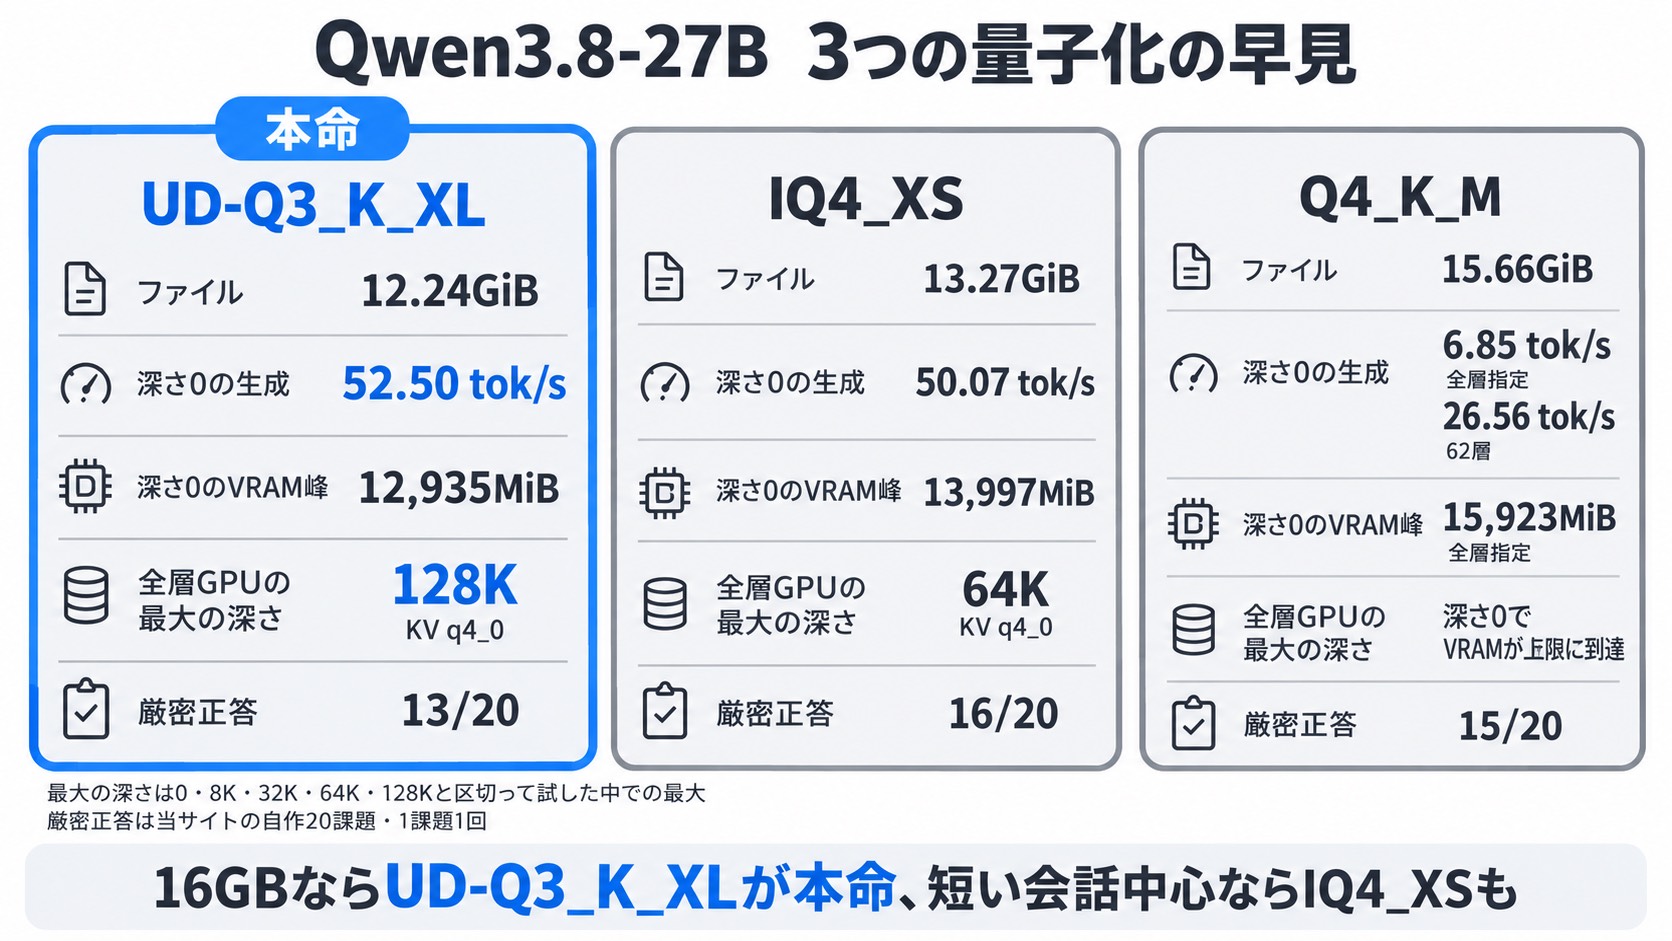
表の見方は、左の列が項目、右の3列が縮小版ごとの値です。
たとえば「全層GPUのまま測れた最大の深さ」の行は、資料をどこまで長くしても百科事典を作業台から下ろさずに済んだかを示し、UD-Q3_K_XLの128Kは本1冊分くらいにあたります。
| 項目 | UD-Q3_K_XL | IQ4_XS | Q4_K_M |
| ファイルの大きさ | 12.24GiB | 13.27GiB | 15.66GiB |
| 深さ0の生成(tok/s) | 52.50 | 50.07 | 6.85(全層指定) 26.56(62層) |
| 深さ0のVRAM峰 | 12,935MiB | 13,997MiB | 15,923MiB(全層指定) |
| 全層GPUのまま測れた最大の深さ | 128K(KV q4_0) | 64K(KV q4_0) | 深さ0でVRAMが上限に到達 |
| 自作20課題の厳密正答 | 13/20 | 16/20 | 15/20 |
UD-Q3_K_XLを本命にした理由は2つあります。
1つ目は速さで、前置きなし(深さ0)で答えを書く速さはUD-Q3_K_XLが52.50 tok/s、IQ4_XSが50.07 tok/sと、差は約5%にとどまりました。
2つ目は渡せる資料の長さで、メモ(KVキャッシュ)をq4_0にそろえると、UD-Q3_K_XLは128K、IQ4_XSは64Kまで全層GPUのまま測れています。
作業台(VRAM)の使い方もUD-Q3_K_XLのほうが約1GB少なく、深さ0での最大使用量は12,935MiBと13,997MiBでした。
浮いた約1GBは、長い資料を渡したときのメモの置き場に回せます。
IQ4_XSを選ぶ理由もあります。
自作の20課題では、形式や文字数の指定まで守れた数(厳密正答)がIQ4_XS 16、UD-Q3_K_XL 13で、IQ4_XSが3問多くなりました。
メモをq8_0にすれば論文1本くらい(32K)まで全層GPUに収まるので、短い会話が中心ならIQ4_XSも候補に入ります。
必要スペック:16GBの作業台に3つの縮小版を置くと、どれだけ空くか
- UD-Q3_K_XLとIQ4_XSは、百科事典を広げてもメモ(KVキャッシュ)の置き場が残る
- Q4_K_Mは百科事典だけで16GBの作業台が上限近くまで埋まる
- 長い資料を渡すほど、メモが作業台の場所を取る
16GBの作業台に、厚さの違う3冊の百科事典を順に置いてみる場面を考えてください。
百科事典を広げたあとに残る端のスペースが、読んだ資料や会話を書き留めておくメモ(KVキャッシュ)の置き場になります。
資料が長いほどメモは増えるので、端が広いほど長い資料まで作業台の上だけで扱えます。
百科事典を薄くする縮小コピーにあたるのが量子化で、モデルの重み(学習で決まった数値の集まり)を、少ないデータ量で表してファイルを小さくする処理です。
名前のQ3やQ4の数字はおおよそのビット数を表し、数字が小さいほど縮小の度合いが強く、ファイルは小さくなります。
KVキャッシュは、会話や資料を処理した途中の結果を保存しておく作業領域で、渡した文章が長いほど大きくなります。
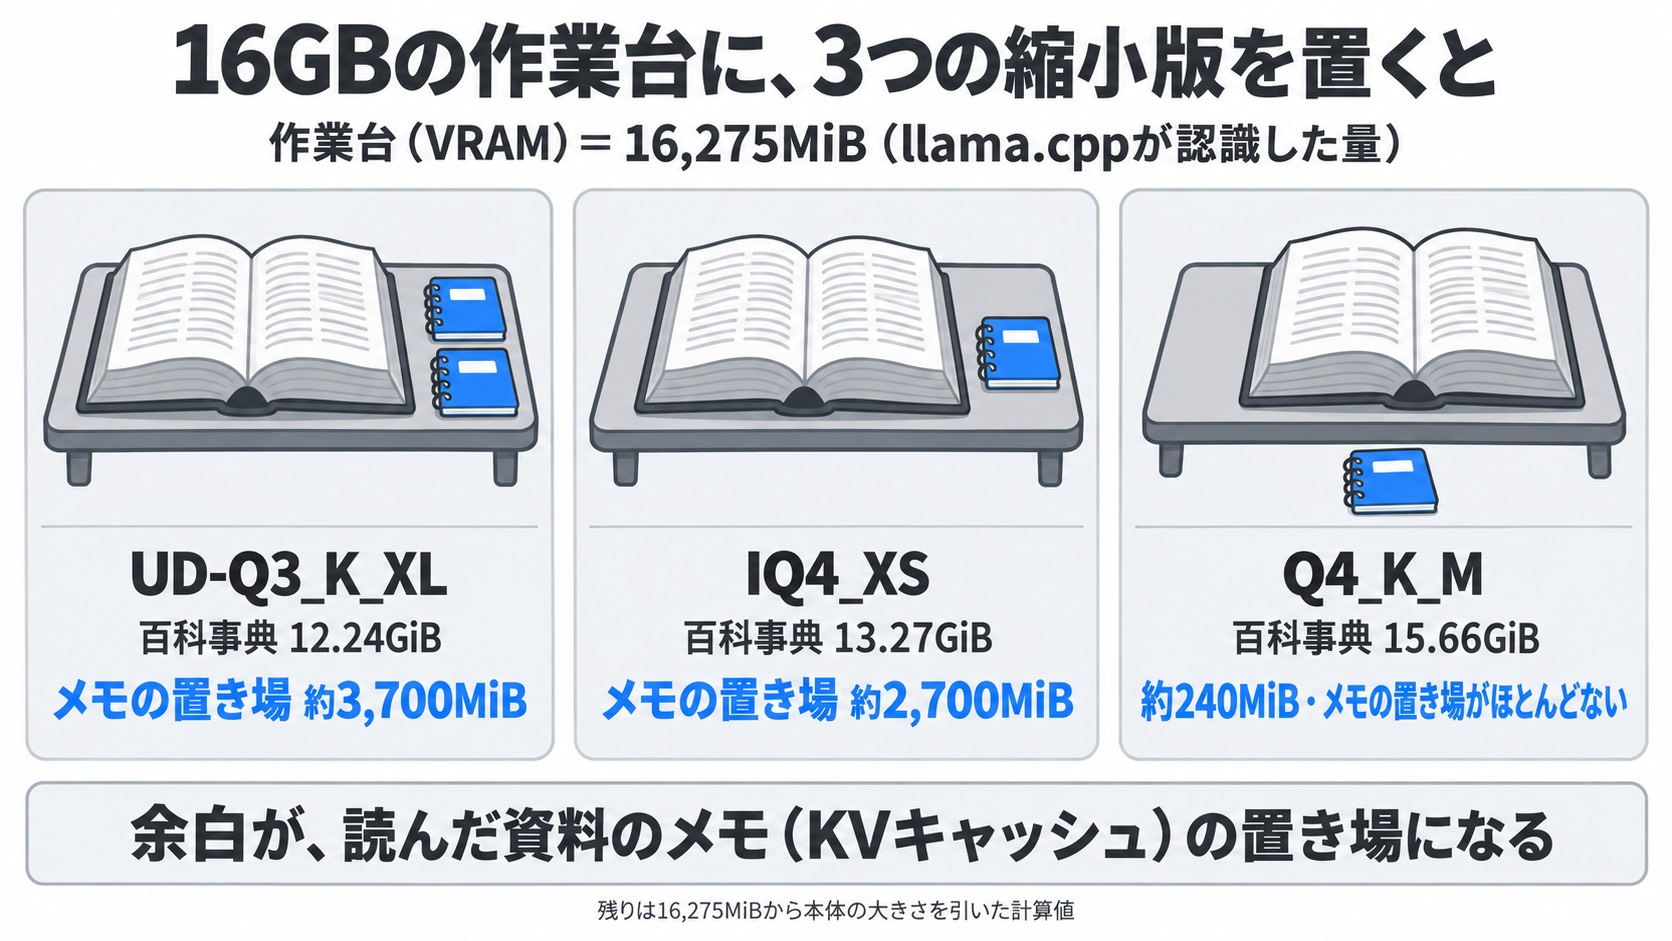
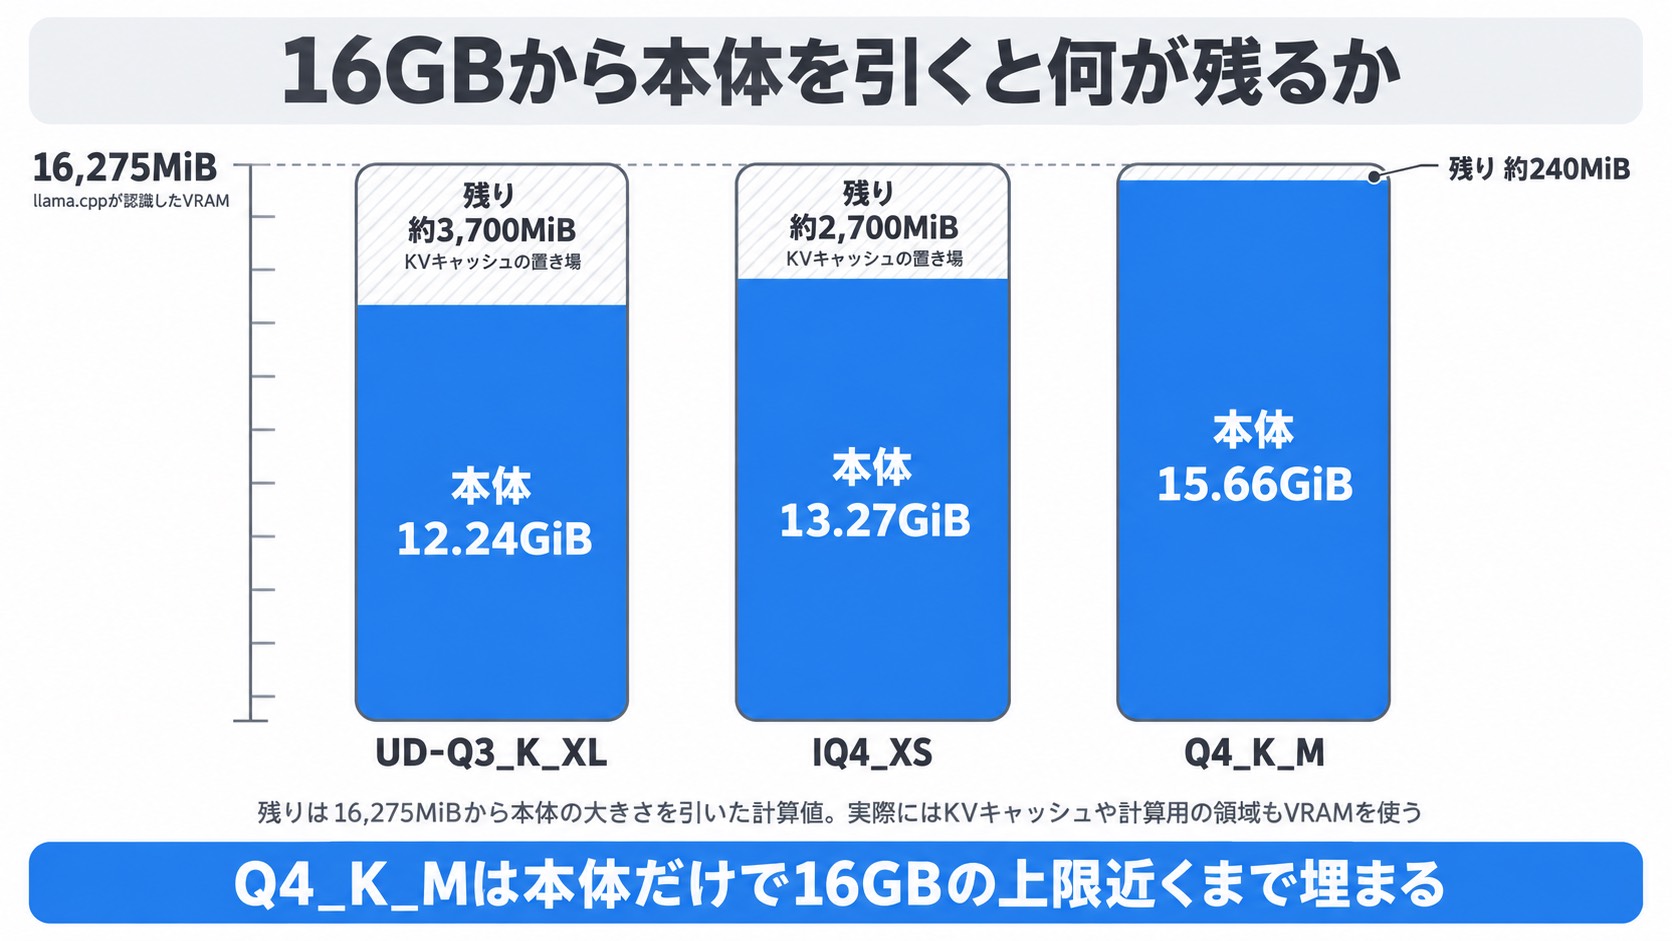
表の見方は、行が3つの縮小版で、右へ順にファイルの大きさ、作業台から百科事典の大きさを引いた残り、実際に測った作業台の最大使用量です。
たとえばQ4_K_Mの行は、残りが約240MiBしかなく、メモを置く前に作業台がほぼ埋まることを示しています。
| 量子化 | ファイルの大きさ | 16,275MiBから本体を引いた残り | 深さ0のVRAM峰 |
| UD-Q3_K_XL | 12.24GiB(約12,537MiB) | 約3,700MiB | 12,935MiB |
| IQ4_XS | 13.27GiB(約13,593MiB) | 約2,700MiB | 13,997MiB |
| Q4_K_M | 15.66GiB(約16,032MiB) | 約240MiB | 15,923MiB(全層指定) |
RTX 5070 Tiの作業台(VRAM)は、nvidia-smiの表示で16,303MiB、llama.cppが認識した量は16,275MiBでした。
16,275MiBから百科事典の大きさを引くと、UD-Q3_K_XLは約3,700MiB、IQ4_XSは約2,700MiBの空きが残ります。
Q4_K_Mの残りは約240MiBで、メモ(KVキャッシュ)を置く前に上限近くまで埋まってしまいます。
空きの差が効いてくるのは、長い資料を渡したときです。
資料を足すほどメモが増えるので、同じ16GBでも先に上限へ届くのは、百科事典が厚いIQ4_XSのほうです。
16GB以外のVRAM容量で何が動くか、PC全体の選び方はローカルLLM用のGPU・PCの選び方にまとめています。
ローカルLLMという言葉自体が初めての場合は、ローカルLLMとは?できることと始め方から読むと分かりやすくなります。
書く速さ:UD-Q3_K_XLとIQ4_XSはほぼ同じ速さで答える(tok/s)
- 前置きなし(深さ0)で答えを書く速さは52.50と50.07 tok/s
- 論文1本くらい(32K)の資料を先に渡しても40 tok/s台を保つ
- 9月3日と9月29日の測り直しで差は1.4%以内
物知りの人に質問すると、まず渡された資料を読み、読み終えてから答えを書き始めます。
速さも2つに分けて測り、表の「処理」は渡した文章を読む速さ、「生成」は返事を書く速さを表します。
単位のtok/sは1秒あたりに進めるトークン(文字のかたまり)の数で、日本語では、おおよそ1かたまりが1〜2文字ほどです。
深さは、会話や資料としてすでに渡してある文章の長さをトークン数で表したものです。
32Kは約3万2千トークンが入っている状態で、論文1本くらいの資料を先に読ませてから質問する場面にあたります。
表の見方は、行が縮小版と深さの組み合わせ、列が読む速さ・書く速さ・作業台の最大使用量(VRAM峰)です。
たとえばIQ4_XSの32Kの行は、作業台が15,928MiBで上限に張り付き、書く速さが41.71 tok/sまで下がったことを示しています。
| 量子化 | 深さ | 処理 pp512(tok/s) | 生成 tg128(tok/s) | VRAM峰 |
| UD-Q3_K_XL | 0 | 1,859.33 | 52.50 | 12,935MiB |
| UD-Q3_K_XL | 32K | 1,246.02 | 46.40 | 15,025MiB |
| IQ4_XS | 0 | 1,894.56 | 50.07 | 13,997MiB |
| IQ4_XS | 8K | 1,740.76 | 48.75 | 14,921MiB |
| IQ4_XS | 32K | 1,156.60 | 41.71 | 15,928MiB(上限に張り付き) |
前置きなし(深さ0)では、答えを書く速さがUD-Q3_K_XL 52.50 tok/s、IQ4_XS 50.07 tok/sでした。
資料を読む側の処理はIQ4_XSが1,894.56 tok/sで、UD-Q3_K_XLの1,859.33 tok/sをわずかに上回ります。
書く速さの差は約5%、読む速さの差は約2%です。
4bitのIQ4_XSを足して測ると、深さ0の速さはUD-Q3_K_XLとほぼ同じでした。
ところがメモ(KVキャッシュ)を標準のf16のまま32Kまで積むと、作業台(VRAM)が15.9GBに張り付きます。
32Kで書く速さはUD-Q3_K_XLの46.40 tok/sに対してIQ4_XSが41.71 tok/sで、差も少し開きました。
同じ条件で日を変えて測っても、UD-Q3_K_XLの深さ0はほとんど変わりませんでした。
9月3日は処理1,873.78/生成53.15 tok/s、9月29日の測り直しで1,856.41/52.43 tok/sで、差は処理−0.9%、生成−1.4%です。
百科事典を全部作業台に広げて(全層GPU)回っている間のGPU電力は、最大値で280〜305Wでした。
UD-Q3_K_XLとIQ4_XSを比べる表は、同じ9月29日に測った値どうしで並べています。
長い資料を渡すと、どこまで作業台に収まるか(全層GPUの限界)
- メモ(KVキャッシュ)をq4_0で短く書くと、UD-Q3_K_XLは本1冊分くらい(128K)まで全層GPU
- IQ4_XSは同じq4_0で64Kまで
- 作業台(VRAM)からはみ出すと、書く速さは5 tok/s前後まで落ちる
物知りの人は、渡された資料を読みながら、内容をメモに書き留めて答えを考えます。
資料が長いほどメモの束は厚くなり、百科事典と同じ作業台の上で場所を取り合います。
今回読ませた架空の資料は28,098トークンで、32Kの枠にほぼ1本分が入る量です。
64Kなら資料2本分、128Kなら4本分を一度に抱えることになります。
メモを短く書いて場所を空ける(KVキャッシュの量子化)
会議のメモも、略字や短い言い回しで書けば同じ内容を少ない紙に収められます。
KVキャッシュの量子化も同じ考え方で、会話や資料のメモのデータ量を減らす設定です。
標準のf16に対して、q8_0とq4_0の2段階を試しました。
論文1本くらい(32K)の資料を渡したとき、UD-Q3_K_XLの作業台(VRAM)の最大使用量は、f16 15,025MiB、q8_0 14,059MiB、q4_0 13,543MiBと下がっています。
表の見方は、上の3行がUD-Q3_K_XL、下の3行がIQ4_XSで、メモの書き方(KVキャッシュの型)だけを変えています。
たとえばUD-Q3_K_XLの3行を上から読むと、メモを短く書くほど作業台の最大使用量が15,025MiBから13,543MiBへ減っていきます。
| 量子化 | KVキャッシュ | 処理 pp512(tok/s) | 生成 tg128(tok/s) | VRAM峰 |
| UD-Q3_K_XL | f16 | 1,246.02 | 46.40 | 15,025MiB |
| UD-Q3_K_XL | q8_0 | 1,127.05 | 44.32 | 14,059MiB |
| UD-Q3_K_XL | q4_0 | 1,125.50 | 43.58 | 13,543MiB |
| IQ4_XS | f16 | 1,156.60 | 41.71 | 15,928MiB |
| IQ4_XS | q8_0 | 1,146.35 | 42.64 | 15,143MiB |
| IQ4_XS | q4_0 | 1,137.59 | 42.07 | 14,586MiB |
メモを短くしても書く速さの低下は小さく、UD-Q3_K_XLの生成は46.40→44.32→43.58 tok/sで、f16からq4_0まで約6%の低下でした。
資料を読む処理はf16からq8_0に変えた時点で約1割下がり、q4_0との差はほとんどありません。
IQ4_XSは生成がf16 41.71、q8_0 42.64、q4_0 42.07 tok/sと、f16のときが一番遅い結果です。
略字で書いたメモから、資料の中身を読み違えないかも確かめました。
28,098トークンの架空の資料に12問を出すと、UD-Q3_K_XLはメモの型がf16・q8_0・q4_0のどれでも12/12でした。
12問の範囲では、メモを短く書いても正答は変わっていません。
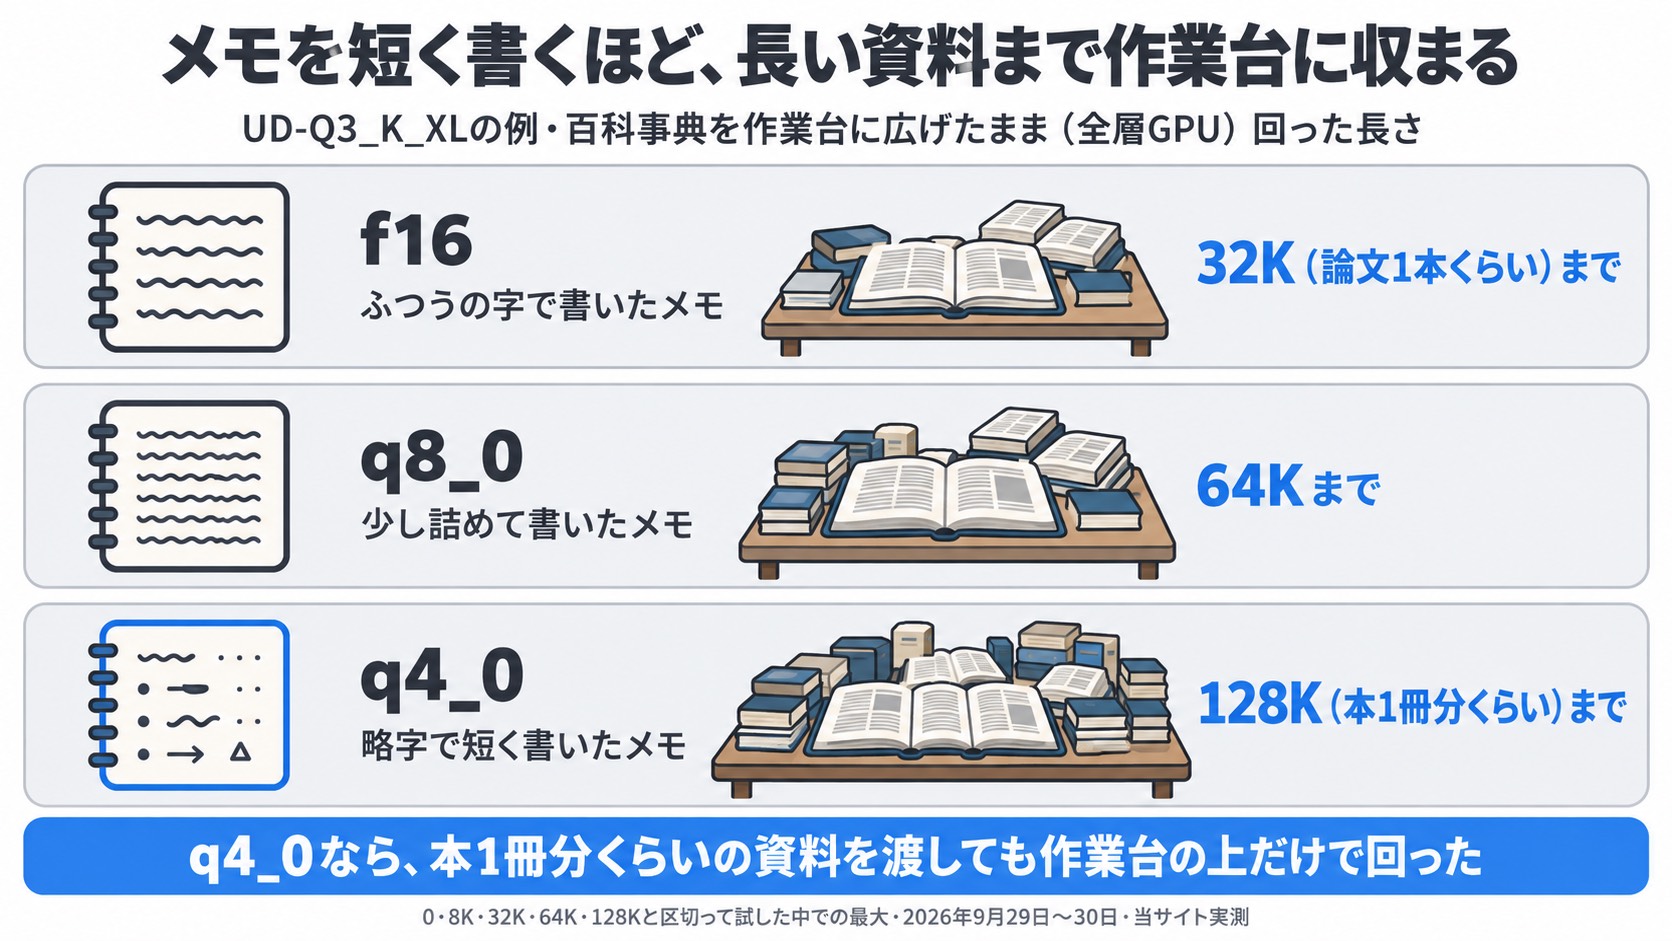
百科事典もメモも作業台に収まった、いちばん長い資料
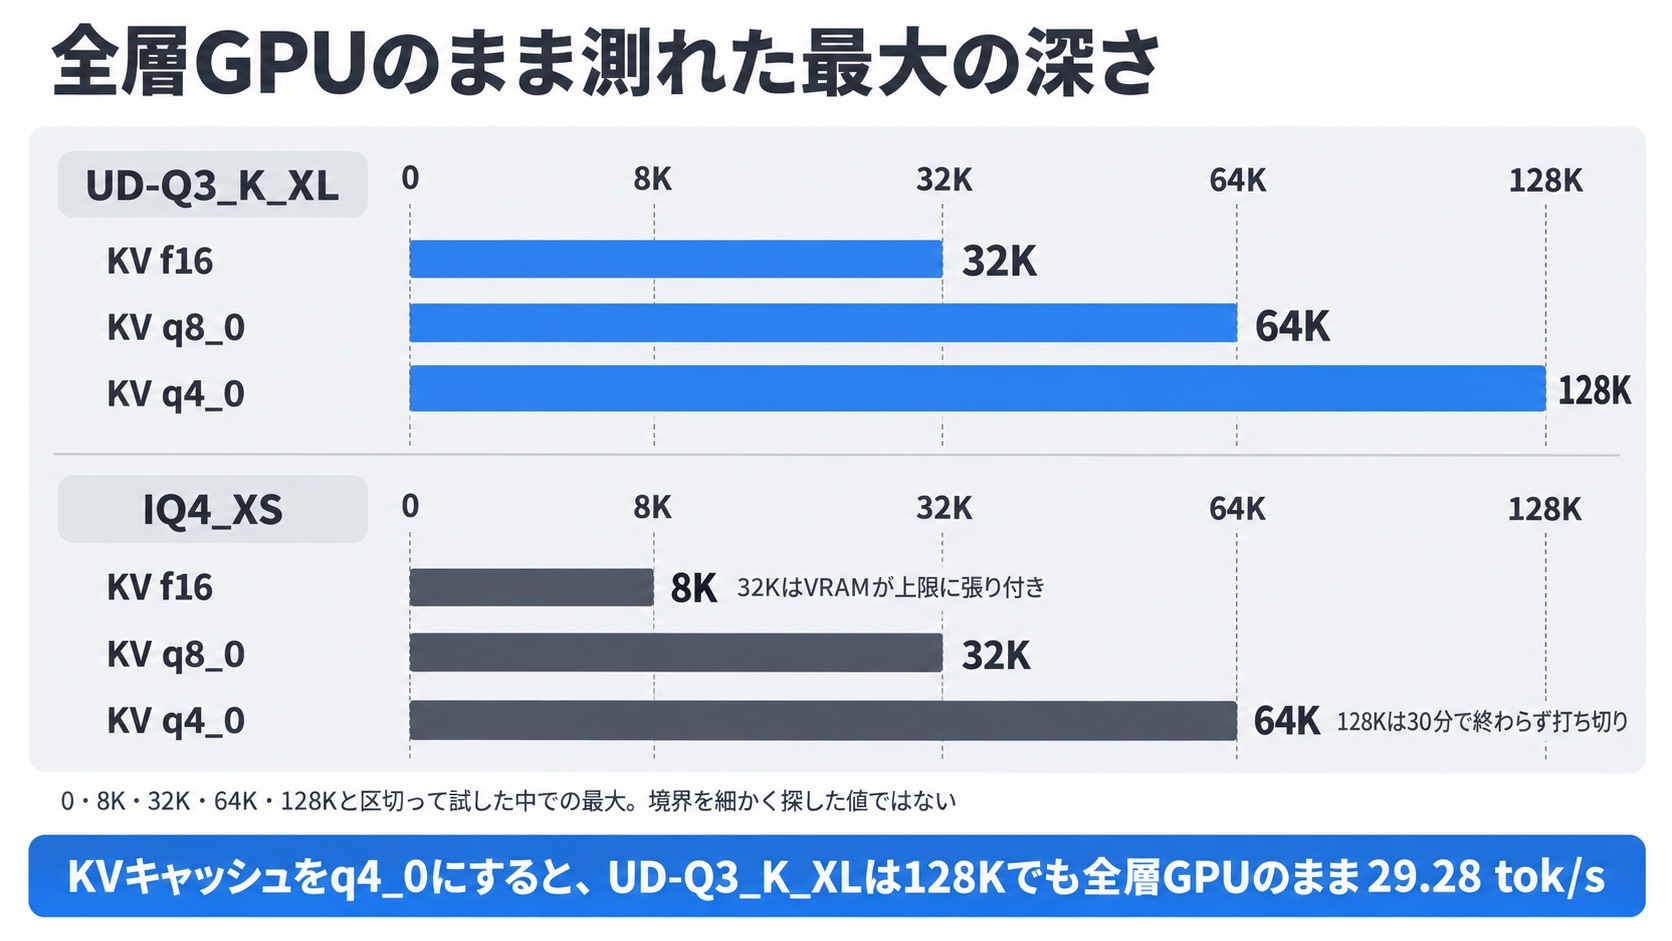
表の見方は、行が縮小版、列がメモの書き方で、マスの値は百科事典を作業台から下ろさずに測れた最大の長さです。
たとえばUD-Q3_K_XLのKV q4_0の列にある128Kは、本1冊分くらいの資料を渡しても作業台の上だけで回ったことを示します。
| 量子化 | KV f16 | KV q8_0 | KV q4_0 |
| UD-Q3_K_XL | 32K | 64K | 128K |
| IQ4_XS | 8K(32KはVRAMが上限に張り付き) | 32K | 64K |
表の値は、0・8K・32K・64K・128Kと区切って試した中での最大です。
境界を細かく探したわけではないので、IQ4_XSのq4_0は「64Kでは全層GPUに載り、128Kは30分で終わらなかった」という結果として読んでください。
9月3日の計測前は、UD-Q3_K_XLに論文1本くらい(32K)の資料を渡すと、メモ(KVキャッシュ)が作業台に載りきらないと見ていました。
実際には作業台の最大使用量(VRAM峰)15.05GBに収まり、全層GPUのまま生成47.07 tok/sで回っています。
メモをq4_0で短く書いたUD-Q3_K_XLは、本1冊分くらい(128K)でも生成29.28 tok/sで回りました。
同じq4_0のIQ4_XSは128Kの計測が30分たっても終わらず、打ち切ったときのGPU電力は77Wでした。
64Kの深さでは、UD-Q3_K_XLのq8_0とq4_0がどちらも生成37.88 tok/sで並んでいます。
作業台からはみ出すと何が起きるか(VRAMの上限)
作業台に載りきらない分を机(メインメモリ)に置くと、使うたびに取りに行く往復が生まれ、書く速さが落ちます。
この記事で「はみ出し」と呼んでいるのは、VRAMが約15.9GBに達し、GPU電力が100W前後まで下がり、生成が20 tok/sを下回った状態です。
机の側へどれだけ回ったかは直接測っていないので、観測できた3つの値で判定しています。
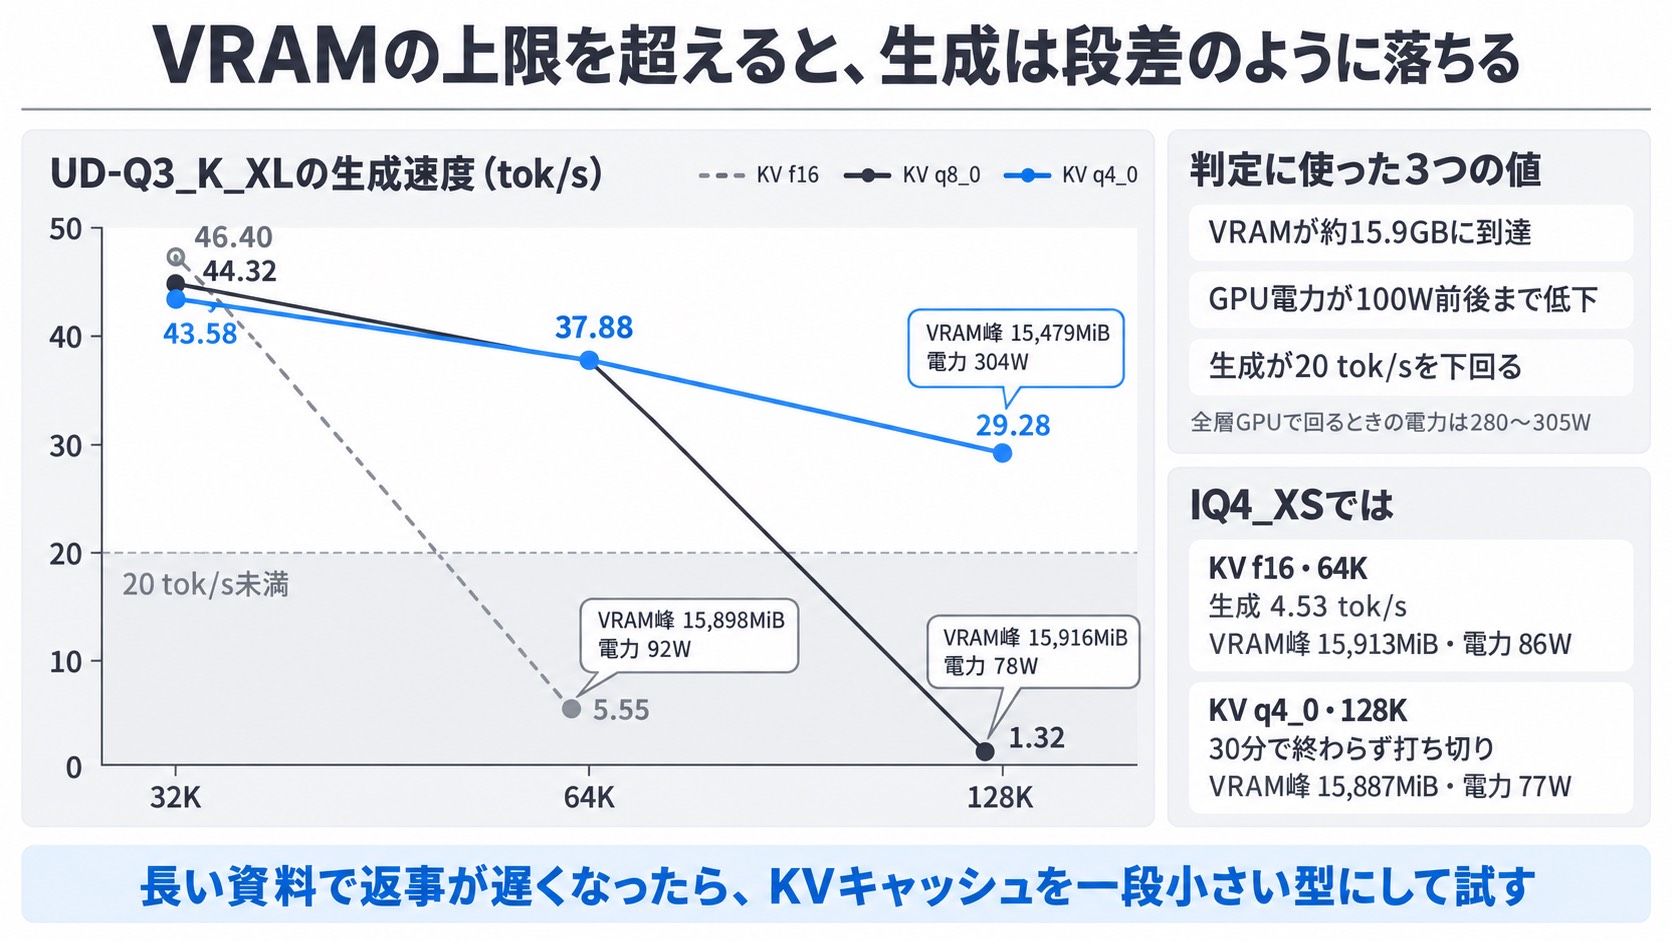
表の見方は、1行が縮小版・メモの型・資料の長さの組み合わせで、右端の「結果」が作業台に収まったか、はみ出したかを示します。
たとえば電力の列が100Wを切った行(92W・78W・86W・77W)は、作業台がいっぱいになり、書く速さが大きく落ちたか、計測が終わらなかった行です。
| 量子化 | KV | 深さ | 処理(tok/s) | 生成(tok/s) | VRAM峰 | 電力 最大 | 結果 |
| UD-Q3_K_XL | f16 | 64K | 34.60 | 5.55 | 15,898MiB | 92W | 上限に到達・低速 |
| UD-Q3_K_XL | q8_0 | 64K | 815.56 | 37.88 | 15,073MiB | 302W | 全層GPU |
| UD-Q3_K_XL | q8_0 | 128K | 13.37 | 1.32 | 15,916MiB | 78W | 上限に到達・低速 |
| UD-Q3_K_XL | q4_0 | 64K | 825.65 | 37.88 | 14,093MiB | 301W | 全層GPU |
| UD-Q3_K_XL | q4_0 | 128K | 531.29 | 29.28 | 15,479MiB | 304W | 全層GPU |
| IQ4_XS | f16 | 64K | 29.92 | 4.53 | 15,913MiB | 86W | 上限に到達・低速 |
| IQ4_XS | q8_0 | 64K | 77.84 | 37.48 | 15,918MiB | 301W | 上限に到達・処理だけ低速 |
| IQ4_XS | q4_0 | 64K | 834.16 | 36.80 | 15,140MiB | 302W | 全層GPU |
| IQ4_XS | q4_0 | 128K | — | — | 15,887MiB | 77W | 30分で終わらず打ち切り |
UD-Q3_K_XLのメモをf16のままにすると、32Kで46.40 tok/sだった書く速さが、64Kでは5.55 tok/sまで落ちました。
64KでのGPU電力は最大92Wで、全層GPUで回るときの280〜305Wの3分の1以下です。
q8_0の128Kも生成1.32 tok/sで、作業台からはみ出した長さで段差のように速度が下がります。
IQ4_XSのq8_0 64Kは、少し違う落ち方をしました。
答えを書く速さは37.48 tok/sを保ったまま、資料を読む処理だけが77.84 tok/sに下がっています。
同じ64Kでq4_0にしたIQ4_XSの処理834.16 tok/sと比べると、約10分の1です。
長い資料を貼ってから返事が始まるまでの待ち時間が急に延びたら、メモ(KVキャッシュ)を一段短い型にして同じ資料で試すと、差を確かめられます。
Q4_K_Mを使うなら、作業台に置く巻の数(層)を手で決める
- 66巻(層)すべてを作業台(GPU)に指定すると6.85 tok/s
- 64巻で33.00 tok/s、作業台にゆとりを残すなら62巻で26.56 tok/s
- 長い資料では、置き方をllama.cppに任せる自動配分でも32Kで6.80 tok/sまで落ちる
Qwen3.8-27Bの百科事典は、66巻に分かれていると考えてください。
1巻ずつ、作業台(GPU)に置くか、机(CPUとメインメモリ)に置くかを選べ、この巻にあたる計算の単位を層と呼びます。
作業台に入りきらない巻を机に回して動かすやり方をオフロードと呼びます。
llama.cppでは-ngl(GPUに置く層の数)でGPUとCPUへの配分を指定します。
9月3日、Q4_K_Mを全層GPU指定で走らせたときは、エラーで止まるものと思って結果を待ちました。
実際には終了コード0のまま、生成7.09 tok/sという数字が返ってきます。
手がかりになったのはGPU電力で、全層GPUに載ったほかのモデルが200〜300W台で回る中、Q4_K_Mだけが約100Wで止まっていました。
9月30日には、作業台に置く巻(層)を66から2巻ずつ減らして測りました。
64巻にした時点で、書く速さは6.85から33.00 tok/sへ跳ね上がります。
全部を作業台に押し込もうとするより、2巻だけ机(CPU)に回したほうが約5倍速かった計算です。
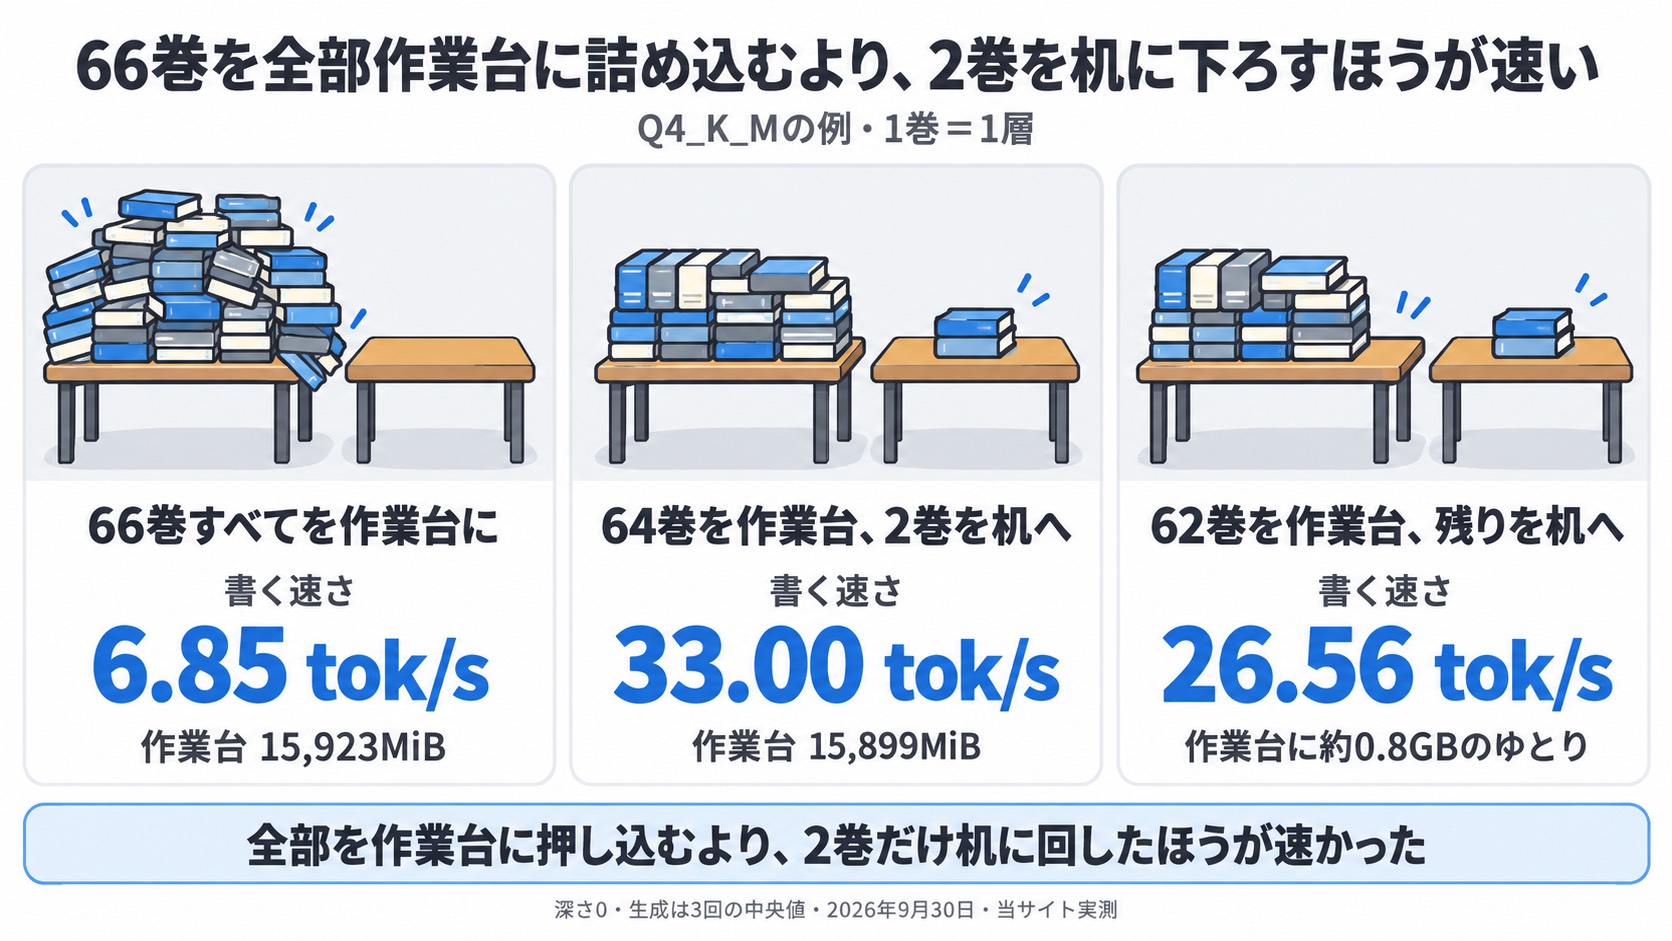
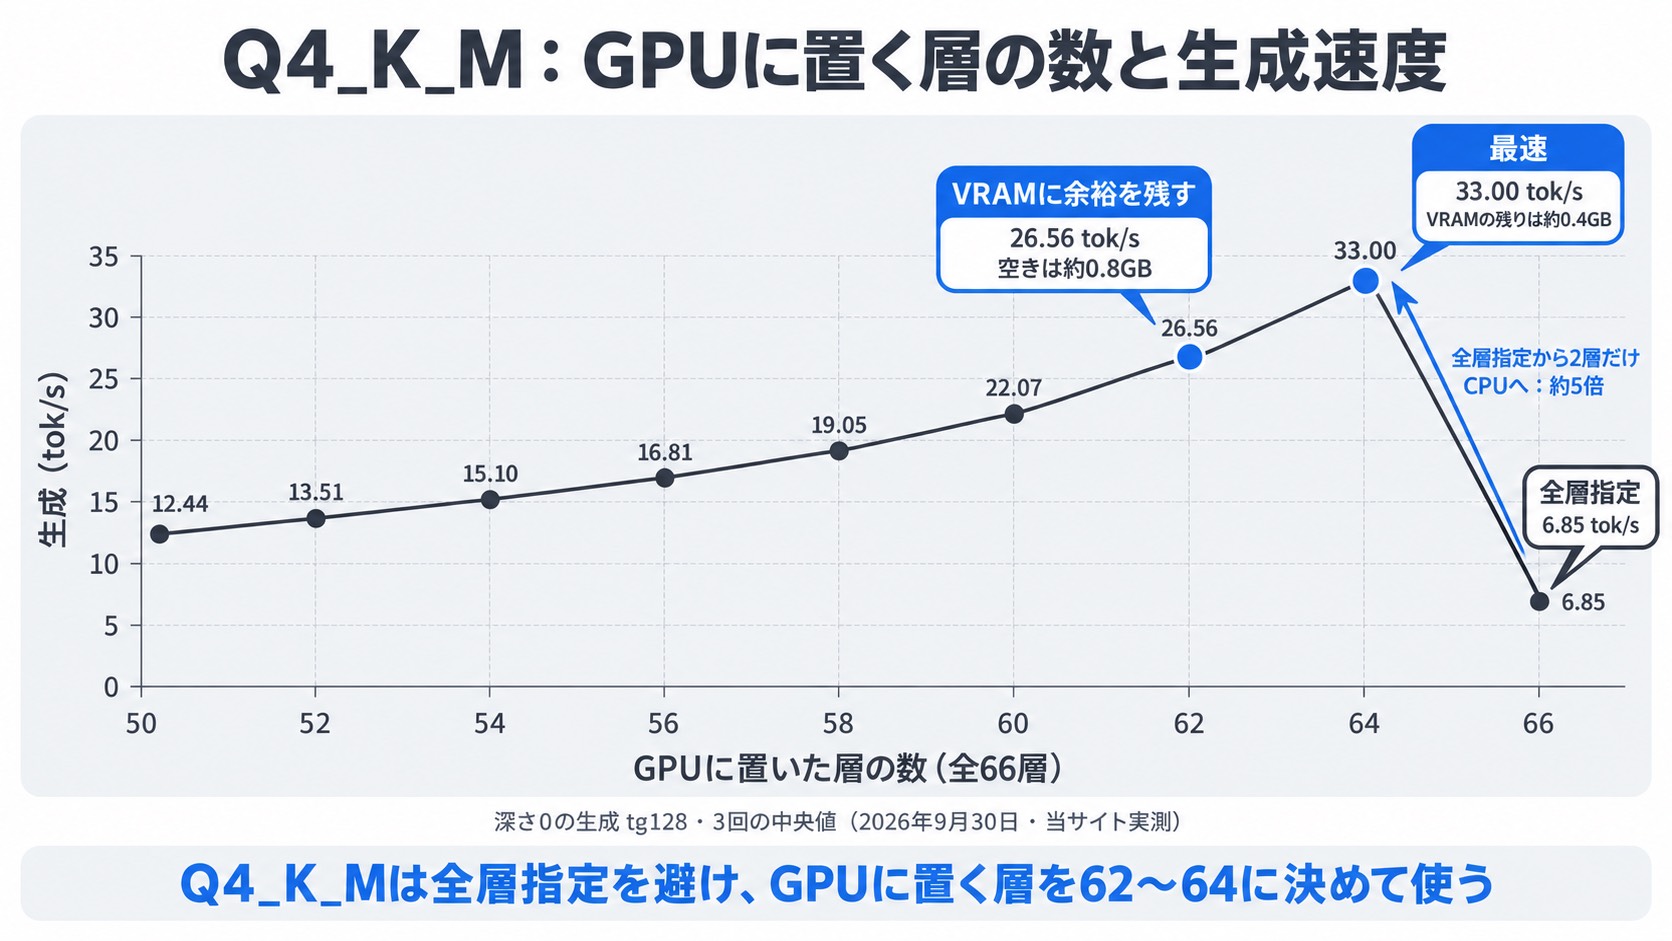
表の見方は、左の列が作業台に置いた巻(層)の数で、下の行へ行くほど机に回す巻が増えます。
たとえば66の行と64の行を比べると、2巻を机に回しただけで書く速さが6.85から33.00 tok/sに上がっています。
| GPUに置いた層(全66層) | 生成 tg128(tok/s) | VRAM峰 | 電力 最大 |
| 66(全層) | 6.85 | 15,923MiB | 103W |
| 64 | 33.00 | 15,899MiB | 243W |
| 62 | 26.56 | 15,465MiB | 229W |
| 60 | 22.07 | 14,997MiB | 214W |
| 58 | 19.05 | 14,525MiB | 208W |
| 56 | 16.81 | 14,111MiB | 190W |
| 54 | 15.10 | 13,665MiB | 156W |
| 52 | 13.51 | 13,217MiB | 146W |
| 50 | 12.44 | 12,809MiB | 137W |
最速は64巻ですが、作業台の最大使用量(VRAM峰)は15,899MiBで、残りは約0.4GBしかありません。
作業台にゆとりを残したいなら62巻の26.56 tok/s(VRAM峰15,465MiB)で、llama.cppが認識した16,275MiBまで約0.8GBの空きが残る計算です。
巻を減らすほど書く速さは下がり、60巻で22.07、56巻で16.81、50巻で12.44 tok/sでした。
9月3日には、巻の置き方をllama.cppに任せる自動配分(-fitt 1024)でも測り、書く速さは深さ0で21.86、8Kで16.01、32Kで6.80 tok/sでした。
全層指定のほうは8Kで5.92、32Kで4.34 tok/sです。
自動配分でも全層指定でも、Q4_K_Mに論文1本くらい(32K)の資料を渡すと、書く速さは1桁台でした。
答えの正しさ:3つの縮小版に同じ20課題を出した
- 形式や文字数の指定まで守れた数(厳密正答)はIQ4_XS 16、Q4_K_M 15、UD-Q3_K_XL 13
- 答えの中身が合っていた数(内容正解)は17・16・16で、差は1問
- 1課題1回の自作テストなので優劣は断定できない
縮小コピーで薄くした百科事典は、細かい字が少しつぶれることがあります。
縮小の度合いの違いが答えに出るかを確かめるため、学校の小テストのように、同じ20課題を3つの版に解かせました。
- LM Studio 0.4.23、context 8192、temperature 0、最大出力2048、1課題1回の自作課題
- UD-Q3_K_XLとQ4_K_Mは2026年9月8日(LM StudioのGPU自動割り当て)、IQ4_XSは10月1日(LM Studioのnative API)
- 課題・温度・contextは同じで、問い合わせの経路だけが違う
- 繰り返しはtemperature 0.7で3課題を各3回
表の見方は、行が課題の種類、列が縮小版と計測日です。
たとえば2行目の「厳密」は、答えの中身に加えて「◯文字で」のような指定まで守れた数で、IQ4_XSの16が最多でした。
| 課題 | UD-Q3_K_XL(9月8日) | Q4_K_M(9月8日) | IQ4_XS(10月1日) |
| 基本20課題 内容正解 | 16 | 16 | 17 |
| 基本20課題 厳密(形式・文字数を含む) | 13 | 15 | 16 |
| Thinkingを有効にした6課題 | 6/6 | 6/6 | 6/6 |
| 繰り返し(3課題×3回)厳密 | 3/9 | 4/9 | 4/9 |
内容正解は答えの中身が合っているか、厳密正答は中身に加えて形式や文字数の指定まで守れたかを数えたものです。
差が出たのは厳密正答のほうで、内容正解は17・16・16と1問差でした。
IQ4_XSの厳密不正解のうち対話課題の1問は、中身は正しく、囲みや説明を付けた形式違反による不正解です。
9月8日と10月1日では、LM Studioへ課題を送った方法が違います。
1課題1回の小さなテストなので、IQ4_XSのほうが賢いとまでは言えません。
言えるのは、今回の20課題でIQ4_XSがUD-Q3_K_XLより厳密正答で3問多かった、という結果までです。
長い資料を読ませてから聞く12問:5つの構成がすべて12/12
物知りの人に長い資料を渡してから質問する、読解テストのような形です。
完全に架空の日本語資料2本(6,003トークンと28,098トークン)を用意し、12問を出しました。
回答は実行前に固定し、temperature 0(毎回いちばん確からしい語を選ぶ設定)、Thinkingはoff、キーワードの一致で機械的に採点しています。
表の見方は、行が縮小版とメモの型の組み合わせ、列が正答数・資料を読み込む時間・書く速さです。
たとえば上の3行はUD-Q3_K_XLのメモの書き方だけを変えた結果で、どの書き方でも12/12でした。
| 構成 | 28,098トークンの正答 | 読み込み 中央値 | 生成 中央値(tok/s) |
| UD-Q3_K_XL KV f16 | 12/12 | 17.7秒 | 40.5 |
| UD-Q3_K_XL KV q8_0 | 12/12 | 18.2秒 | 39.5 |
| UD-Q3_K_XL KV q4_0 | 12/12 | 18.3秒 | 39.0 |
| IQ4_XS KV q8_0 | 12/12 | 17.9秒 | 37.8 |
| Q4_K_M 自動配分(参考) | 12/12 | 34.8秒 | 8.5 |
28,098トークンでは5つの構成すべてが12/12でした。
読み込みの中央値はUD-Q3_K_XLのf16が17.7秒で、Q4_K_Mの自動配分は34.8秒と約2倍かかっています。
6,003トークンではどの構成も12/12、読み込みは約3.5秒(Q4_K_Mは7.1秒)でした。
今回の12問では、資料を長くしても正答は下がりませんでした。
長い文章の理解力そのものを測ったテストではないので、結果は今回の12問に限ったものとして読んでください。
答える前に下書きさせるか(Thinkingの段階)
- 下書きなし(off)では6課題中3問、low以上は6/6
- 答え終わるまでの時間の中央値は、lowで約6.5〜6.6秒、mediumで約8.4〜8.8秒
- 既定のxhighはlowと同じくらいの時間で終わる
難しい質問を受けた物知りの人が、すぐには答えず、メモ用紙に考えを書き出してから答える場面を思い浮かべてください。
Thinkingは、答えを出す前にモデルが考える過程を文章で書き出す機能です。
Qwen3.8-27Bはoff・low・medium・xhighの段階を選べ、既定はxhighです(highはxhighと同じ扱い)。
6課題を各1回、temperature 0、context 16384で比べました。
表の見方は、列が下書きの段階で、offは下書きなし、low・medium・xhighは下書きありの設定です。
たとえばUD-Q3_K_XLの行では、offの3/6がlowで6/6に上がり、時間は約1.1〜1.2秒から約6.6秒に延びています。
| 量子化 | off | low | medium | xhigh(既定) |
| UD-Q3_K_XL 正答 | 3/6 | 6/6 | 6/6 | 6/6 |
| UD-Q3_K_XL 完了時間の中央値 | 約1.1〜1.2秒 | 約6.6秒 | 約8.4秒 | 約6.6〜6.8秒 |
| IQ4_XS 正答 | 3/6 | 6/6 | 6/6 | 6/6 |
| IQ4_XS 完了時間の中央値 | 約1.0〜1.3秒 | 約6.5〜6.6秒 | 約8.7〜8.8秒 | 約6.2〜6.3秒 |
offでは2つの縮小版とも3/6で、lowに上げた時点で6/6に届きました。
mediumとxhighも6/6で、lowより段階を上げても正答は増えていません。
出力上限を4096と16384で変えても正答は同じで、最終回答が出なかった試行もありませんでした。
待ち時間はmediumが約8.4〜8.8秒と一番長く、既定のxhighは約6.2〜6.8秒でlowと並びます。
offなら約1秒で返るので、すぐ返事がほしい雑談や定型の文面はoff、正答が要る課題はlowと使い分けられます。
次の数語を先に用意して速く書く(MTP)
- 短い決まった形の課題では、書く速さが2倍超
- 800字の説明文では約1.4倍
- 作業台(VRAM)の使用量は約0.9GB増える
言い慣れた挨拶なら、人は次の数語を頭の中で先に組み立てておき、合っていればまとめて口にできます。
MTP(Multi-Token Prediction)も同じ考え方で、モデル自身が次に来る数トークンを先に下書きし、まとめて正しいか確かめる仕組みです。
下書きが当たったぶんだけ一度に先へ進めるので、先読みが当たりやすい文章ほど速くなります。
llama-server b10752の–spec-type draft-mtpで、先読みの数nを1〜3に変えて測りました。
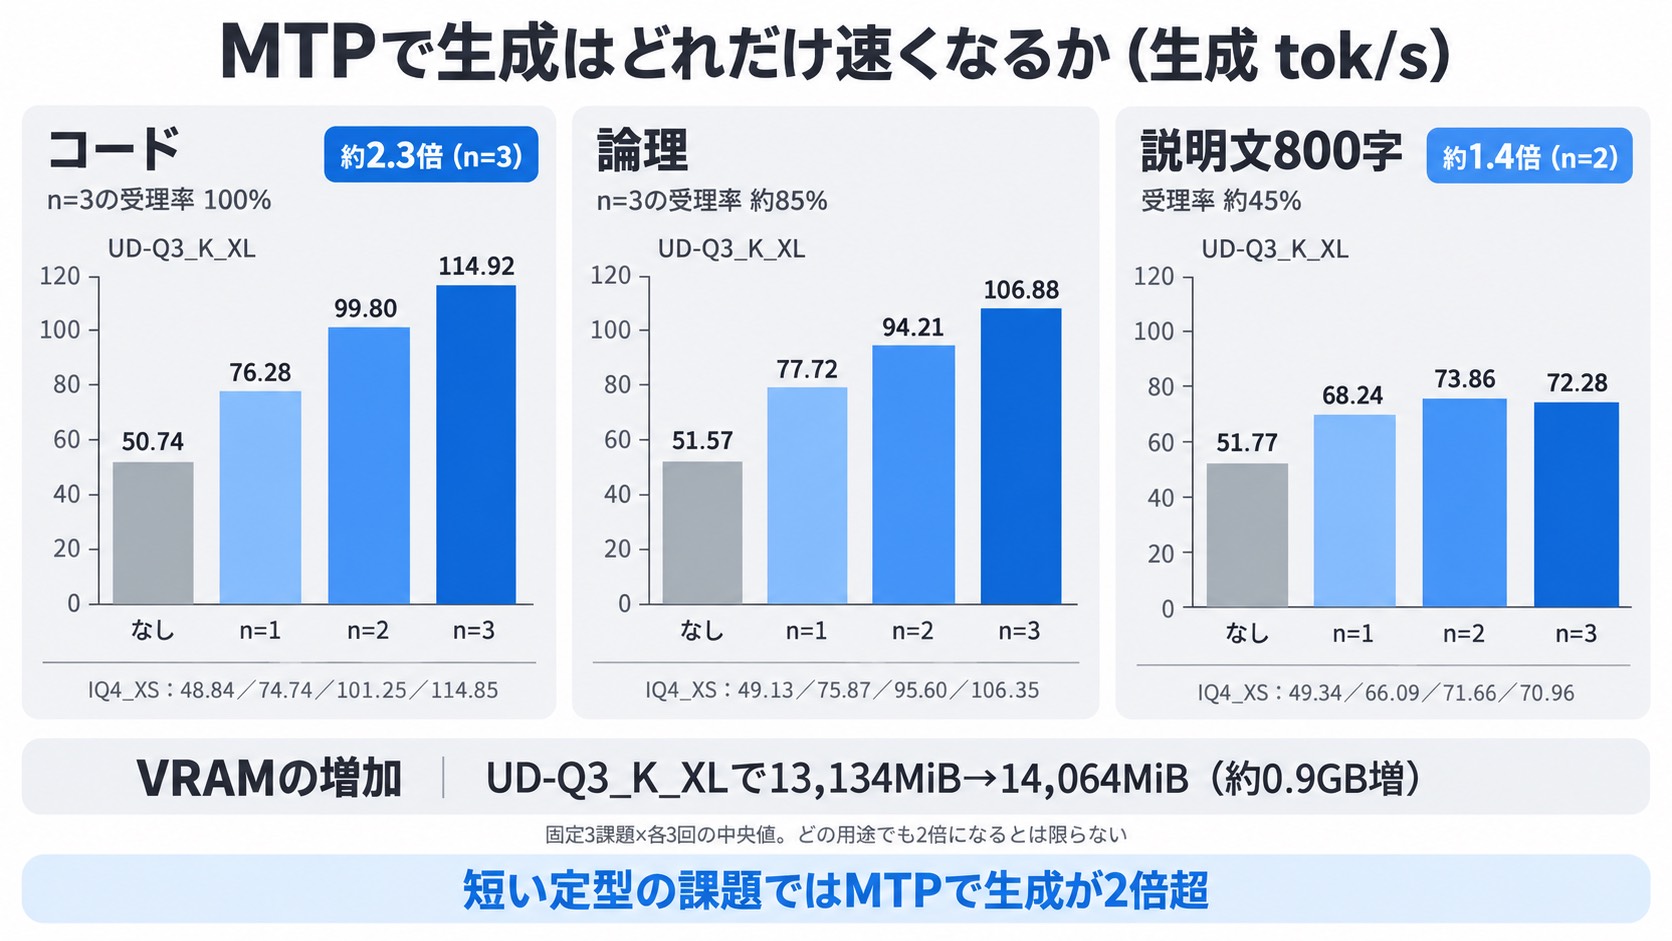
表の見方は、右の4列のうち「なし」がMTPを使わない書く速さ、n=1〜3が先に用意する語の数を増やしたときの書く速さ(tok/s)です。
たとえばIQ4_XSの論理の行は、なしの49.13からn=3の106.35へ上がっています。
| 量子化 | 課題 | なし | n=1 | n=2 | n=3 |
| UD-Q3_K_XL | コード(出力52トークン) | 50.74 | 76.28 | 99.80 | 114.92 |
| UD-Q3_K_XL | 論理(512トークン) | 51.57 | 77.72 | 94.21 | 106.88 |
| UD-Q3_K_XL | 説明文800字(約500トークン) | 51.77 | 68.24 | 73.86 | 72.28 |
| IQ4_XS | コード | 48.84 | 74.74 | 101.25 | 114.85 |
| IQ4_XS | 論理 | 49.13 | 75.87 | 95.60 | 106.35 |
| IQ4_XS | 説明文800字 | 49.34 | 66.09 | 71.66 | 70.96 |
コードの課題では、UD-Q3_K_XLが50.74→114.92 tok/s(n=3)と約2.3倍になりました。
n=3での先読みした下書きが採用された割合(受理率)はコードで100%、論理の課題で約85%と高く、下書きがほぼそのまま使われています。
800字の説明文では受理率が約45%に下がり、最良のn=2でも73.86 tok/s、約1.4倍でした。
書く形が決まったコードは次の語を当てやすく、言葉を自由に選ぶ説明文は当てにくいという違いが、受理率と速さの差に表れた形です。
作業台(VRAM)の使用量は、UD-Q3_K_XLで13,134→14,064MiBと約0.9GB増えます。
新しいllama.cppを入れ直す必要はなく、b10752のまま動きました。
固定3課題の結果なので、どの用途でも2倍になるとは限りません。
MTPと読んだ資料のメモ(KVキャッシュ)は作業台の場所を取り合いますが、128Kのような長い資料との併用は今回測っていません。
OllamaとLM StudioでMTPを使えるかも、今回は試していません。
どのアプリで動かすか:llama.cpp・LM Studio・Ollama
- UD-Q3_K_XLを全部作業台に載せれば(全層GPU)、3つとも約49〜52 tok/s
- LM Studioは置き方の初期設定(既定)のままだと13.77 tok/s
- GPUの割り当てを最大にすると49.45 tok/s
同じ百科事典でも、手伝う人によって最初の置き方の決まりが違います。
全部を作業台に広げる人もいれば、何巻かを最初から机に置く人もいて、アプリごとの置き方の初期設定(既定)で書く速さが変わりました。
同じGGUFファイルを3つのアプリで読み込み、context 8192、約500トークンの固定プロンプト、出力512、Thinking offで比べました。
既定の割り当ては3回の中央値、全層指定は1回の値で、生成速度は各アプリが報告した数字です。
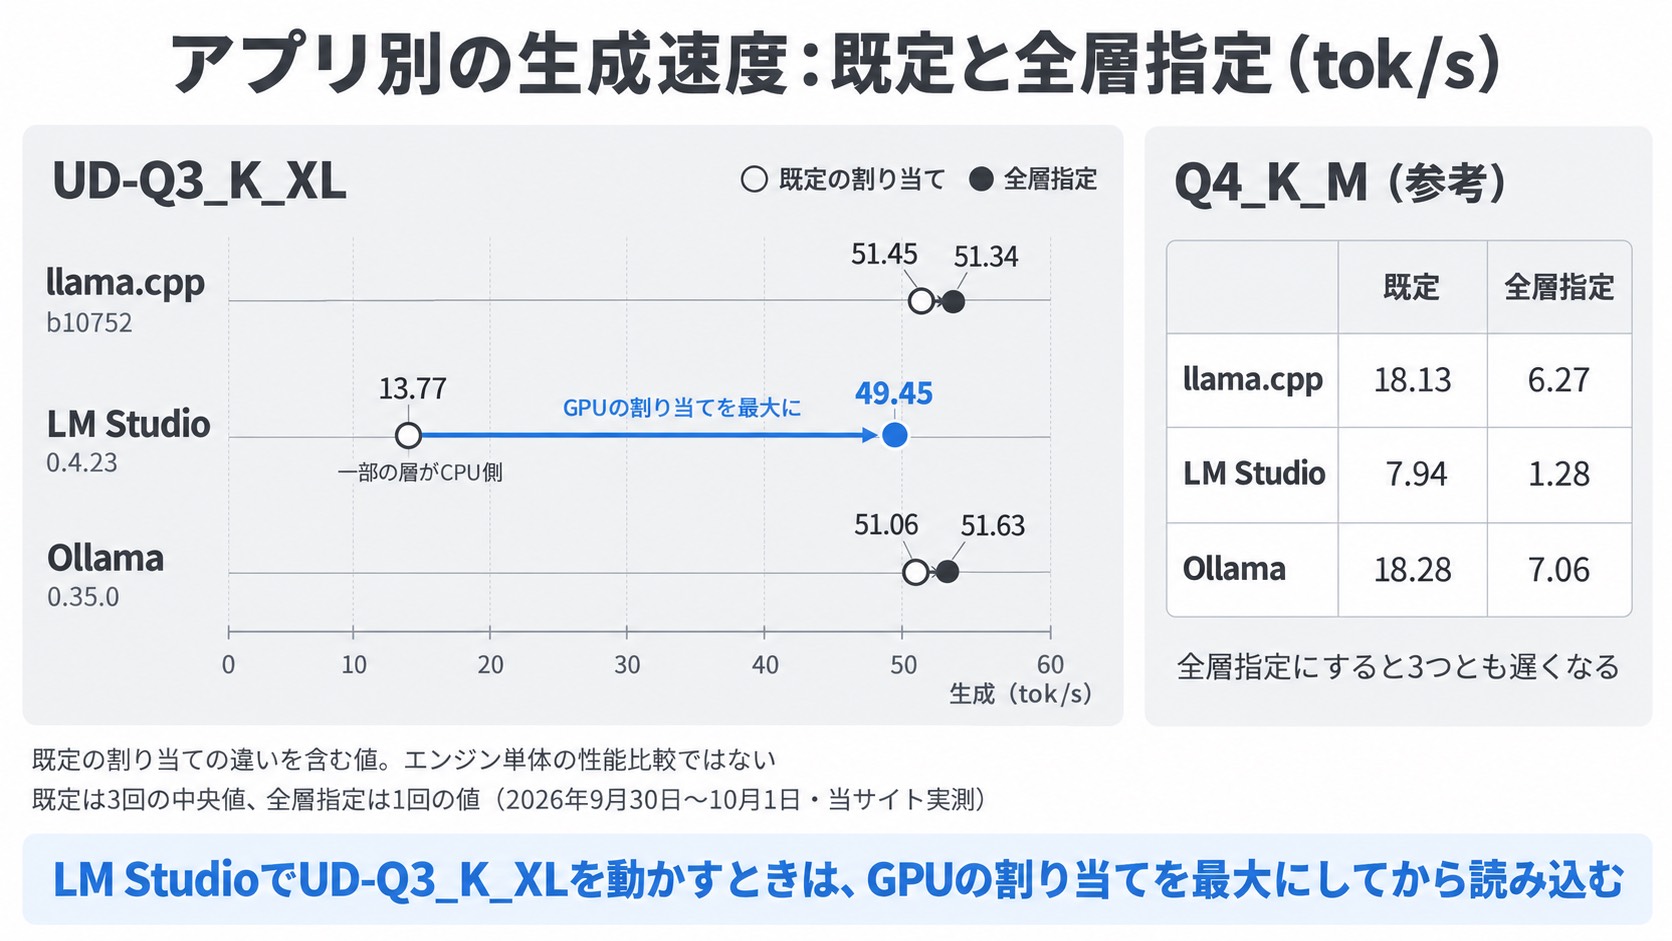
表の見方は、行がアプリ、列が縮小版と置き方の組み合わせで、「既定」はアプリの初期設定のまま、「全層指定」は全部の巻を作業台に置くよう指定した値です。
たとえばOllamaのQ4_K_M既定の欄にある「CPU 17%/GPU 83%」は、百科事典の一部を机(CPU側)に置いて動かしていた割合です。
| アプリ | UD-Q3_K_XL 既定 | UD-Q3_K_XL 全層指定 | Q4_K_M 既定 | Q4_K_M 全層指定 |
| llama.cpp b10752 | 51.45 | 51.34 | 18.13 | 6.27 |
| LM Studio 0.4.23 | 13.77(一部の層がCPU側) | 49.45 | 7.94 | 1.28 |
| Ollama 0.35.0 | 51.06 | 51.63 | 18.28(CPU 17%/GPU 83%) | 7.06 |
同じUD-Q3_K_XLのファイルでも、LM Studioを既定のまま使うと13.77 tok/sしか出ませんでした。
既定のままでは、一部の巻(層)が机(CPU側)に置かれていました。
GPUの割り当てを最大にして読み込み直すと49.45 tok/sになり、llama.cppの51.34、Ollamaの51.63 tok/sと並びます。
完了までの秒数も、llama.cpp 10.3秒、Ollama 10.5秒に対し、LM Studioの既定は37.5秒です。
初回の読み込みや割り当ての違いを含む値なので、アプリ内部の処理性能だけを比べた結果ではありません。
Q4_K_Mは既定の割り当てで、llama.cpp 18.13、Ollama 18.28、LM Studio 7.94 tok/sでした。
全層を指定すると3つとも1.28〜7.06 tok/sに下がるので、Q4_K_Mでは作業台に置く巻の数を手で決める節を参考に、層の数を決めてから使います。
使い方別のおすすめ設定
- 迷ったらUD-Q3_K_XL・Thinking lowから始める
- 長い資料を渡すなら、メモ(KVキャッシュ)をq8_0かq4_0で短く書く
- 短い決まった形の出力は、MTPで速くなる
料理のレシピに「迷ったらこの分量」と書いてあるように、使い方ごとの出発点を1つの表にまとめました。
表の見方は、左の列で自分の使い方を選び、同じ行を右へ読むと、縮小版・メモの書き方・下書き・先読み・アプリの組み合わせがわかります。
たとえば「長い資料を読ませる」の行なら、UD-Q3_K_XLを選び、64Kまではq8_0、128Kはq4_0でメモを短く書きます。
| 使い方 | 量子化 | KVキャッシュ | Thinking | MTP | アプリ |
| 短い会話(32Kまで) | UD-Q3_K_XLかIQ4_XS | f16(IQ4_XSで32Kならq8_0) | offかlow | 好みで | どれでも(LM StudioはGPUの割り当てを最大に) |
| 長い資料を読ませる | UD-Q3_K_XL | 64Kまでq8_0、128Kはq4_0 | off(12問はoffで12/12) | 長い文脈との併用は未計測 | llama.cpp(KVの型を指定して測定) |
| 品質を少しでも上げたい | IQ4_XS | 32Kまでq8_0 | low | 好みで | どれでも(LM StudioはGPUの割り当てを最大に) |
| とにかく速く | UD-Q3_K_XL | f16 | off | n=2〜3(短い定型の出力) | llama.cpp(llama-server) |
早見表は、項目ごとに測った結果を組み合わせたもので、1行の設定をまとめて通しで測ったわけではありません。
迷ったらUD-Q3_K_XL、メモ(KVキャッシュ)はf16のまま、Thinking lowで始めます。
資料が長くなったらメモをq8_0、q4_0と短く書く型に変えると、全層GPUのまま扱える資料の長さを広げられます。
このモデルを動かすPC
- 計測機はRTX 5070 Ti 16GB搭載のFRONTIER FRGKB860M/CG3
- CPUはCore Ultra 7 265F
- 価格と構成は公式ページで確認する
百科事典を広げる作業台の広さは、グラフィックボードのVRAMで決まります。
この記事の数値は、すべてFRONTIER FRGKB860M/CG3(RTX 5070 Ti 16GB・Core Ultra 7 265F)で測りました。
同じGPUのBTOを選べば、記事の表と同じ縮小版(量子化)と設定をそのまま試せます。
価格や構成は変わることがあるので、購入前に公式ページで確かめてください。
RTX 5070 Ti以外のGPUや、学習まで見据えたPCの組み方は親記事で扱っています。
同じQwen3.8の仲間でも、総125BのQwen3.8-Flash-Nextは百科事典がずっと分厚く、16GBの作業台(VRAM)に収まりません。
机(メモリ32GB)と本棚(SSD)も使ってRTX 5070 Ti機で動かした速さと限界は、Qwen3.8-Flash-NextをStrataで動かした実測にまとめています。
まとめ
Qwen3.8-27Bという分厚い百科事典は、16GBの作業台(VRAM)にも広げられました。
本命はUD-Q3_K_XLで、前置きなし(深さ0)で書く速さは52.50 tok/s、メモ(KVキャッシュ)をq4_0で短く書けば、本1冊分くらい(128K)の資料を渡しても全層GPUのまま29.28 tok/sで回りました。
短い会話が中心ならIQ4_XSも選べ、自作20課題の厳密正答はUD-Q3_K_XLより3問多い16/20でした。
Q4_K_Mは全層指定を避け、作業台に置く巻(層)を62〜64に決めて使います。
LM StudioでUD-Q3_K_XLを動かすときは、GPUの割り当てを最大にしてから読み込みます。
答える前の下書き(Thinking)はlowで6課題すべてに正答し、短い決まった形の出力にはMTPが効きます。
16GBの作業台の上で、百科事典とメモの置き場の配分を決めると、27Bのモデルを手元で無理なく回せます。
よくある質問
Qwen3.8-27BはVRAM 16GBで動く?
動きます。
UD-Q3_K_XL(12.24GiB)とIQ4_XS(13.27GiB)は、モデル全体をGPUのメモリ(VRAM)に載せたまま(全層GPU)動き、RTX 5070 Tiでの当サイト実測では前置きなし(深さ0)で書く速さが52.50 tok/sと50.07 tok/sでした。
Q4_K_M(15.66GiB)は全部の層をGPUに指定すると6.85 tok/sまで下がるため、GPUに置く層の数を手で決めて使います。
UD-Q3_K_XLとIQ4_XSはどちらがよい?
長い資料まで扱うならUD-Q3_K_XLです。
読んだ内容のメモ(KVキャッシュ)をq4_0にそろえると、UD-Q3_K_XLは128K(本1冊分くらい)、IQ4_XSは64Kの深さまで全層GPUのまま測れました。
速さはほぼ同じで、自作20課題で指定の形まで守れた数(厳密正答)はIQ4_XS 16、UD-Q3_K_XL 13だったので、短い会話が中心ならIQ4_XSも候補に入ります。
Q4_K_Mは16GBで使える?
GPUに置く層(モデルを区切った計算の単位)の数を手で決めれば使えます。
全66層をGPUに指定すると6.85 tok/sですが、64層で33.00 tok/s、VRAMにゆとりを残す62層で26.56 tok/sでした。
長い資料を渡すと自動配分でも32Kで6.80 tok/sまで落ちるため、日常的に使うならUD-Q3_K_XLが扱いやすい選択です。
何トークンの文章まで入れられる?
当サイトの実測では、UD-Q3_K_XLはKVキャッシュをq4_0にすると128K(131,072トークン・本1冊分くらい)の深さで、全層GPUのまま書く速さ29.28 tok/sでした。
IQ4_XSは同じq4_0で64Kまで全層GPUで測れています。
どちらも0・8K・32K・64K・128Kと区切って試した中での最大で、境界を細かく探した値ではありません。
KVキャッシュを量子化すると品質は落ちる?
今回のテストの範囲では落ちませんでした。
28,098トークンの架空の資料に12問を出したところ、読んだ内容のメモ(KVキャッシュ)の書き方をf16・q8_0・q4_0と変えても、UD-Q3_K_XLはどれも12/12でした。
12問の小さなテストなので、長い文章の理解力全般が同じだとまでは言えません。
OllamaとLM Studioで速さは変わる?
全部の層をGPUに載せれば同じ水準です。
UD-Q3_K_XLを全層指定で動かすと、llama.cpp 51.34、Ollama 51.63、LM Studio 49.45 tok/sでした。
LM Studioは置き方の初期設定(既定)のままだと一部の層がCPU側に置かれて13.77 tok/sだったので、GPUの割り当てを最大にしてから読み込みます。
計測条件
- 計測日:2026年9月3日(速度)・9月8日(回答品質)・9月29日〜10月1日(追加計測)
- 機材:FRONTIER FRGKB860M/CG3
- GPU:NVIDIA GeForce RTX 5070 Ti 16GB(nvidia-smi 16,303MiB/llama.cpp認識 16,275MiB)、ドライバ616.56(9月3日)・616.64(9月29日〜)
- CPU:Intel Core Ultra 7 265F
- ソフト:llama.cpp b10752(CUDA)、LM Studio 0.4.23、Ollama 0.35.0
- モデル:Qwen3.8-27BのGGUF。UD-Q3_K_XLとUD-IQ4_XS(記事ではIQ4_XSと表記)はunsloth配布、Q4_K_Mはlmstudio-community配布
- 速度:llama-bench pp512/tg128、Flash Attention有効、各3回の中央値(平均ではなく中央値を採用)
- VRAM峰と電力:計測中の最大値
- 各試行の生データと回答全文は当サイトで保存